
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |
- LV0
- 디자인 패턴
- Redis
- Lv.0
- Kafka
- 포트폴리오
- JPA
- 이것이 자바다
- 일정관리 프로젝트
- LV03
- LV01
- LV02
- docker
- CI/CD
- JMeter
- Join
- 연습문제
- 일정관리프로젝트
- LV.02
- SQL
- 알고리즘
- Java
- 데이터 베이스
- 프로그래머스
- nginx
- mysql
- CoffiesVol.02
- 코테
- spring boot
- AWS
- Today
- Total
코드 저장소.
일정관리 Mixed-Flow 테스트 본문
목차
1.작성 계기
2.테스트 시나리오 및 셋팅
3.테스트
4.결론
1.작성 계기
지금까지의 부하 테스트는 일정 생성 요청 하나를 쉬지 않고 반복하는 스트레스 테스트였습니다. "최대 몇 TPS까지 견디는가"를 확인하며 시스템의 한계점을 찾는 데 집중했습니다.
하지만 실제 사용자는 한 API만 연속으로 호출하지 않고, 한 계정으로 초당 수백 번씩 요청하지도 않습니다. 지금까지의 테스트는 한계점 측정이었을 뿐, 실제 트래픽과는 거리가 있었습니다.
그래서 실제 사용 패턴에 가까운 부하 테스트를 위해 여러 API 혼합(Mixed-Flow), 요청 사이 대기 시간(Think-time), 계정별 로그인 세션, 가정 기반 목표 TPS라는 네 가지 요소를 넣어 테스트를 새로 구성했습니다.
2.테스트 시나리오 및 셋팅
2-1.기존 방식 vs 변경된 Mixed-Flow 방식
| 구분 | 기존 방식 | Mixed-Flow 방식 |
| 행동 구성 | 단일 액션(생성)만 반복 | 생성 70% + 수정 30% 흐름 조합 |
| 계정 조건 | 계정 1개 고정 (userId=1) | 계정 30개 분산, 각자 로그인 세션 보유 |
| 간격 (Think-time) | 없음 | 1~5초 랜덤 대기 |
| 목표 설정 | 목표 없이 "한계점"만 측정 | 실측 기반 목표 TPS (150~170) 설정 후 검증 |
2-2. Thread Group 설정
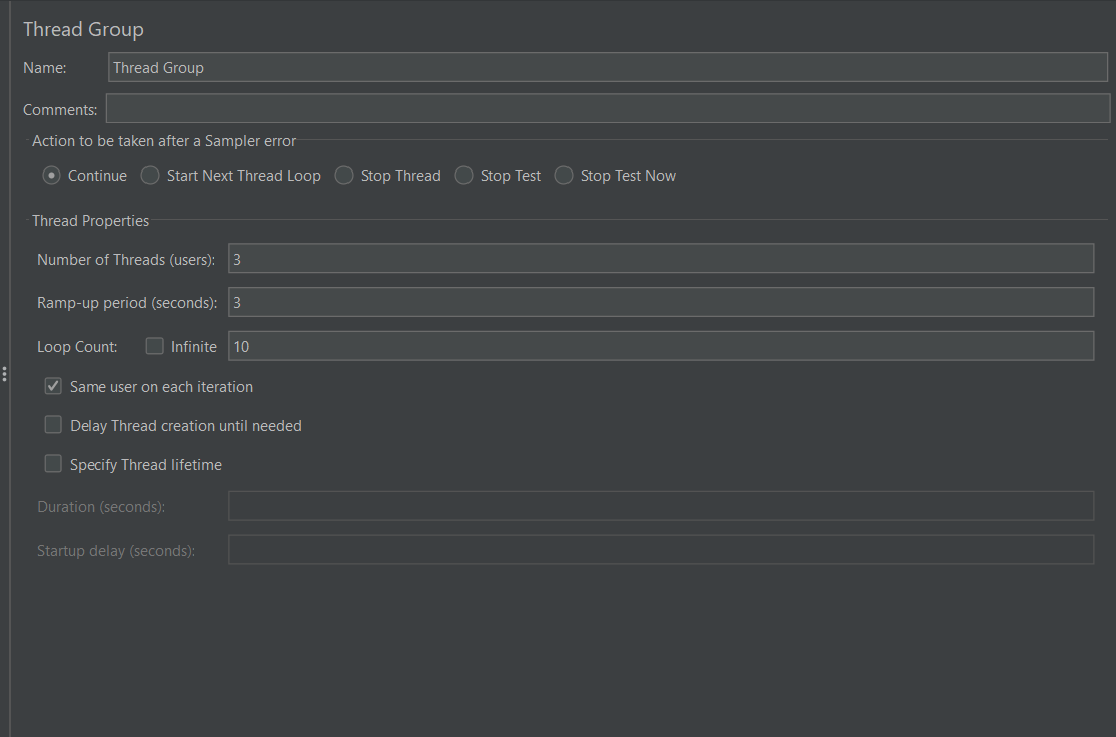
2-3.기본 Mixed-Flow (일정 생성 과 일정 수정 설정)
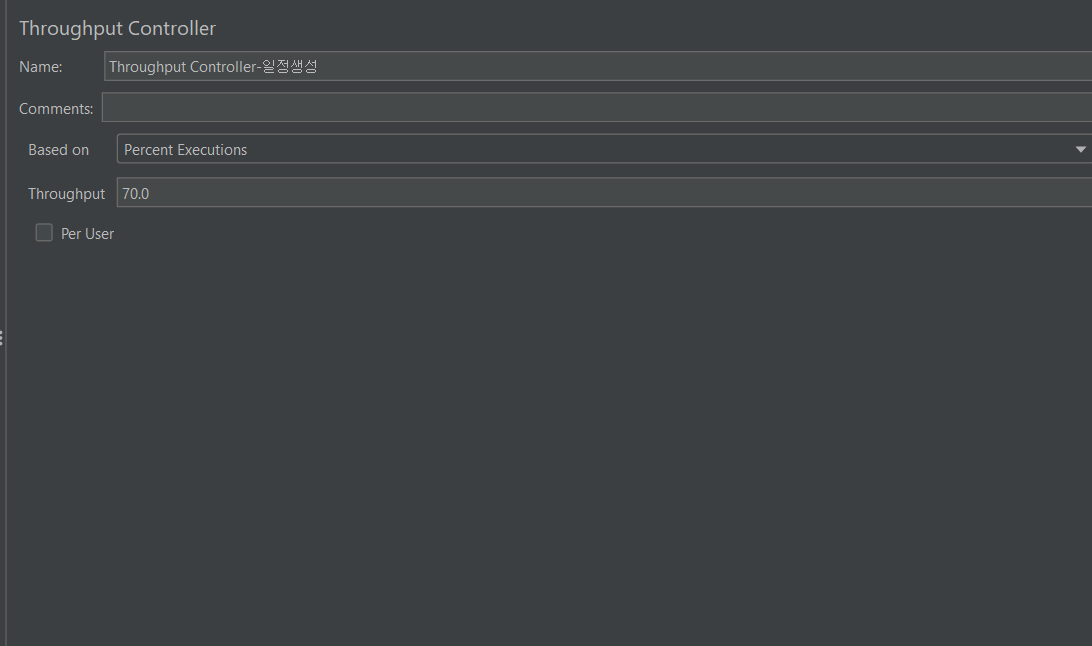
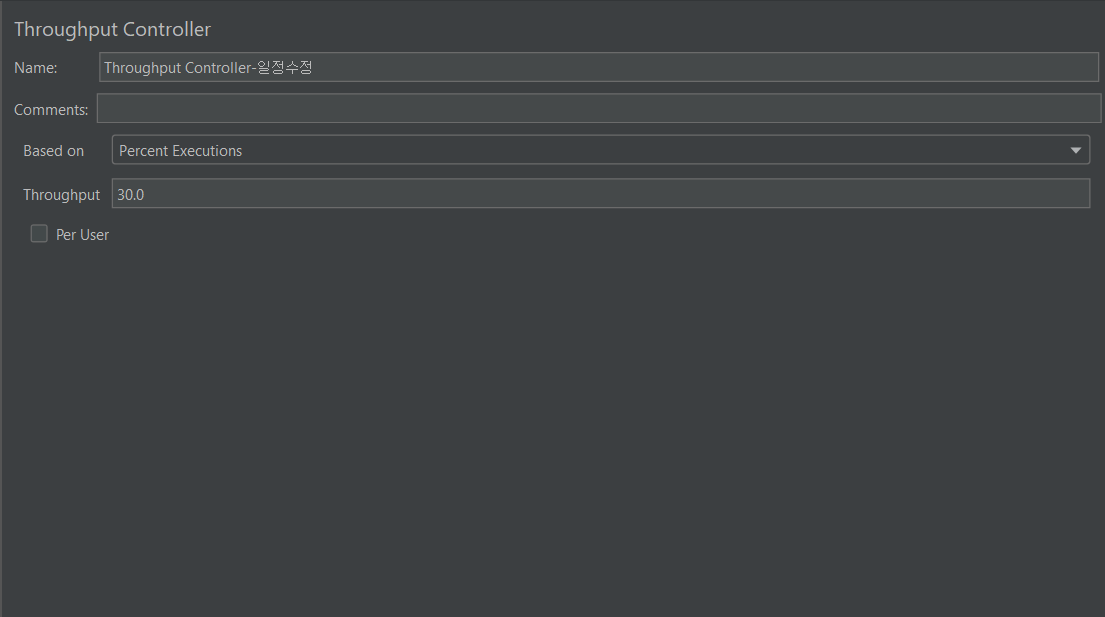
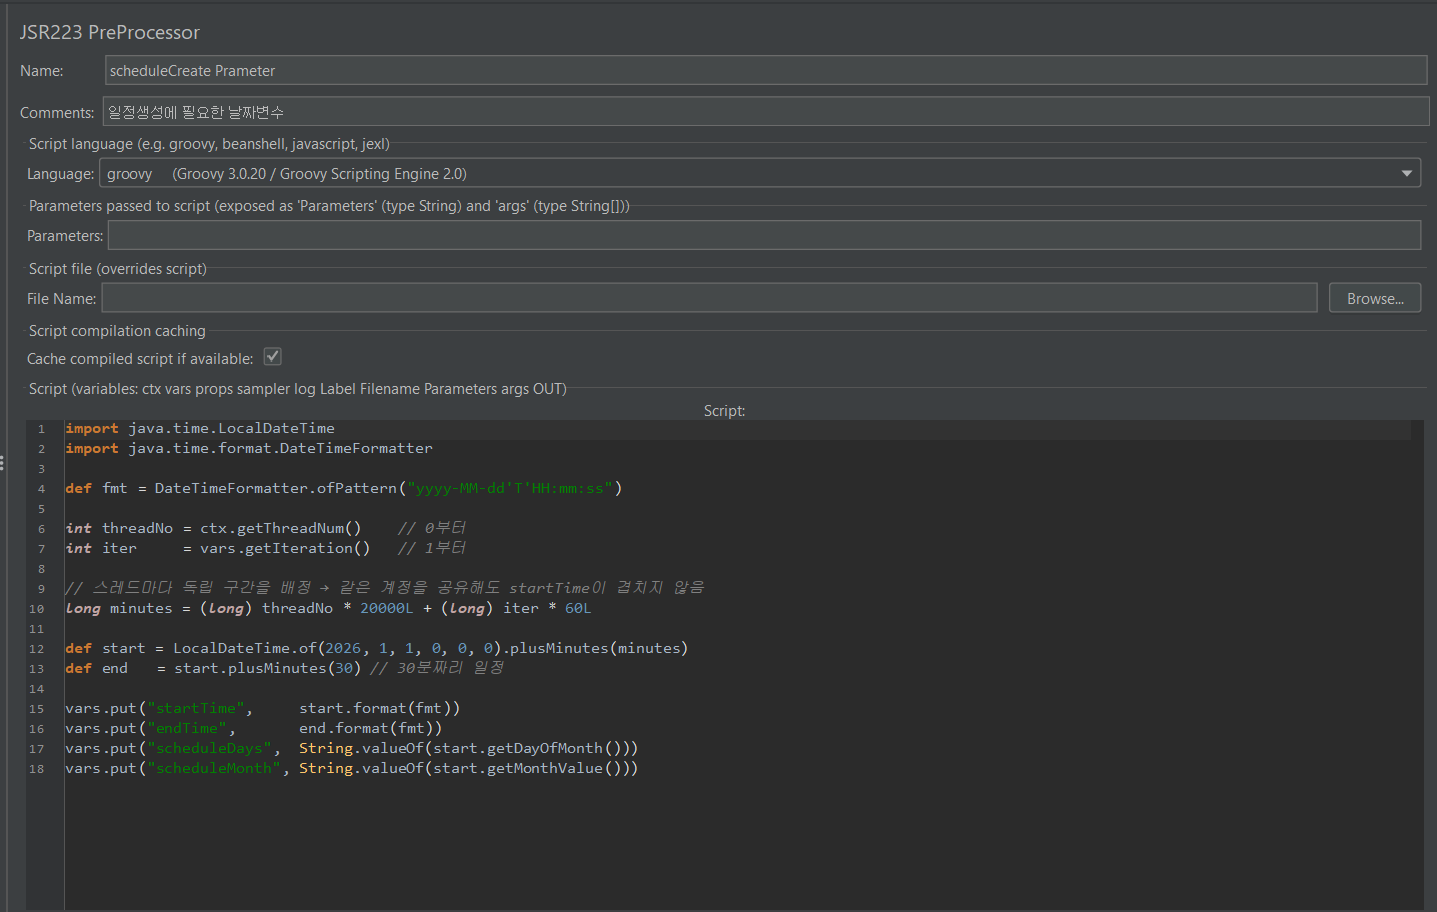
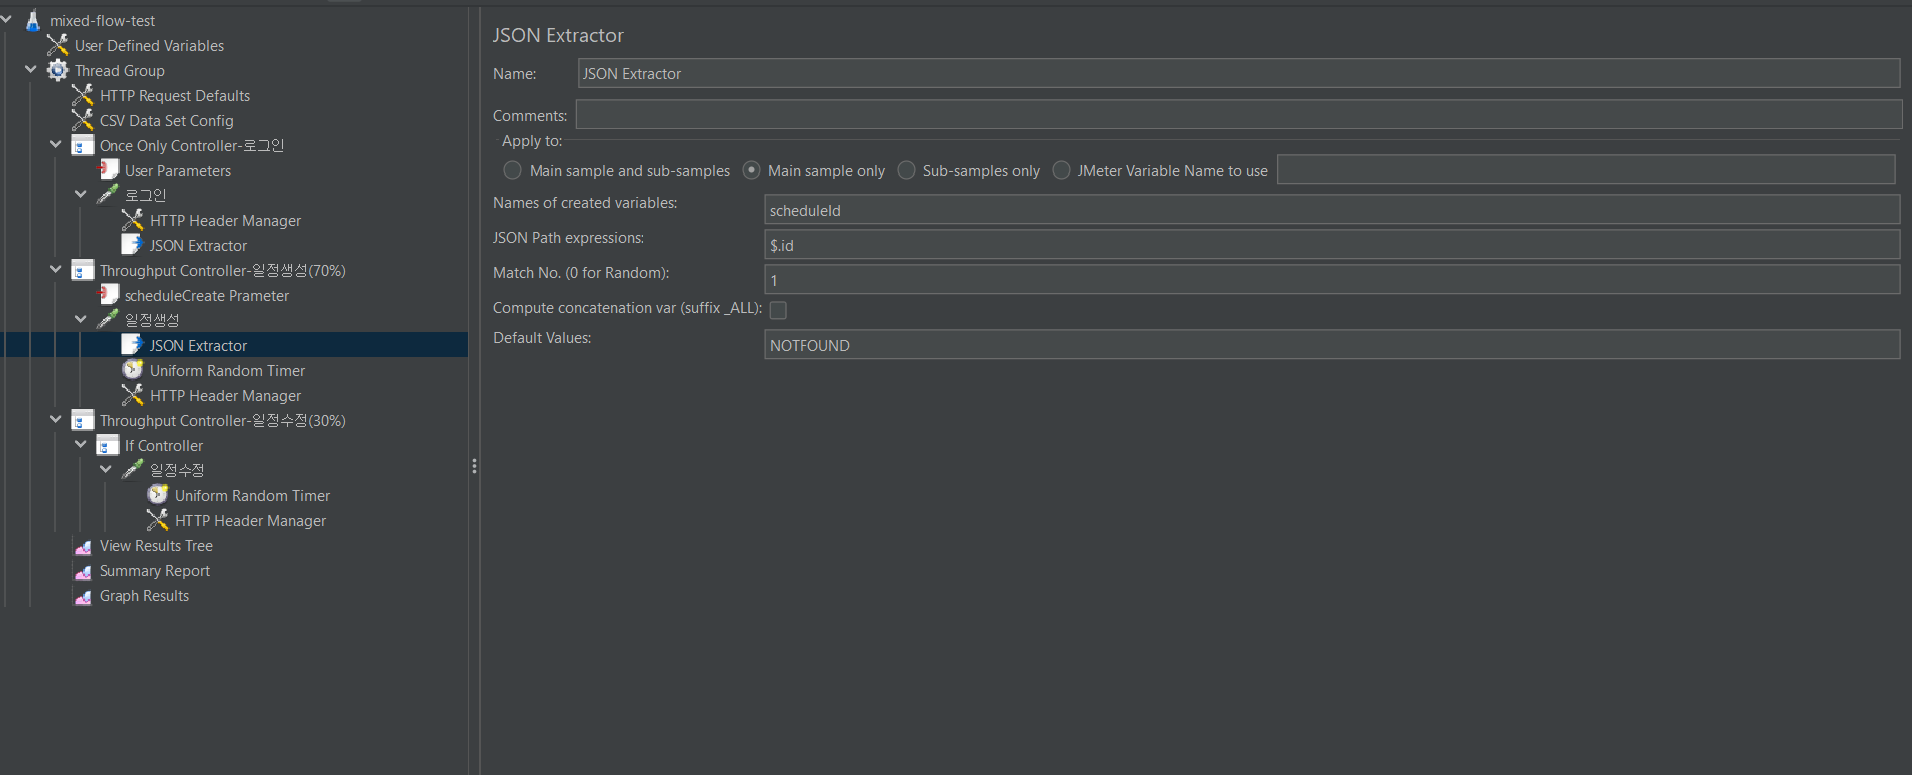
- JMeter의 Throughput Controller를 활용해 생성 70% : 수정 30% 비율 구성으로 제어
- 일정 생성 파라미터 동적 생성
- 스레드 번호(ctx.getThreadNum(), 0부터)와 반복 횟수(vars.getIteration(), 1부터)를 조합해 스레드마다 20000분(약 13.9일)씩 독립된 시간 구간을 배정
- 같은 스레드 안에서는 반복할 때마다 시작 시간을 60분씩 뒤로 밀고, 일정 길이는 30분으로 고정
- 90VU가 30개 계정을 나눠 쓰기 때문에 한 계정을 여러 스레드가 공유하게 되는데, 이 방식으로 같은 계정 안에서도 일정 시간이 서로 겹치지 않도록 구성 (스레드당 약 333회 반복까지 구간 중복 없음)
- 계산한 값은 startTime, endTime, scheduleDays, scheduleMonth 변수에 저장해 생성 요청 Body에서 ${startTime} 형태로 사용
- JSON Extractor - scheduleId 추출
- 일정 생성 응답에서 JSON Path $.id로 생성된 일정의 PK를 추출해 scheduleId 변수에 저장 (Apply to: Main sample only, Match No: 1)
- 추출에 실패하면 Default Value인 NOTFOUND가 들어가도록 설정 → 이후 If Controller에서 이 값으로 수정 요청 실행 여부를 판단
- 추출한 scheduleId는 일정 수정 요청에 그대로 재사용해 "생성 → 수정" 흐름을 구성
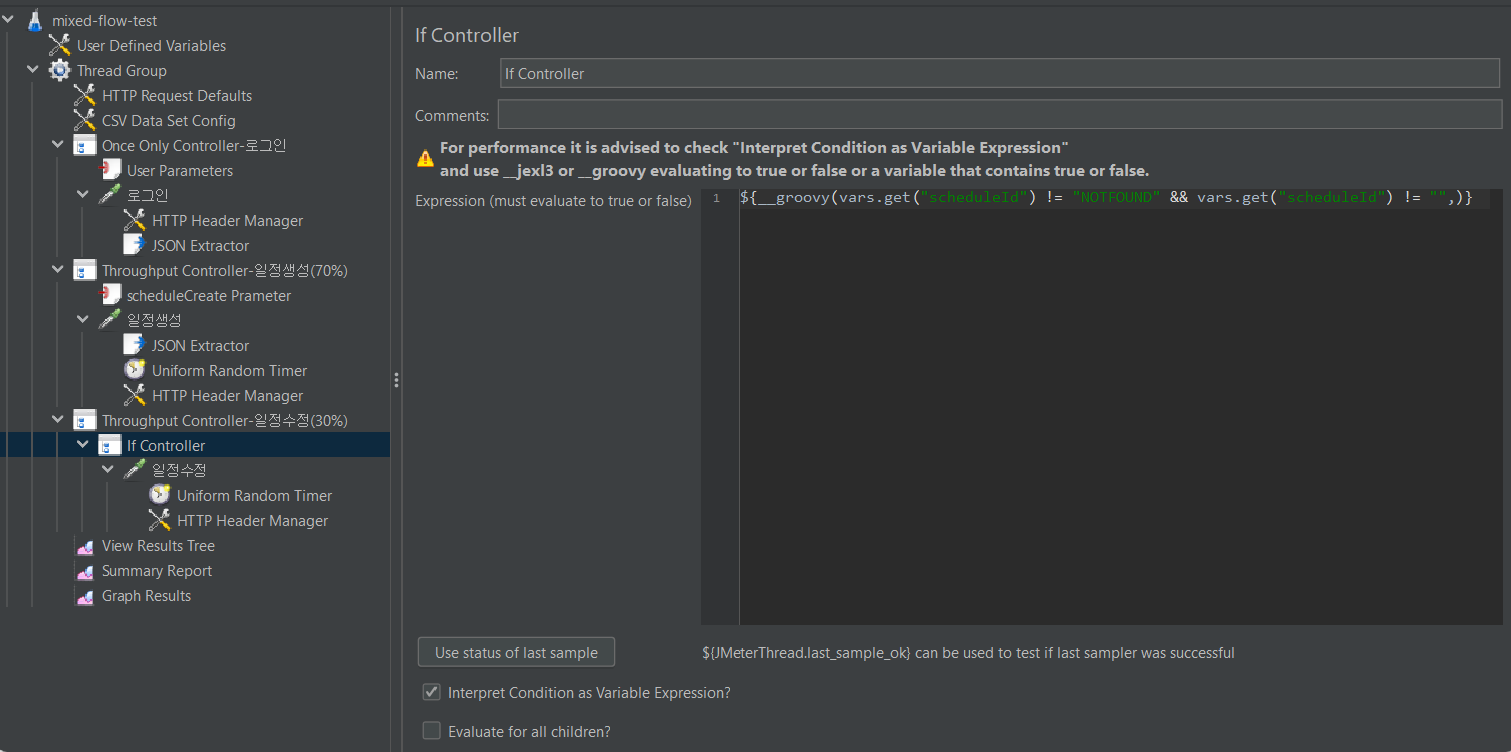
- If Controller - 수정 요청 안전장치
- 생성 요청이 실패했거나 scheduleId가 추출되지 않은 상태에서 수정 API가 호출되면 400/404 에러가 섞여 결과가 오염되므로 이를 사전에 차단
- 조건식: ${__groovy(vars.get("scheduleId") != "NOTFOUND" && vars.get("scheduleId") != "",)}
- "Interpret Condition as Variable Expression" 옵션을 체크하고 __groovy 함수가 true/false를 반환하도록 작성
- 결과적으로 정상적으로 생성된 PK가 있을 때만 수정 요청을 수행
2-4.계정별 로그인 세션 및 csv데이터 셋팅
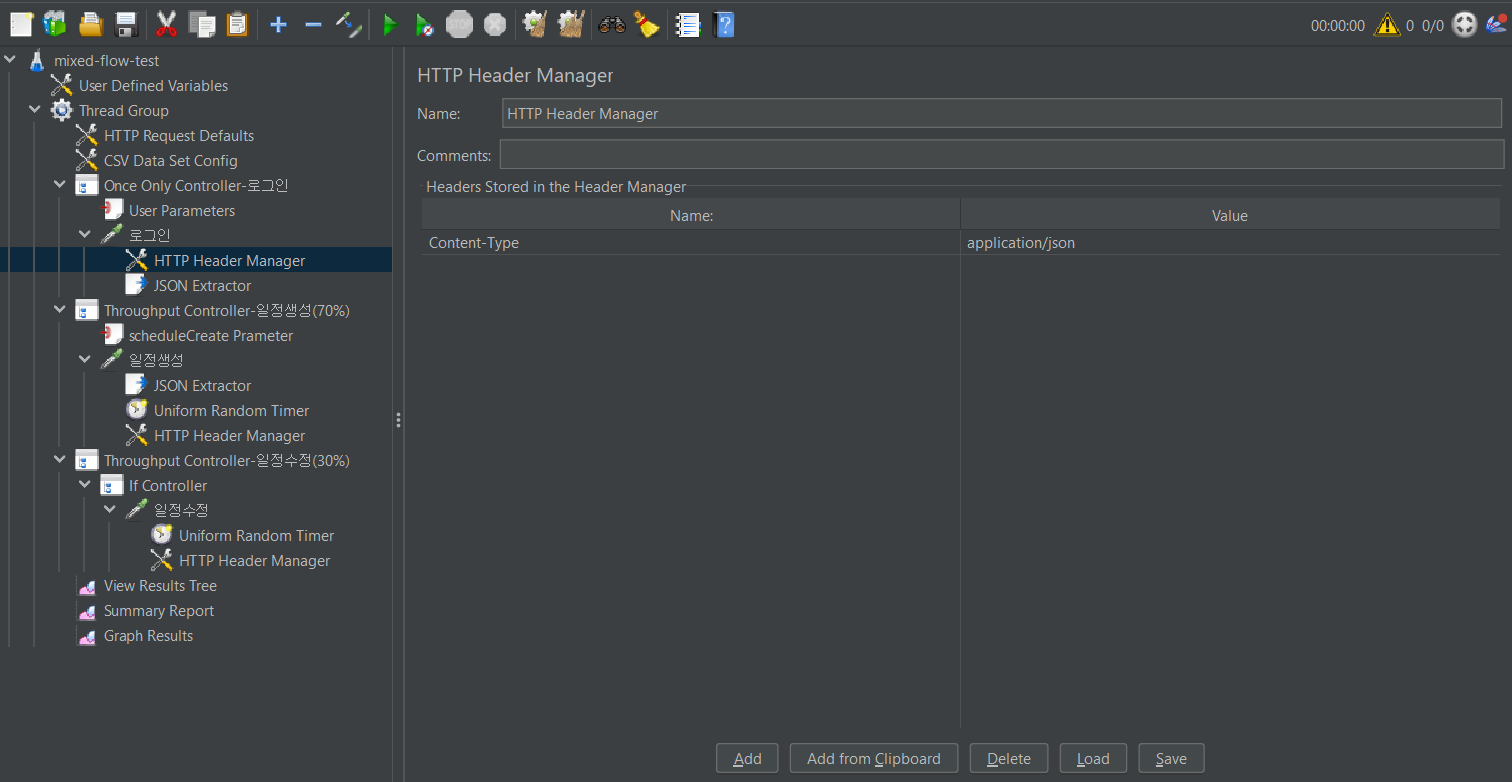
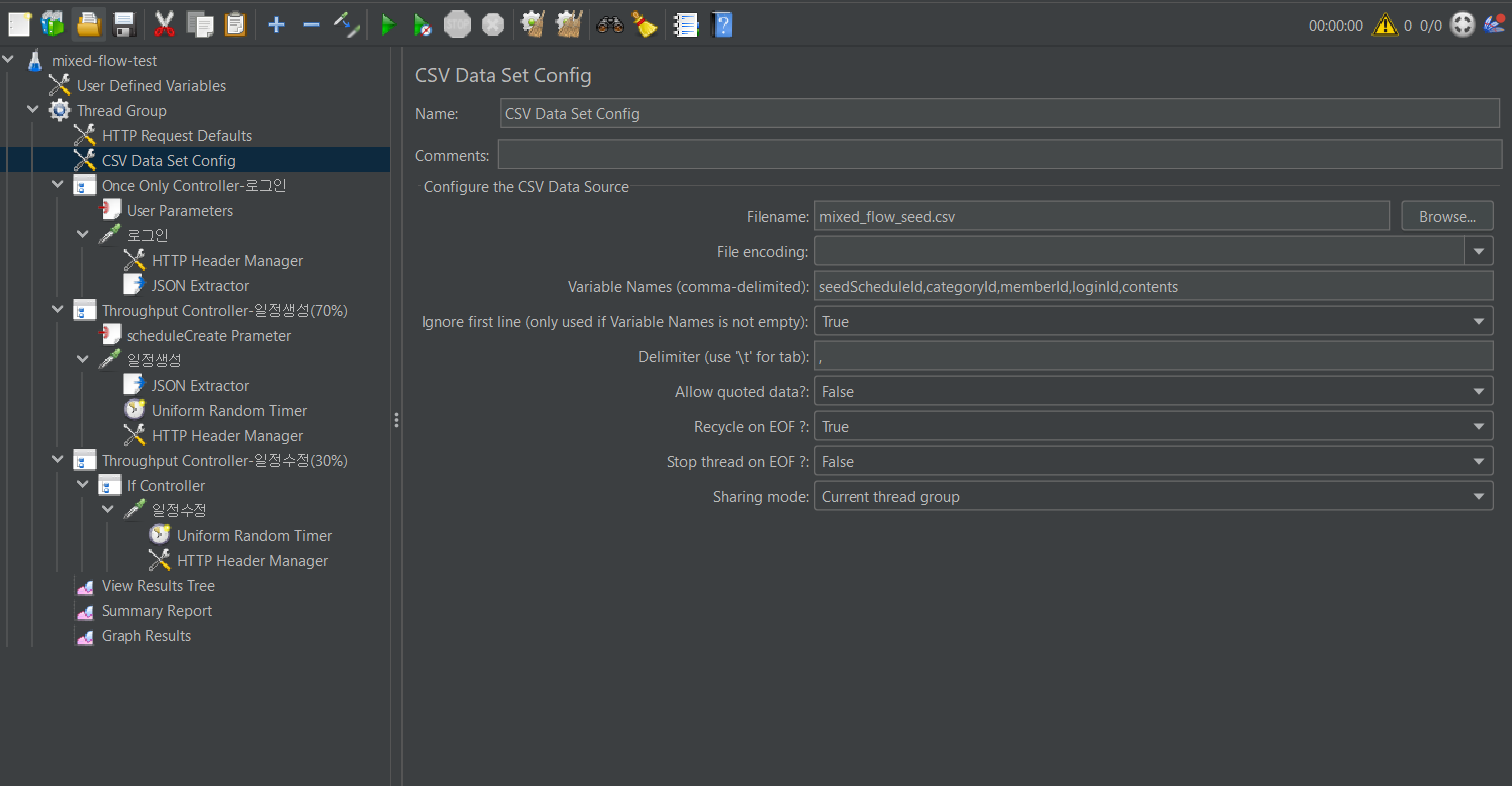
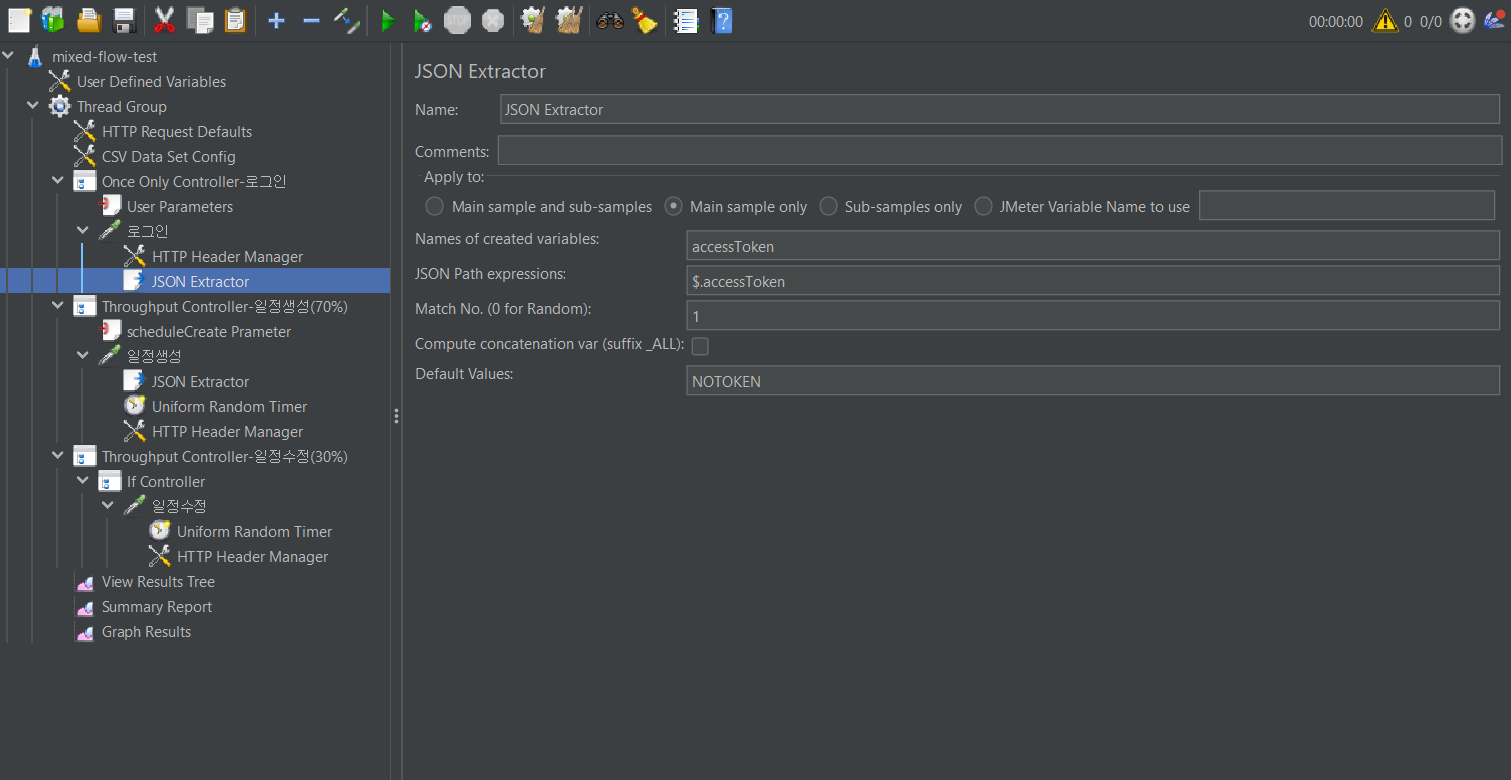
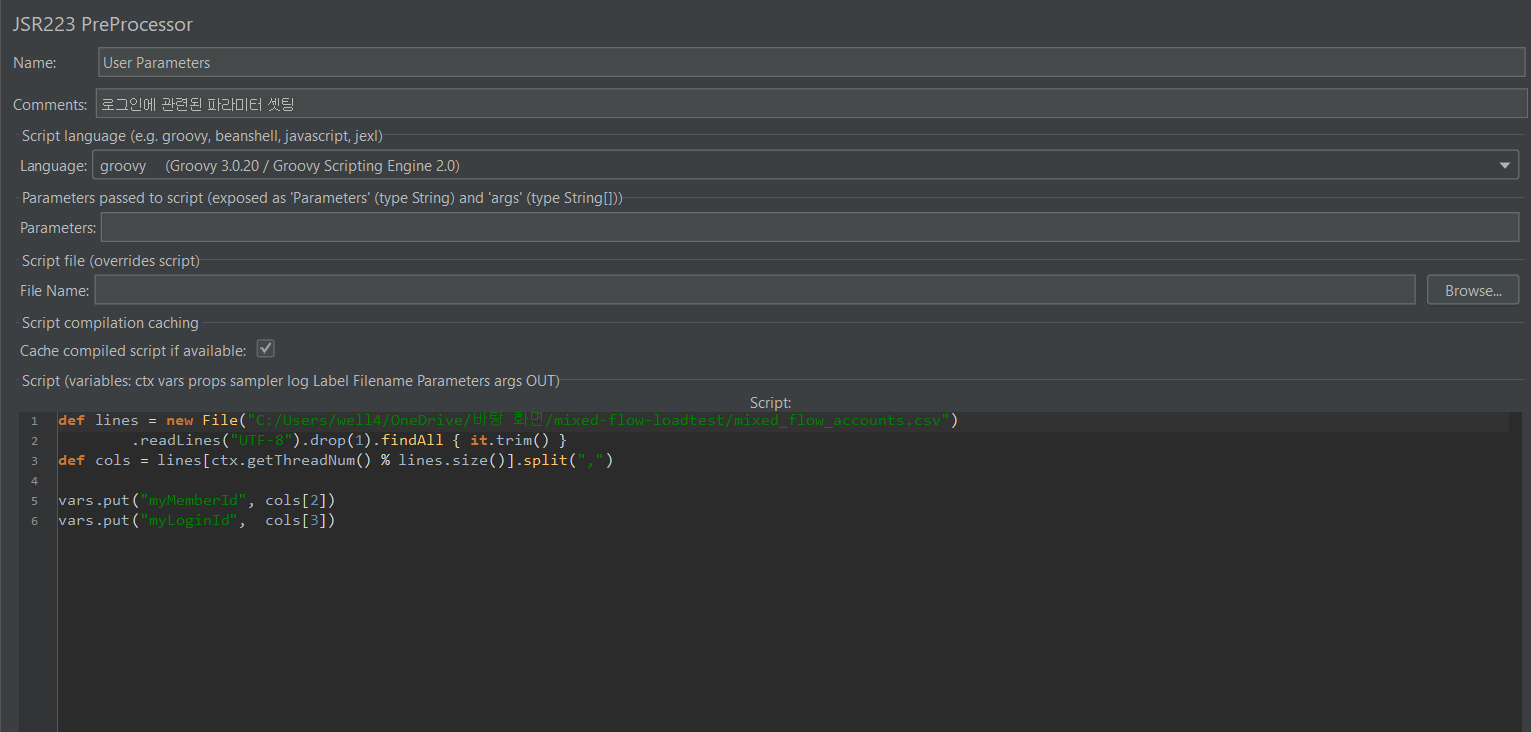
- 처음에는 CSV Data Set Config로 30개 계정을 스레드마다 다른 행으로 배정하고, 로그인 시점의 행을 myLoginId로 고정했습니다.그런데 스모크 테스트의 수정 결과 9건이 모두 loadtest001이었고, 1차 90VU 뒤 계정별 생성 건수를 조회해 보니 29개 계정에 1~6스레드로 쏠려 있었습니다.
- 계정당 1행인 mixed_flow_accounts.csv를 따로 만들고, 로그인 계정은 CSV 순서가 아니라 스레드 번호로 정했습니다. 공식 90VU 결과는 이 방식으로 실행했고, 계정 30개에 정확히 3스레드씩 붙었습니다(3-2 정합성 검증에서 계정별 210건으로 확인)
def lines = new File(".../mixed_flow_accounts.csv")
.readLines("UTF-8").drop(1).findAll { it.trim() }

def cols = lines[ctx.getThreadNum() % lines.size()].split(",")

vars.put("myMemberId", cols[2])
vars.put("myLoginId", cols[3])- 원인은 CSV Data Set이 로그인할 때만이 아니라 반복할 때마다 다음 행을 읽는다는 점이었습니다. 램프업 동안 먼저 시작한 스레드들이 계속 행을 소비하면서, 나중에 시작한 스레드가 첫 반복에 받는 행(로그인 계정)이 순서대로 나뉘지 않았습니다.
2-5.Think-time 적용
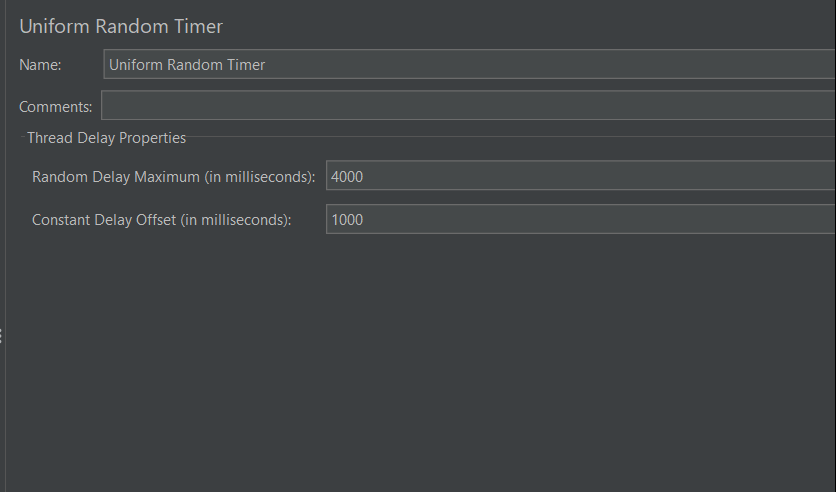
- Uniform Random Timer를 적용해 샘플러 사이에 1000 ~ 5000ms 대기시간 부여
- 순간 동시성을 현실적인 유저 패턴 수준으로 낮춤
2-6.목표 TPS 산정 및 검증
- 요구치
- DAU 10,000명이 하루 13회 요청한다고 가정하면 평균 약 1.5 req/s, 하루 트래픽의 10%가 1시간에 몰리는 피크는 약 3.6 req/s입니다. 서비스가 실제로 감당해야 하는 양이며, DAU와 요청 수는 가정값입니다.
- 여유 검증 구간
- 이전 스트레스 테스트의 한계 248.9 TPS의 60~70%인 150~170 TPS입니다. 필요한 양이 아니라, 이 구간까지 부하를 올렸을 때 어디가 먼저 한계에 닿는지 확인하려는 기준입니다.
Think-time이 있으면 처리량은 VU 수로 정해집니다. 1단계 90VU는 요구치 대비 여유를, 2단계 490VU는 여유 검증 구간을 확인합니다.
2-7. 처리량 상한 산정과 검증 지표
Think-time을 도입하는 순간, 목표를 "TPS 숫자"로 잡을 수 없게 됩니다. 이전 테스트에서 기록한 248.9 TPS는 Think-time이 0인 환경, 즉 가상 유저가 응답을 받자마자 다음 요청을 쏘는 조건에서 나온 값입니다. 여기에 1~5초 대기를 넣으면 처리량이 계수만큼 줄어드는 게 아니라, 계산식 자체가 바뀝니다.
Little's Law로 본 구조적 상한
X = N / R

N = 90 (동시 가상 유저)
R = Think-time 평균 3초 + 응답시간 0.277초 ≈ 3.28초

X = 90 / 3.28 ≈ 27 req/s
90명이 각자 3초 넘게 쉬고 있으면, 서버가 아무리 빨라도 초당 27건 이상은 들어올 수가 없습니다. 이 값은 서버 성능이 아니라 부하 모델이 결정합니다. 따라서 이번 테스트에서 27 req/s 근처가 나온다면 그건 한계에 도달한 게 아니라 설계대로 동작한 것입니다.
참고로 150 req/s를 재현하려면 동일 Think-time에서 약 490VU가 필요합니다(150 × 3.28).
응답시간 0.277초는 이전 단일 API 회귀 테스트 기준값이며, 혼합 흐름에서는 달라질 수 있습니다. 실제 R은 테스트 후 측정값으로 다시 계산합니다.
비즈니스 기준과의 거리
가정          DAU 10,000명 × 일 13회 요청
평균          약 1.5 req/s
피크          약 3.6 req/s   (하루 트래픽 10%가 1시간에 집중될 경우)
이번 부하 모델의 상한 27 req/s는 가정한 피크의 약 7.5배입니다. 즉 이 테스트는 비즈니스 요구 대비 충분히 보수적인 조건이며, 이 구간에서 문제가 없다는 것은 실제 트래픽 수준에서는 여유가 있다는 뜻입니다.
2-8.테스트 시나리오
본격적인 부하 주입에 앞서서 시나리오 검증부터 사후 데이터 정합성 확인까지 아래와 같이 진행을 할 것입니다.
| 단계 | 주요 작업 내용 |
| 0.초기화 | 이전 회차 데이터 제거 (schedules, outbox). 누적 데이터가 남아 있으면 (member_id, start_time) 유니크 제약에 걸려 생성 요청이 충돌하므로, 매 회차 동일 조건에서 시작하도록 정리 |
| 1. 소규모 검증 | 3vu 환경에서 로그인 세션, 토큰 추출, 생성에서 수정 연쇄 호출 정상 동작 확인( Think-time(1~5초) 및 Ramp-up 적용하여 순간 동시성 완화) |
| 2. 테스트 실행 | 90VU, Loop Count 100으로 수행합니다. 2-7에서 계산한 대로 처리량 상한은 부하 모델이 정하므로, TPS 최대치가 아니라 에러율, 응답시간 분포(p95,p99), 시간 충돌(409) 여부, 데이터 정합성을 확인 |
| 3.결과 및 모니터링 분석 | JMeter Aggregate Report, Grafana (CPU/Mem/TPS), Tempo(트레이싱) 연동 분석 |
| 4.사후 정합성 검증 | 테스트 종료 후 DB SQL 조회 및 로그 확인을 통해 데이터 누락/오류 여부 검증 |
| 5. 여유 검증 (490VU) | 스레드 490, 램프업 120초. 목표 구간 150~170 TPS에서 어디가 먼저 한계에 닿는지 확인. 부하 발생기 PC의 CPU,메모리도 함께 기록 |
| 6. 개선 후 재측정 | 발견한 병목을 고친 뒤 같은 조건으로 다시 측정해 전후 비교 |
3.테스트
3-1. 소규모 3VU 검증
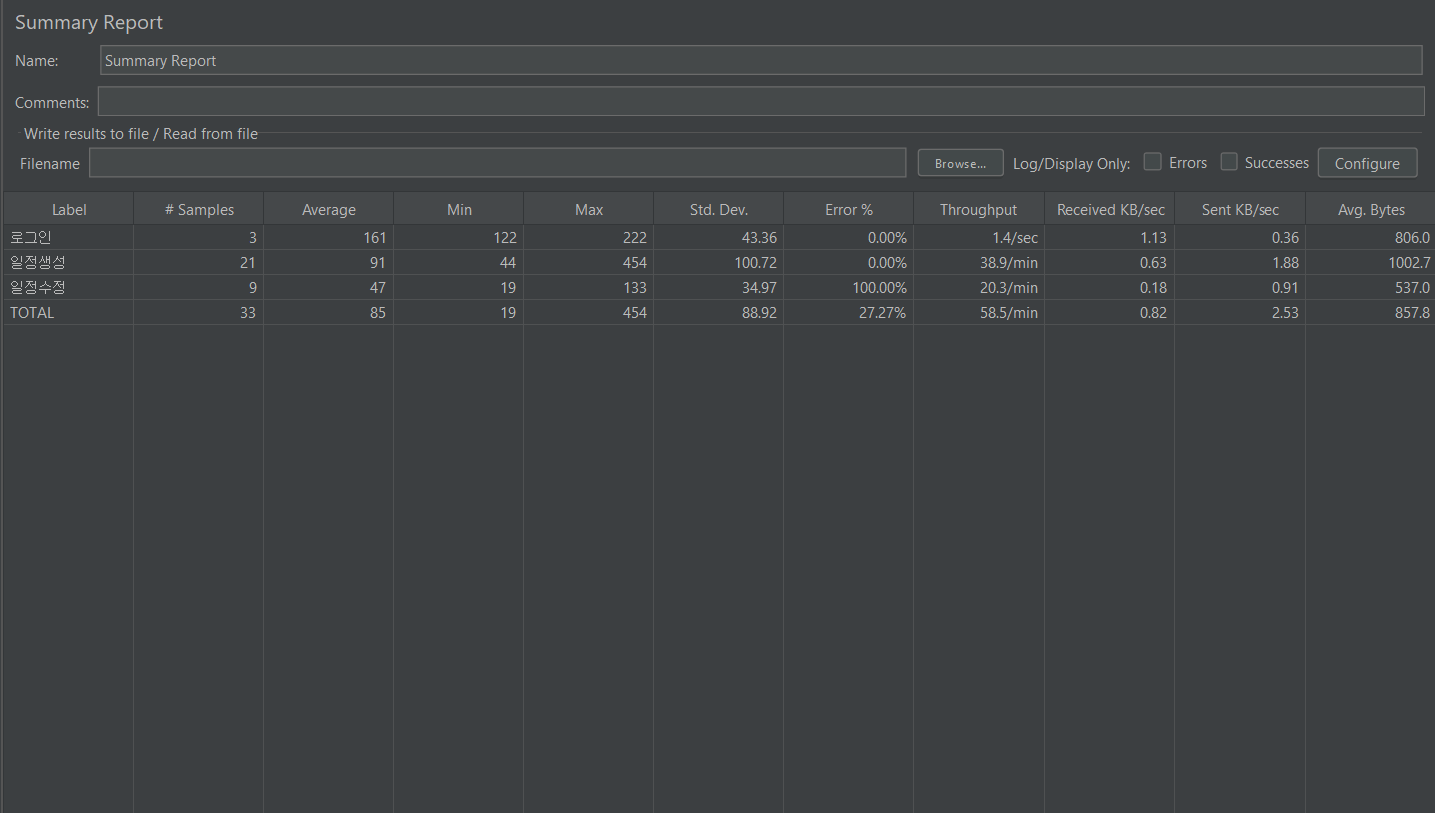
설정을 마친 뒤 3VU로 먼저 실행해 시나리오가 의도대로 동작하는지 확인했습니다. 결과는 아래와 같습니다.
스모크 조건 3 VU × loop 10
샘플 로그인 3 / 일정생성 21 / 일정수정 9 (총 33)
비율 생성:수정 = 21:9 = 70:30 (설계대로)
에러율 생성 0.00% / 수정 100.00%
응답시간 수정 평균 47ms (Min 19 / Max 133)
생성과 수정 비율은 설계대로 70:30이 나왔지만, 수정 요청은 9건 모두 실패했습니다(에러율 100%). 원인을 찾기 위해 Loki에서 에러 로그를 조회했습니다.
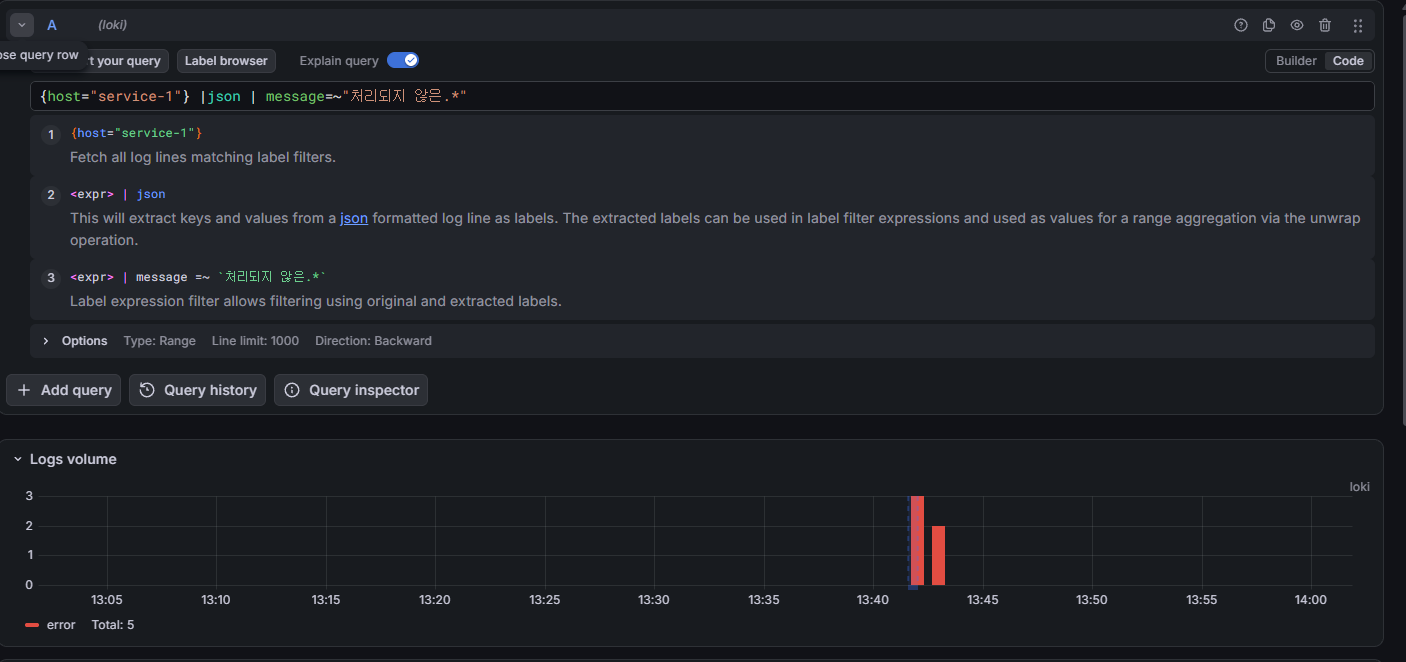
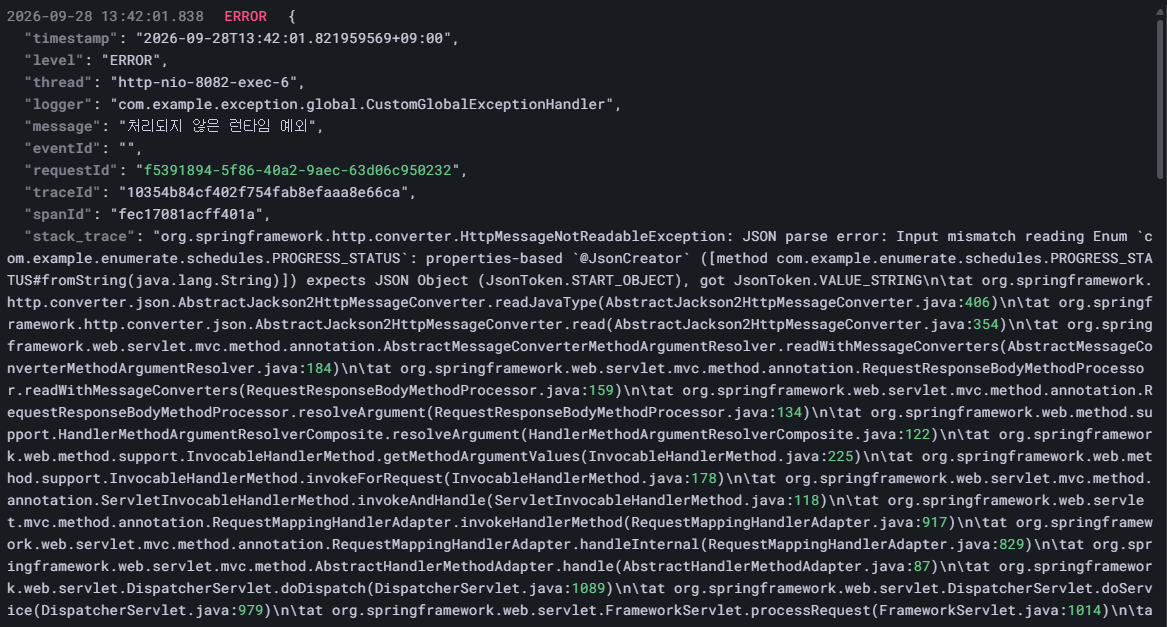
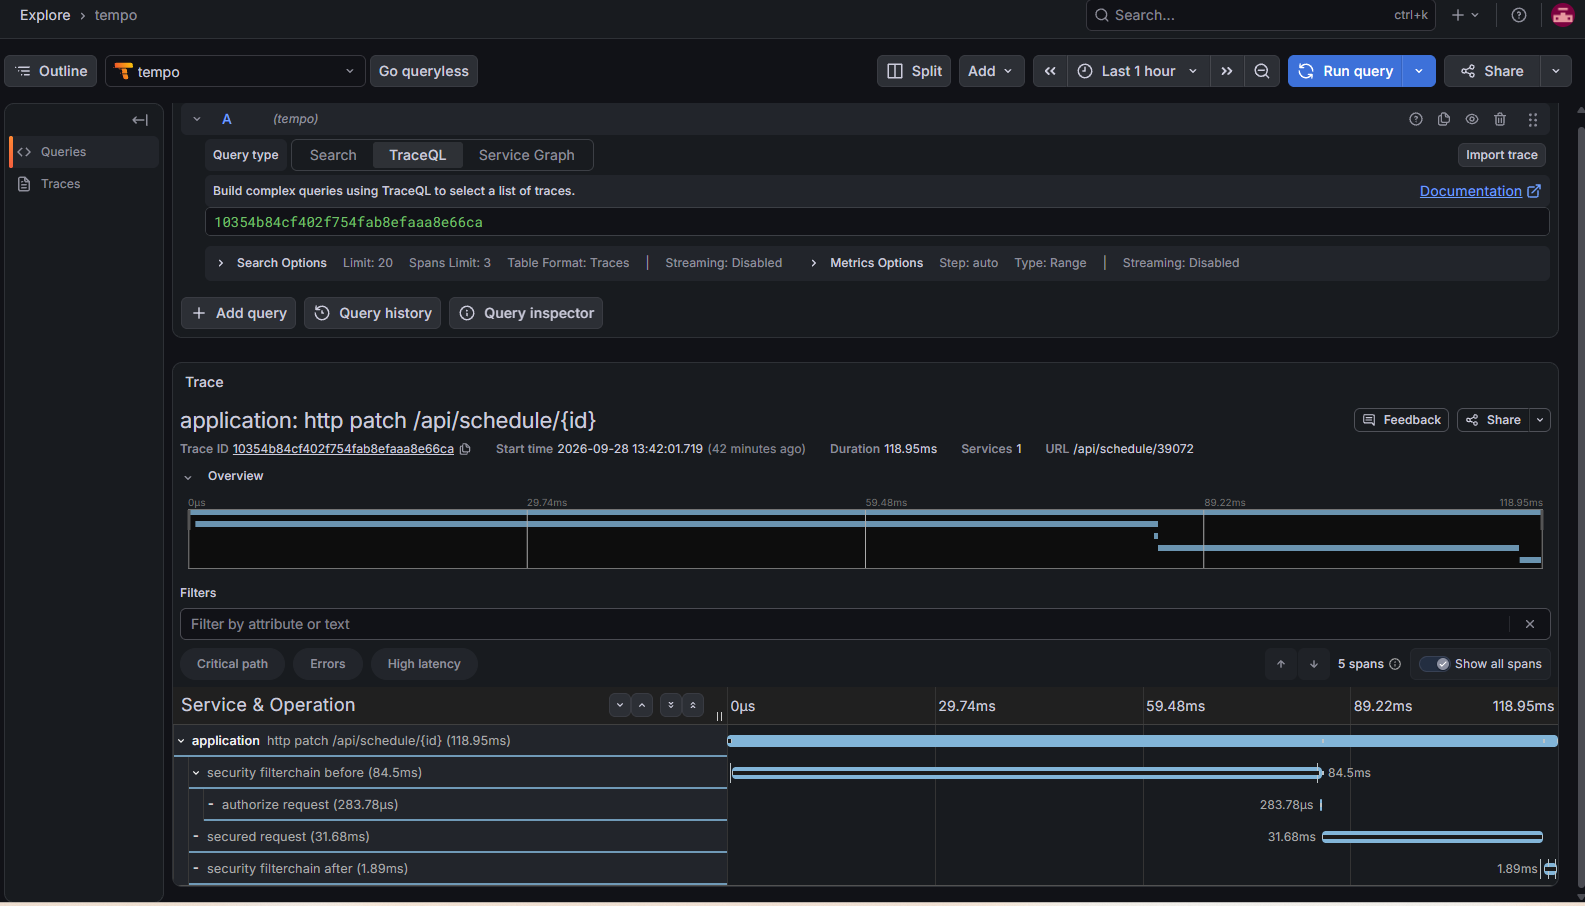
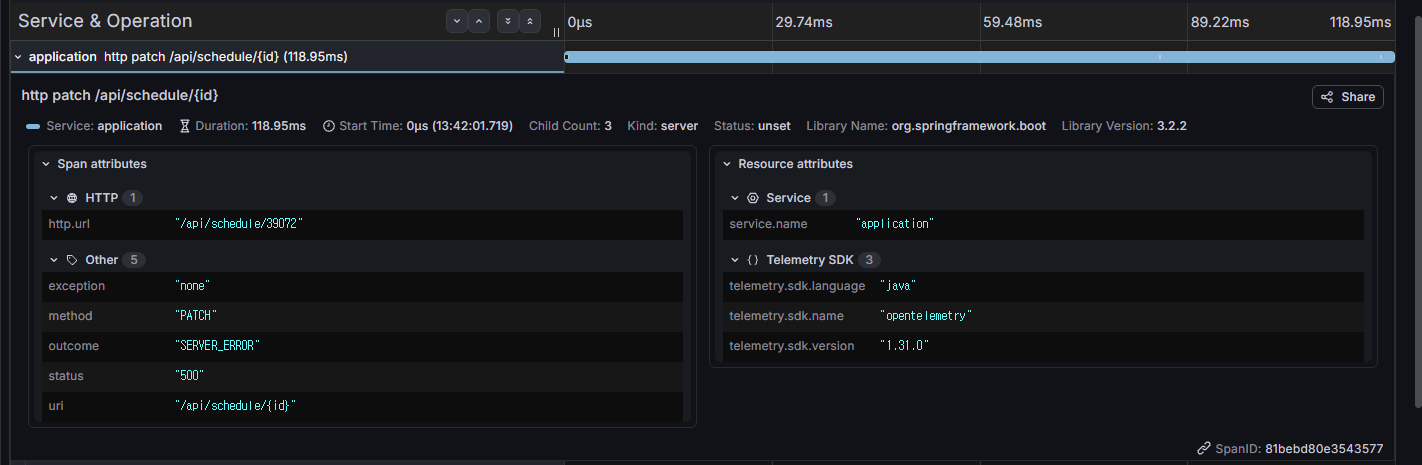
모니터링으로 traceId를 추적을 한 결과 에러 로그의 traceId로 Tempo에서 요청을 추적한 결과, HttpMessageNotReadableException: PROGRESS_STATUS … expects JSON Object, got VALUE_STRING 예외가 발생하고 있었습니다.
원인과 조치
스택 트레이스를 보면 PROGRESS_STATUS.fromString에 붙은 @JsonCreator가 properties 모드로 해석되어, 문자열이 아니라 {"value": ...} 형태의 객체만 받습니다. 그래서 JMeter 본문을 객체 형태로 바꿔 맞췄습니다. 이 과정에서 서버 쪽 문제도 두 가지 확인했습니다. 상태 enum이 일반 문자열을 받지 못하는 것, 그리고 요청 본문 파싱 실패(클라이언트 입력 오류)가 400이 아니라 500으로 응답되는 것입니다(Tempo 트레이스의 status 500). 둘 다 과제로 남겼습니다.
스모크 테스트 결과
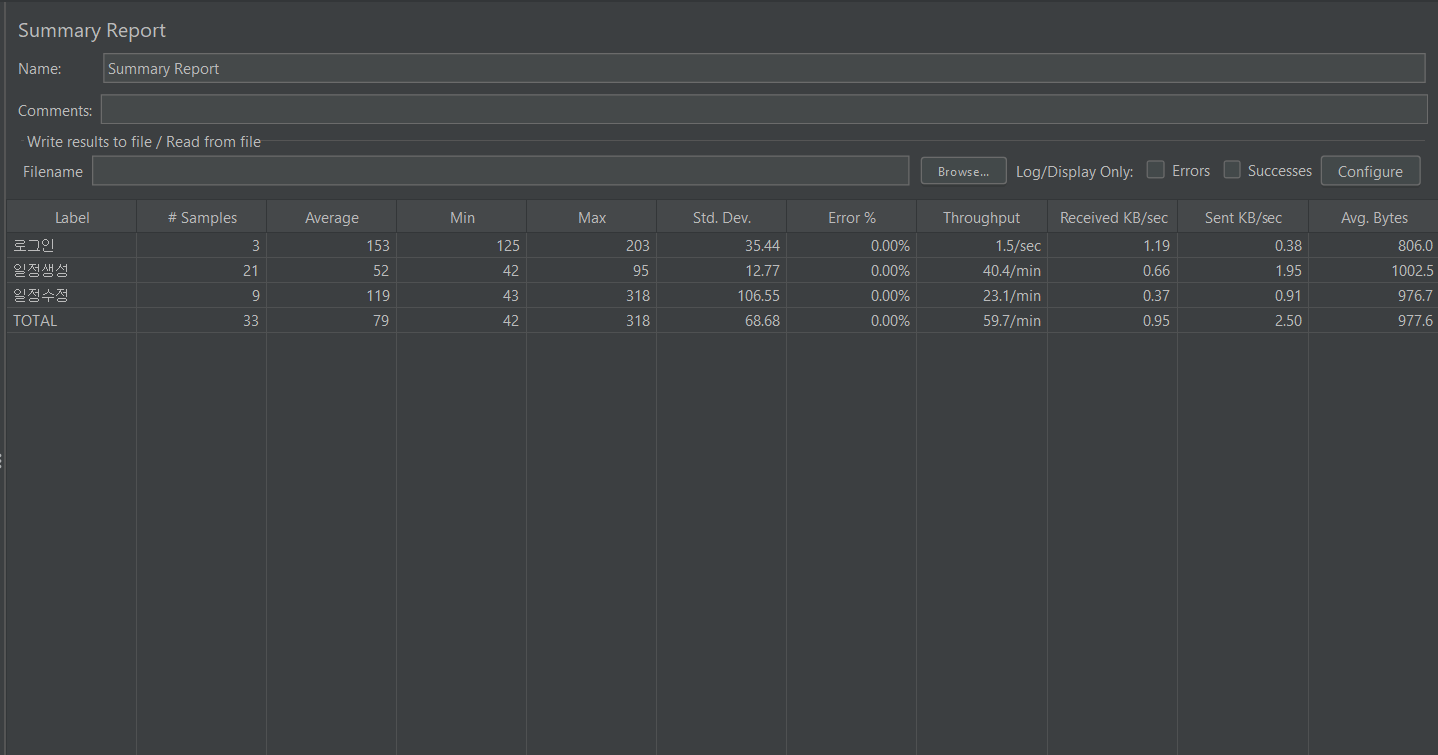
요청 바디를 계약에 맞게 수정한 뒤 동일 조건(3VU × Loop 10)으로 재실행했습니다. 재실행 결과는 아래와 같습니다.
| Samples | Average | Min | Max | Error % | |
| 로그인 | 3 | 153ms | 125 | 203 | 0.00% |
| 일정생성 | 21 | 52ms | 42 | 95 | 0.00% |
| 일정수정 | 9 | 119ms | 43 | 318 | 0.00% |
| TOTAL | 33 | 79ms | 42 | 318 | 0.00% |
생성 21 : 수정 9로 설계한 70:30 비율이 그대로 나왔고, 전 구간 에러율 0%입니다. 수정 요청의 평균 응답이 47ms에서 119ms로 늘었는데, 이는 성능이 나빠진 것이 아닙니다. 이전에는 인자 바인딩 단계에서 실패해 소유자 검증·조회·갱신·이벤트 발행을 전혀 수행하지 않고 끝났기 때문에 빨랐던 것입니다. 실패가 빠른 것은 개선의 신호가 아닙니다.
사후 정합성 검증으로 응답 코드만으로는 데이터가 실제로 반영됐는지 알 수 없어, DB를 직접 대조했습니다.
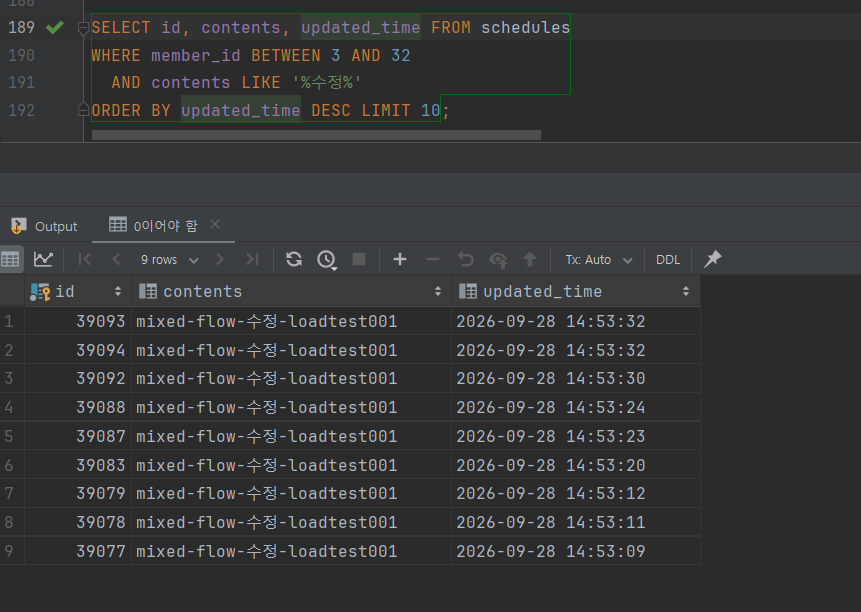
JMeter 수정 표본 9건과 갱신된 행 9건이 일치했고, updated_time도 테스트 수행 구간(14:53:09 ~ 14:53:32) 안에 모두 들어왔습니다. 200 응답과 실제 데이터 반영이 1:1로 대응하는 것을 확인했습니다.
3-2. 90vu 테스트
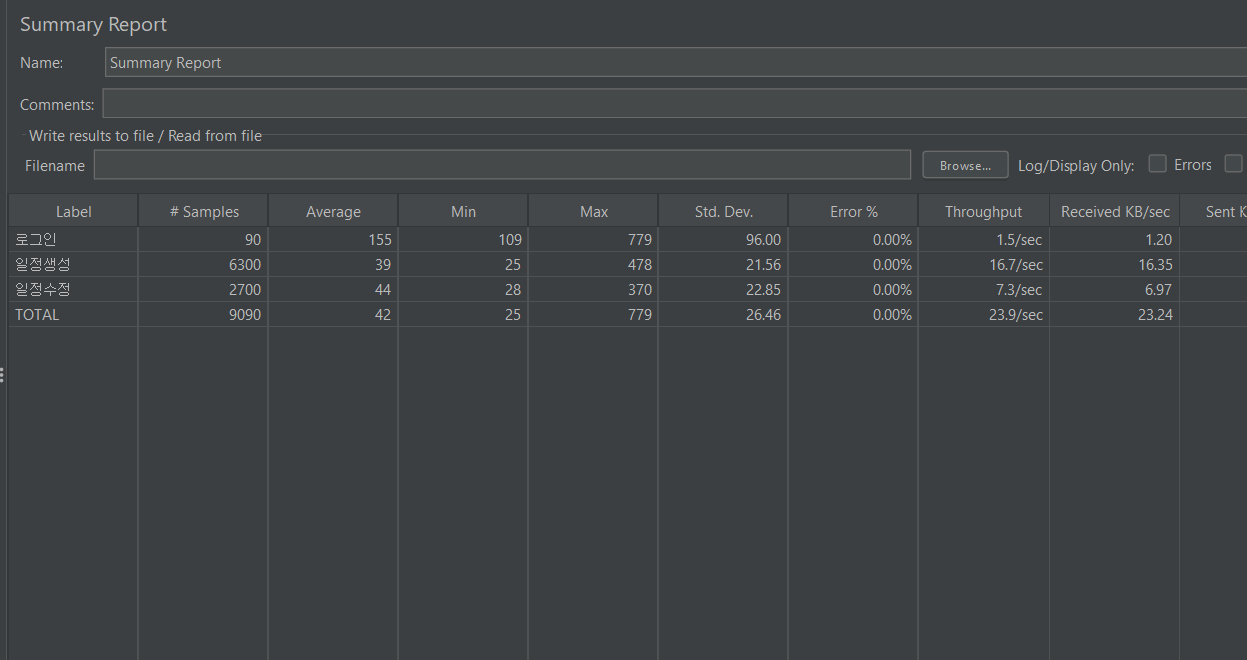
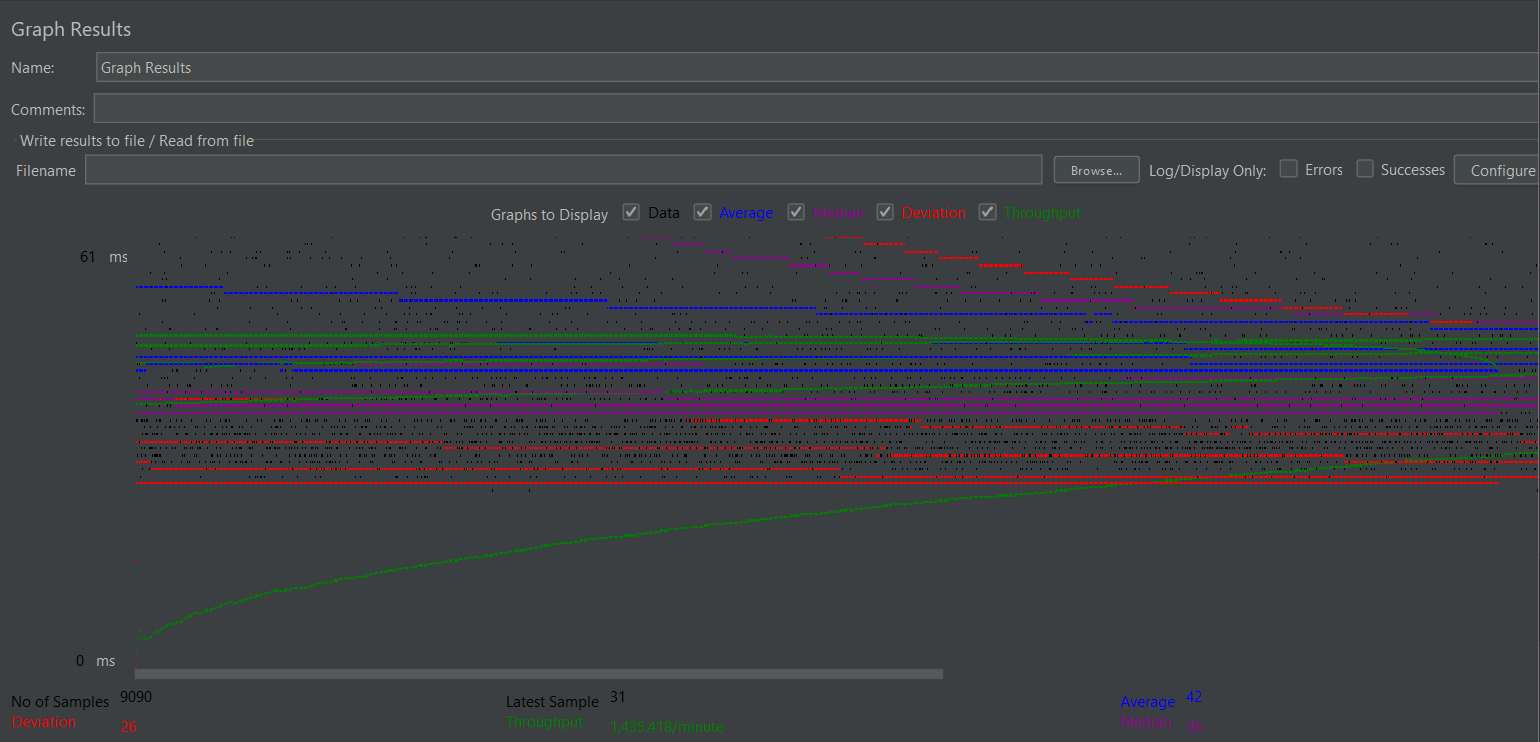
실행 조건
Thread          90 VU
Ramp-up         60초
Loop Count      100
Think-time      1~5초 (Uniform Random Timer)
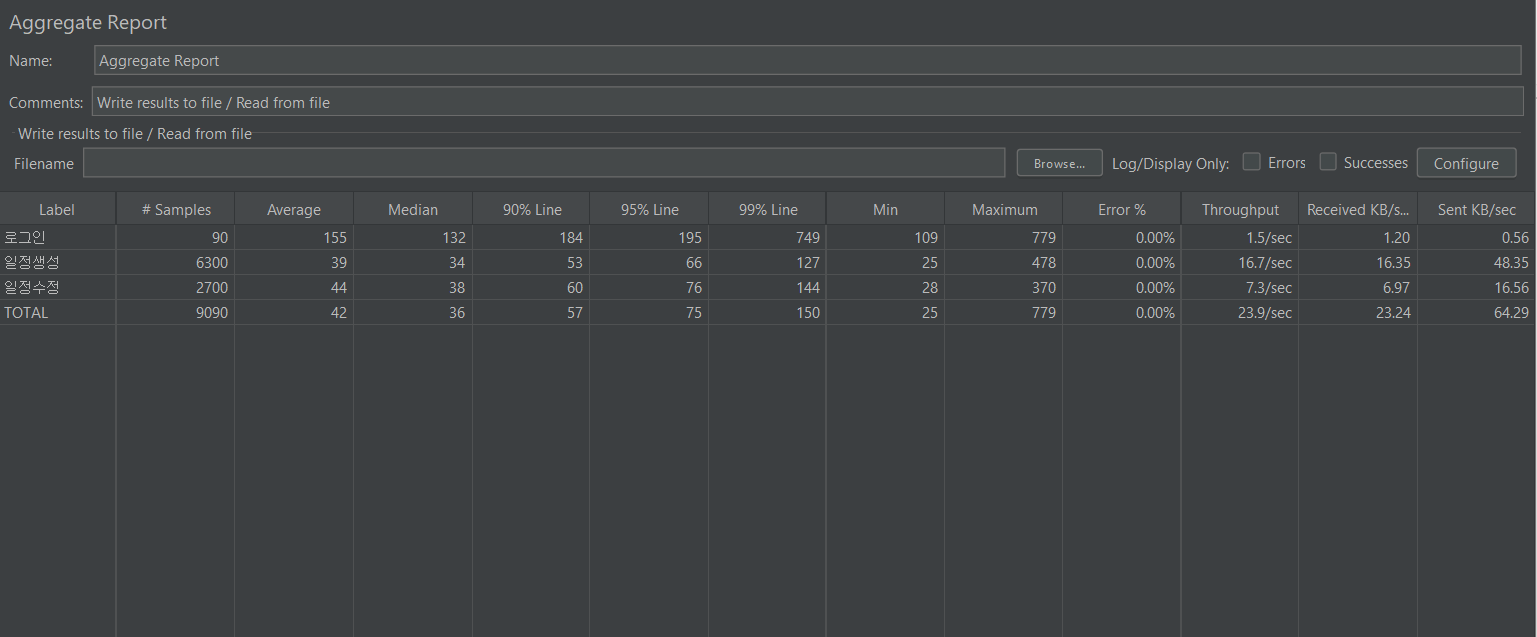
총 샘플          9,090건 (로그인 90 / 생성 6,300 / 수정 2,700)
소요 시간        약 6분 20초
리스너는 Summary Report와 Aggregate Report만 남기고 View Results Tree는 비활성화했습니다. 9,000건 규모에서 모든 요청응답을 메모리에 적재하면 JMeter 자체의 GC가 응답시간 측정값을 오염시키기 때문입니다.
결과
| Samples | Avg | Median | p90 | p95 | p99 | Max | Error % | |
| 로그인 | 90 | 155ms | 132 | 184 | 195 | 749 | 779 | 0.00% |
| 일정생성 | 6,300 | 39ms | 34 | 53 | 66 | 127 | 478 | 0.00% |
| 일정수정 | 2,700 | 44ms | 38 | 60 | 76 | 144 | 370 | 0.00% |
| TOTAL | 9,090 | 42ms | 36 | 57 | 75 | 150 | 779 | 0.00% |
처리량 23.9 req/s, 전 구간 에러율 0.00%입니다. 생성 6300 : 수정 2,700 = 정확히 70:30으로, 9,000회 반복 동안 Throughput Controller와 If Controller가 설계 비율을 그대로 유지했습니다.
처리량 예측과 실측의 일치
2-7에서는 이전 회귀 테스트의 응답시간 0.277초로 상한을 27 req/s로 잡았습니다. 실제 평균 응답시간은 0.042초였으므로 측정값으로 다시 계산합니다.
R = Think-time 3.0초 + 응답시간 0.042초 = 3.042초
X = 90 / 3.042 ≈ 29.6 req/s
전체 평균 23.9 req/s에는 램프업 60초와 스레드가 하나씩 끝나는 마지막 구간이 섞여 있습니다. 결과 파일(.jtl)을 분 단위로 잘라 90스레드가 모두 돈 구간만 보면 다음과 같습니다.
| 구간 | 처리량 |
| 02:23 | 29.2 req/s |
| 02:24 | 29.1 req/s |
| 02:25 | 29.4 req/s |
| 램프업 이후에서 첫 스레드 종료 전(250초, 7429건) | 29.0 req/s |
부하 모델로 계산한 상한 29.6 req/s 대비 98%입니다. 처리량을 정한 것은 서버가 아니라 Think-time이 들어간 부하 모델이었고, 이는 미리 계산할 수 있는 값이었습니다.
사후 정합성 검증
이번 실행으로 만든 일정만 세기 위해, 스레드별 시간 구간(2030~2035년) 조건으로 계정별 건수를 조회했습니다.
SELECT m.user_id, COUNT(*)
FROM schedules s JOIN member m ON s.member_id = m.id
WHERE s.start_time >= '2030-01-01' AND s.start_time < '2035-01-01'
GROUP BY m.user_id;
| 확인 | 기대 | 결과 |
| 계정 수 | 30 | 30 |
| 계정별 생성 건수 | 3스레드 × 70 = 210 | 전 계정 210 |
| 생성 합계 | 6300 | 6300 |
| 재처리 대상 (failed_message) | 0 | 0 |
수정 건수는 행 수로 대조하지 않았습니다. 수정은 직전에 만든 일정을 고치므로, 수정이 연달아 오면 같은 행을 두 번 고쳐 수정된 행 수가 요청 수(2,700)보다 적게 나올 수 있기 때문입니다.
| 항목 | 결과 |
| 에러율 | 9,090건 전 구간 0.00% |
| 흐름 비율 | 설계값 70:30 그대로 유지 |
| 처리량 | 예측 상한 대비 98% 계산이 실측과 일치 |
| 응답시간 분포 | p99/p50 = 4.2배, 큐잉 없음 |
| 시간 충돌(409) | 6,300건 생성 중 0건 스레드별 시간 구간 분리 유효 |
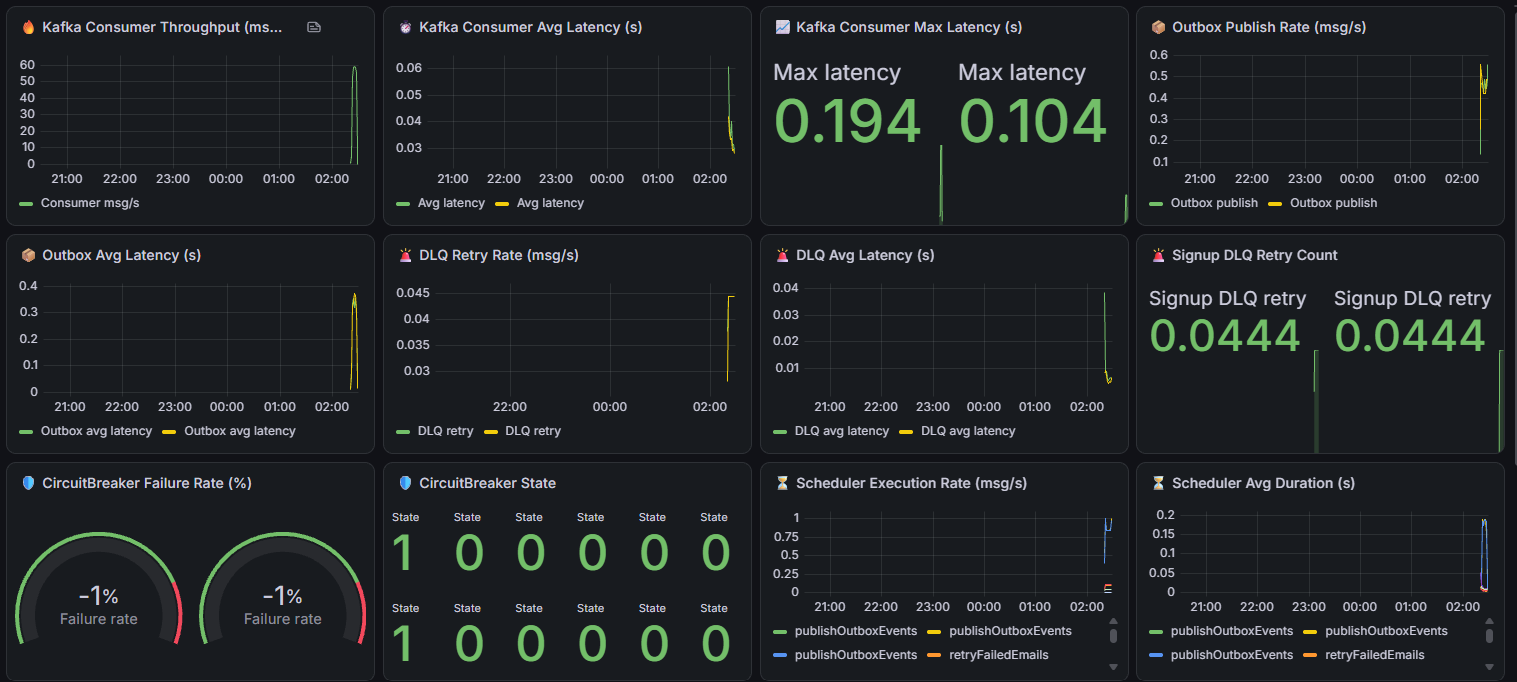
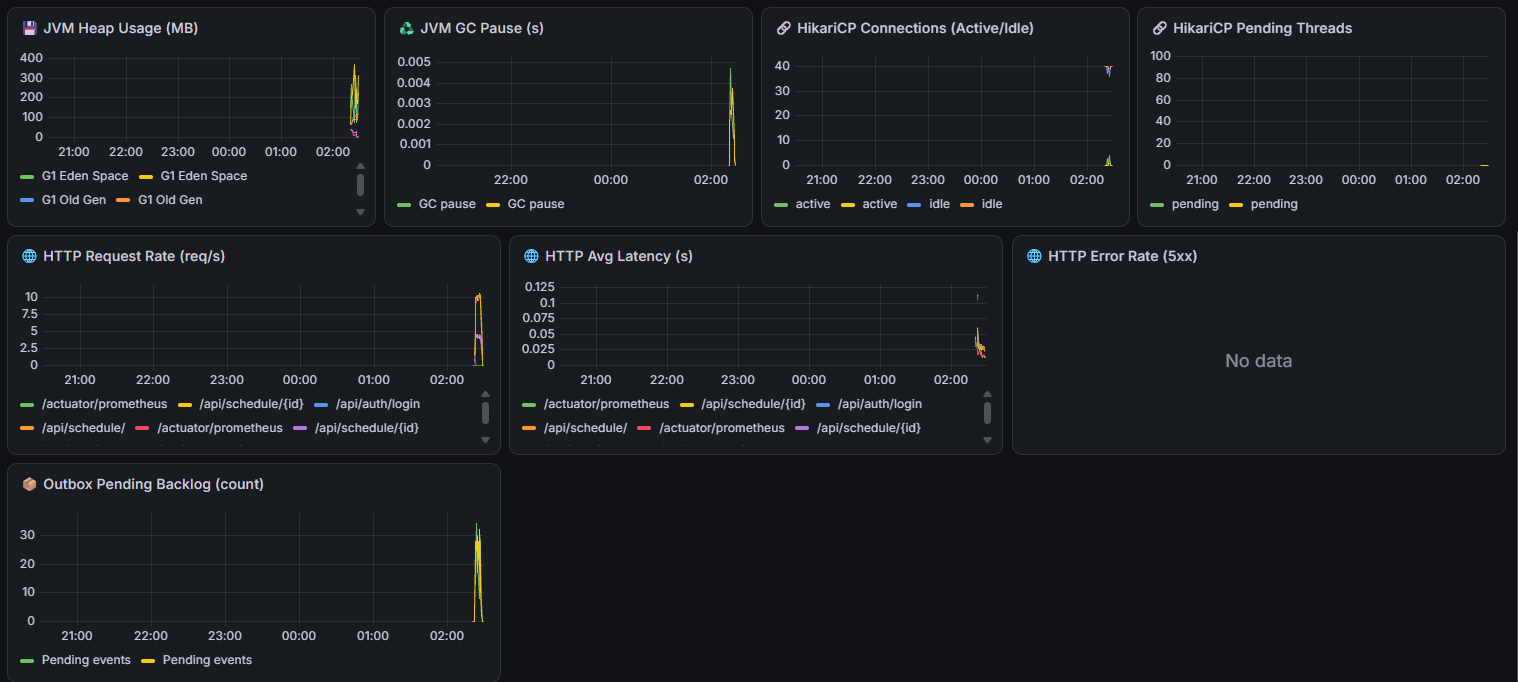
| 자원 | Heap·GC·커넥션 풀 전 구간 여유 |
3-3. 490vu 테스트
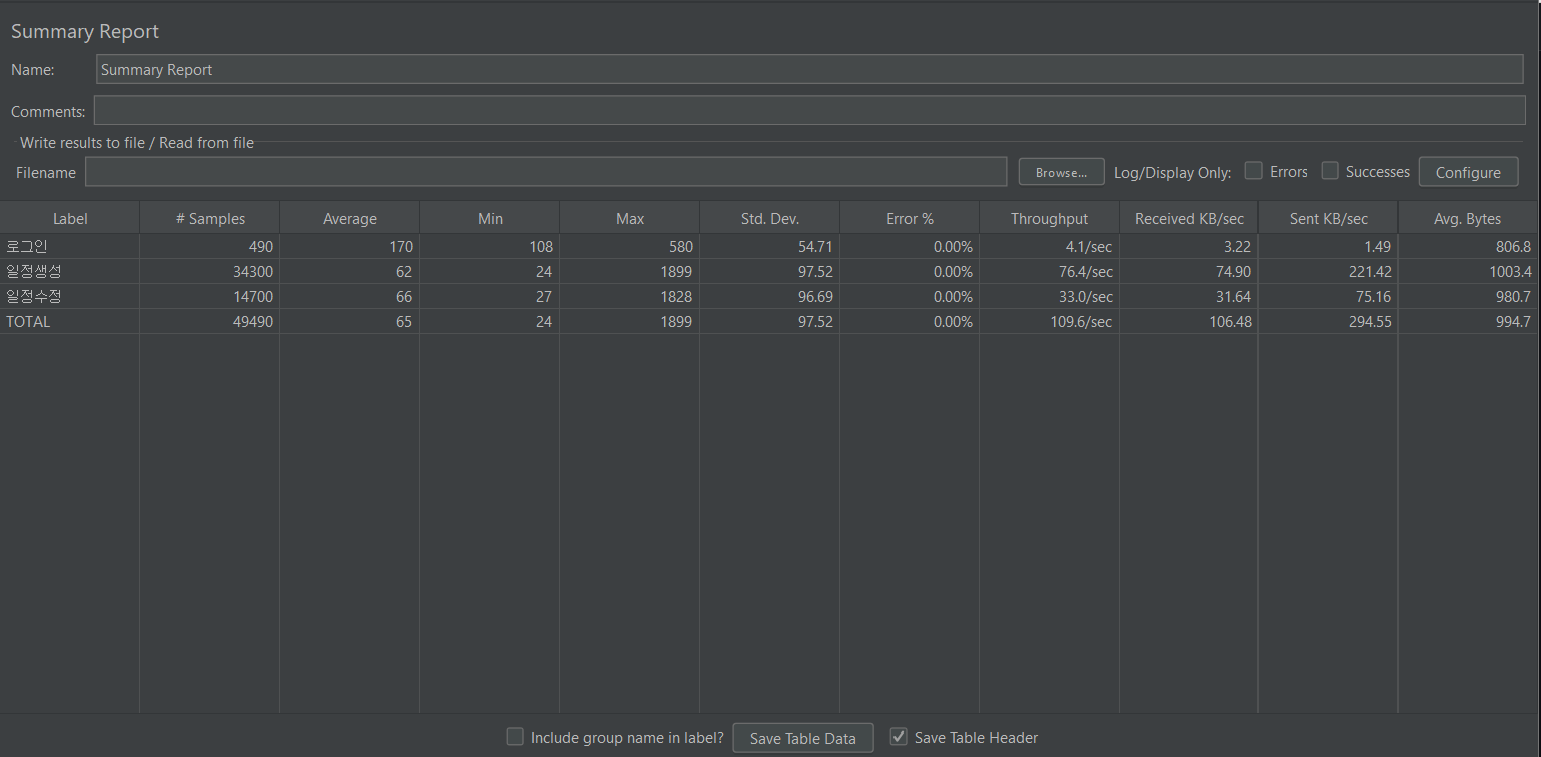
측정 조건
Thread          490 VU (계정 30개에 16~17스레드)
Ramp-up         120초
Loop Count      100
Think-time      1~5초
일정 시간 구간   스레드당 6,100분 (2030년 시작)
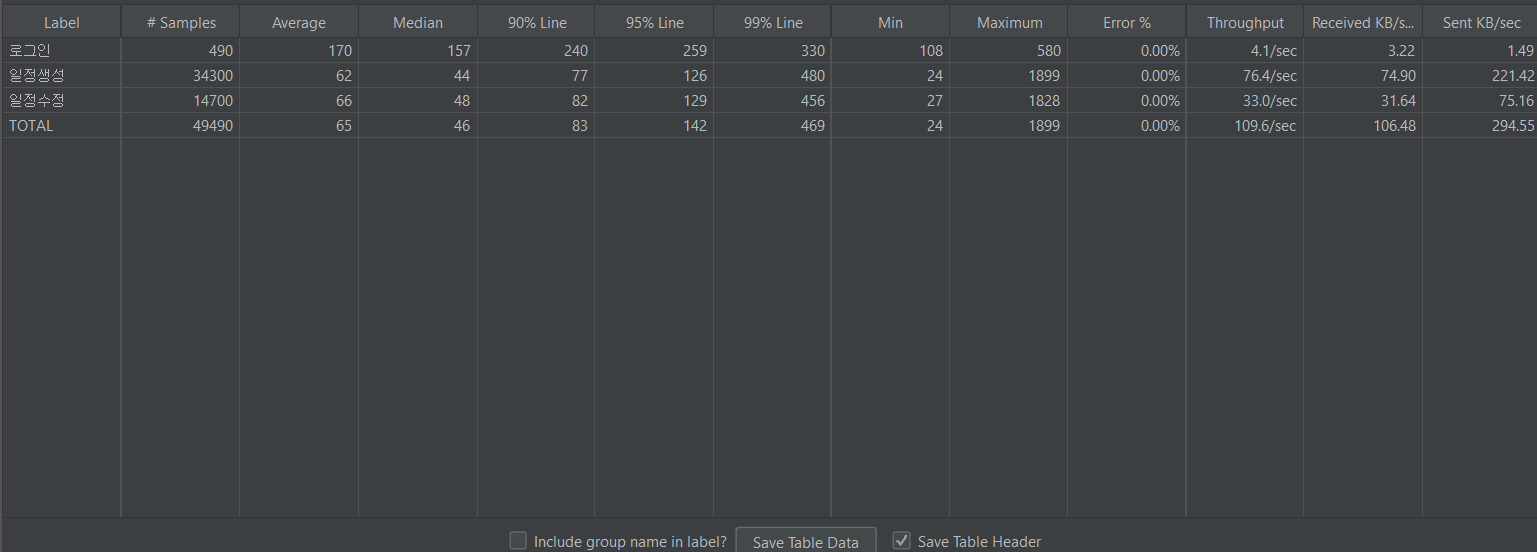
총 샘플          49,490건 (로그인 490 / 생성 34,300 / 수정 14,700)
첫 시도는 1분 만에 중단했습니다. 일정 시간 컬럼(start_time, end_time)이 MySQL TIMESTAMP라 2038-01-19 03:14:07(UTC)까지만 저장됩니다. 90VU 설정 그대로 스레드당 20,000분을 쓰자, 81번 이후 스레드의 일정이 이 한계를 넘어 생성에 실패했습니다. 간격을 6,100분으로 줄여 490스레드 전체가 2035년 안에 들어오게 했습니다. 실제 사용자도 2038년 이후 일정을 만들 수 없는 문제라, 컬럼을 DATETIME으로 바꾸는 것을 과제로 남겼습니다.
부하 발생기 쪽도 함께 기록했습니다. 테스트 동안 JMeter PC의 CPU는 평균 16%, 최대 31%였고 남은 메모리는 최소 2.9GB였습니다. 측정 도구가 결과를 왜곡하지 않았습니다.
결과는 아래와 같습니다.
| 항목 | Samples | Avg | p50 | p95 | p99 | Max | Error |
| 로그인 | 490 | 170 | 157 | 259 | 330 | 580 | 0.00% |
| 일정생성 | 34,300 | 62 | 44 | 126 | 480 | 1,899 | 0.00% |
| 일정수정 | 14,700 | 66 | 48 | 129 | 456 | 1,828 | 0.00% |
| TOTAL | 49,490 | 65 | 46 | 142 | 469 | 1,899 | 0.00% |
분 단위로 보면 490스레드가 모두 돈 12:22~12:24에 157.5, 161.0, 159.3 TPS가 나왔습니다. 부하 모델 상한(490 ÷ 3.065초 ≈ 160)과 같습니다. 서버는 들어오는 요청을 모두 받아냈고, 목표 구간 150~170 TPS의 하단을 에러 없이 통과했습니다. 170에 닿지 않은 것은 이 VU 수의 상한이 160이기 때문입니다.
꼬리는 90VU보다 길어졌습니다. p99/p50이 4.2배에서 약 10배가 됐고, 가장 나빴던 12:24 구간은 p99가 966ms였습니다. 이 시점은 아래 Outbox 적체가 2만 건을 넘어가던 때와 겹칩니다.


인프라 지표
| 항목 | 측정값 | 판정 |
| HTTP 요청 | 인스턴스 2대가 나눠 처리 (두 선 합계 약 113 req/s) | 분산 정상 |
| HikariCP | 인스턴스당 사용 중 최대 약 8 / 40, 대기 0 | 여유 |
| JVM | Old Gen 약 134MB로 평평, GC 최대 약 7ms | 누수 없음 |
| Kafka 컨슈머 | 120~150 msg/s, 최대 지연 0.69초 | 정상 |
| Outbox 적체 | 최대 약 25000건, 종료 약 4분 뒤에도 약 10000건 남음, 적체는 종료 약 6분 뒤 0 | 병목 |
사후 정합성 검증

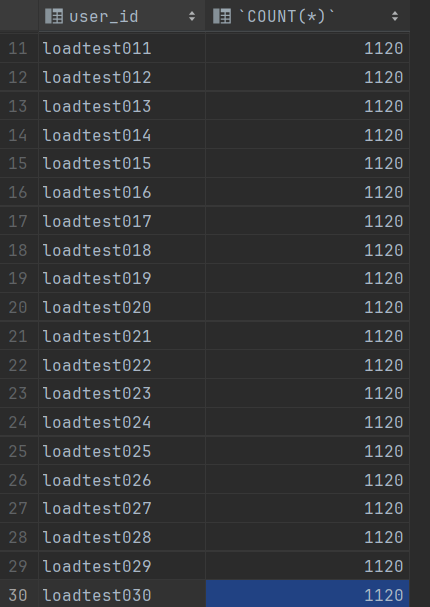
계정별 생성 건수는 17스레드 계정 10개가 1190건, 16스레드 계정 20개가 1120건으로 합계 34300건이었고, JMeter 생성 요청 수와 같습니다. 테스트가 끝나고 적체가 모두 빠진 뒤 미발행 Outbox는 0건, 재처리 대상(failed_message)도 0건이었습니다.
API는 목표 구간에서 에러 없이 버텼습니다. 그런데 Outbox 적체는 부하 중에 줄지 않고 계속 쌓였습니다.
3-4. 490VU 병목
490VU에서 API는 목표 구간을 에러 없이 통과했지만, 일정 생성,수정 이벤트를 Kafka로 내보내는 Outbox 발행이 유입을 따라가지 못했습니다.
유입     약 155 events/s   (생성·수정 1건당 이벤트 1건)
발행     약 60~70 events/s (한 번 실행 2~3초 → 200건 ÷ 약 3~3.5초, 테스트 종료 후 약 25,500건이 6분 만에 0)
순증가   약 90 events/s × 정상 구간 약 4.5분 ≈ 24,000건 (관측 최고치 약 25,500건과 비슷)
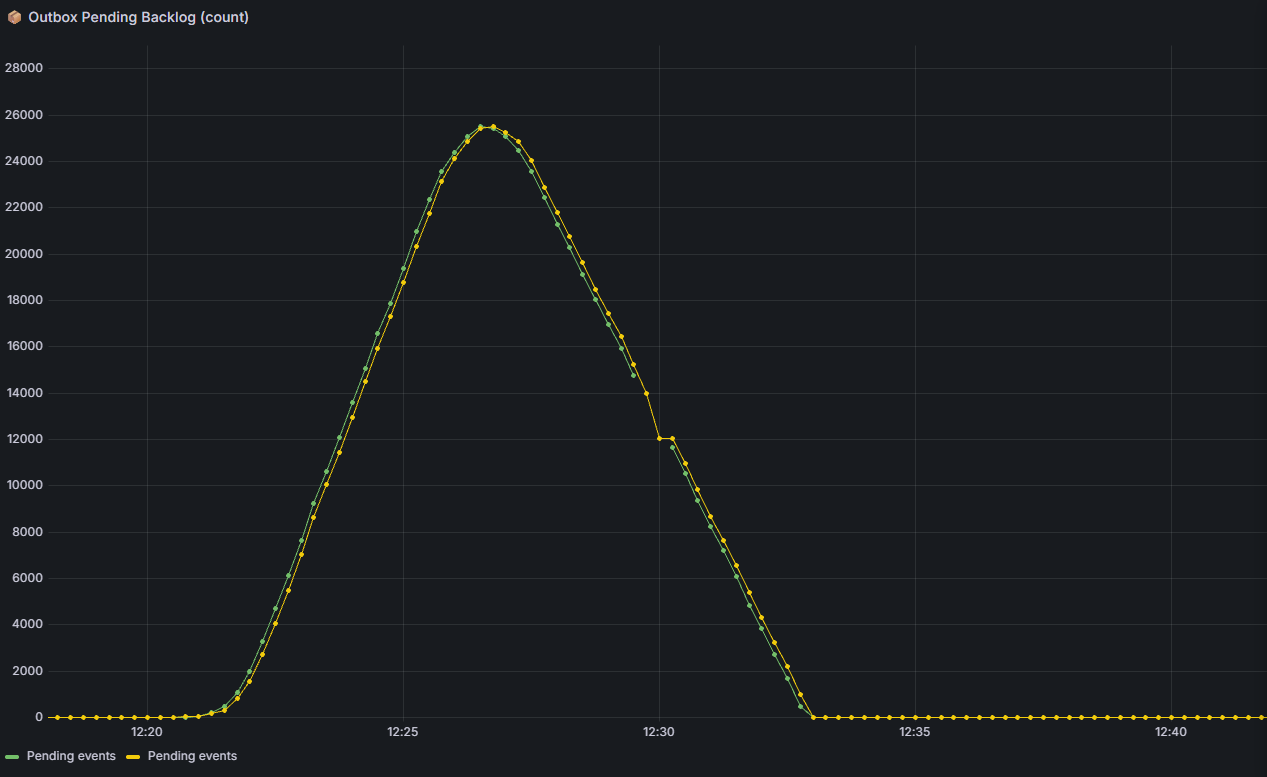
부하가 시작되자 적체가 계속 늘어 12:26~27에 약 25,500건까지 쌓였고, 부하가 끝난 뒤 0이 되기까지 약 6분이 걸렸습니다.
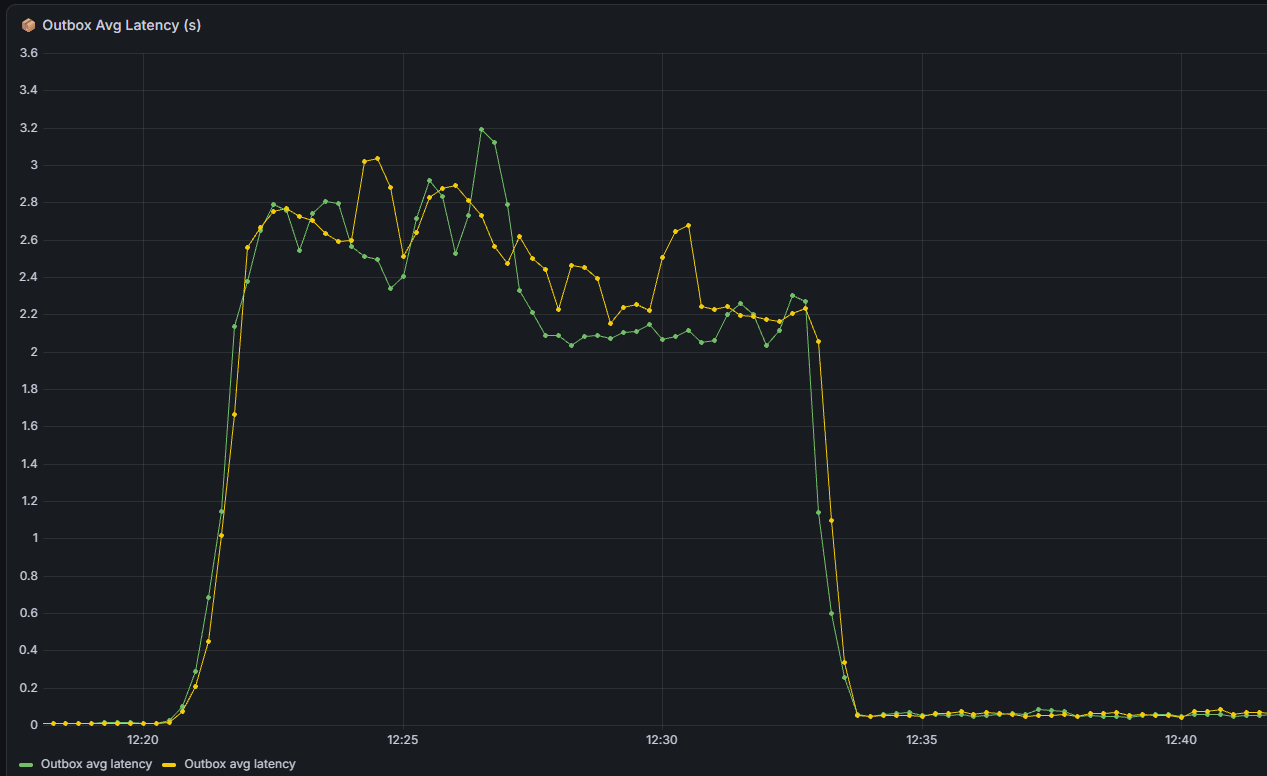
발행기는 1초마다 최대 200건을 처리하도록 설정되어 있지만, 적체가 있는 동안 한 번 실행에 2~3초가 걸렸습니다. 적체가 사라진 12:33 이후에는 0.05초 수준으로 돌아왔습니다.
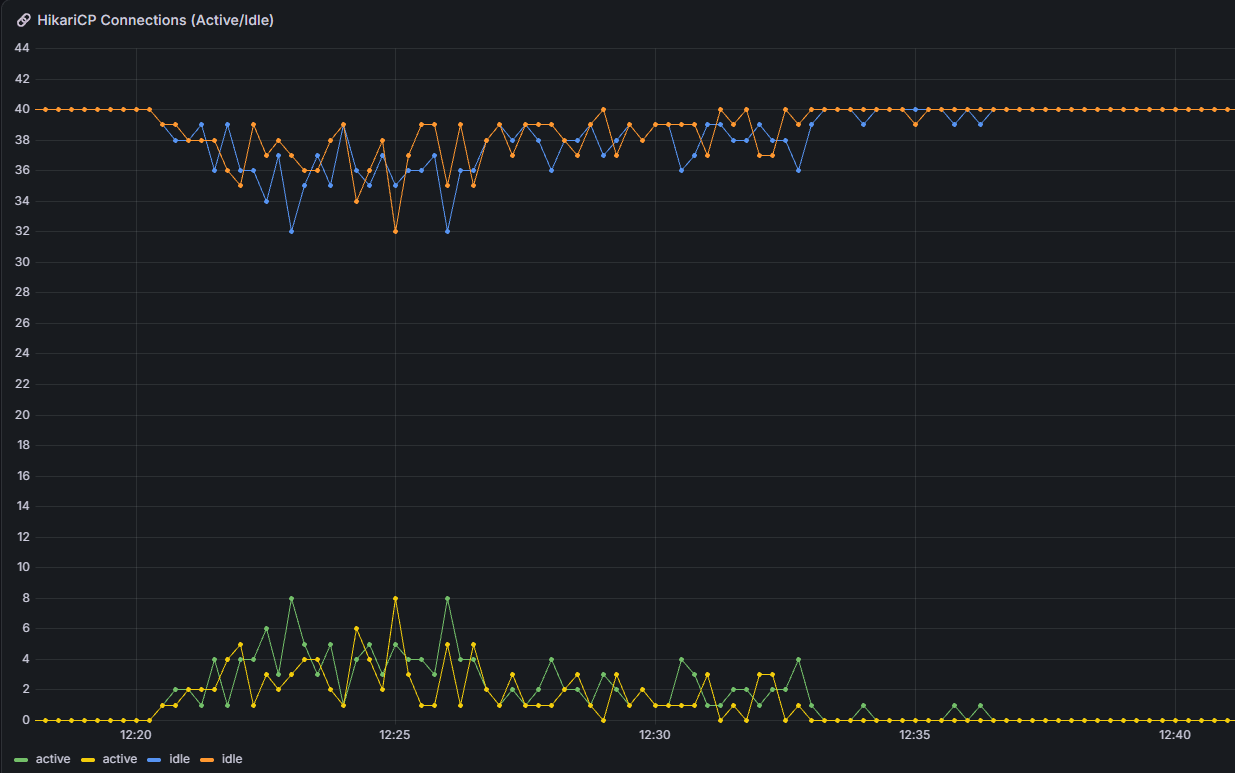
같은 시간 동안 커넥션은 40개 중 최대 8개만 사용했습니다. DB 자원이 부족해서 느린 것이 아니었습니다.
원인은 발행 방식이었습니다. 발행기는 1초마다 미발행 이벤트 200건을 조회한 뒤, 건마다 CAS UPDATE로 선점(트랜잭션 1번)하고, Kafka 전송이 성공하면 콜백 안에서 건마다 sent = true로 UPDATE했습니다. 한 주기에 DB 왕복이 약 400번 일어나는 구조입니다. 게다가 이 콜백은 Kafka 프로듀서의 I/O 스레드(Sender)에서 실행되기 때문에, 콜백의 DB 작업이 다른 메시지의 전송까지 늦출 수 있는 구조였습니다.
발행기는 ShedLock으로 한 인스턴스에서만 실행되므로, 앱 서버를 늘려도 이 한계는 그대로입니다. API는 수평 확장되지만 발행 경로는 그렇지 않은 구조였습니다.
유실은 없었습니다. 적체가 약 25,500건까지 쌓였지만 테스트 종료 약 6분 뒤 0이 되었고, 이후 조회에서 미발행 0건, 재처리 대상 0건이었습니다. 일정과 이벤트를 같은 트랜잭션에 저장하는 Outbox 패턴이 목적대로 동작했습니다. 알림이 늦어졌을 뿐 사라지지는 않았습니다.
3-5.건별 선점에서 배치 선점으로 전환
"한 이벤트는 한 실행만 가져간다"는 CAS의 보장은 유지하면서, 선점과 상태 반영을 배치 단위로 바꿨습니다. 처리 방식의 효과만 비교하려고 배치 크기(200건)와 실행 간격(1초)은 그대로 뒀습니다.
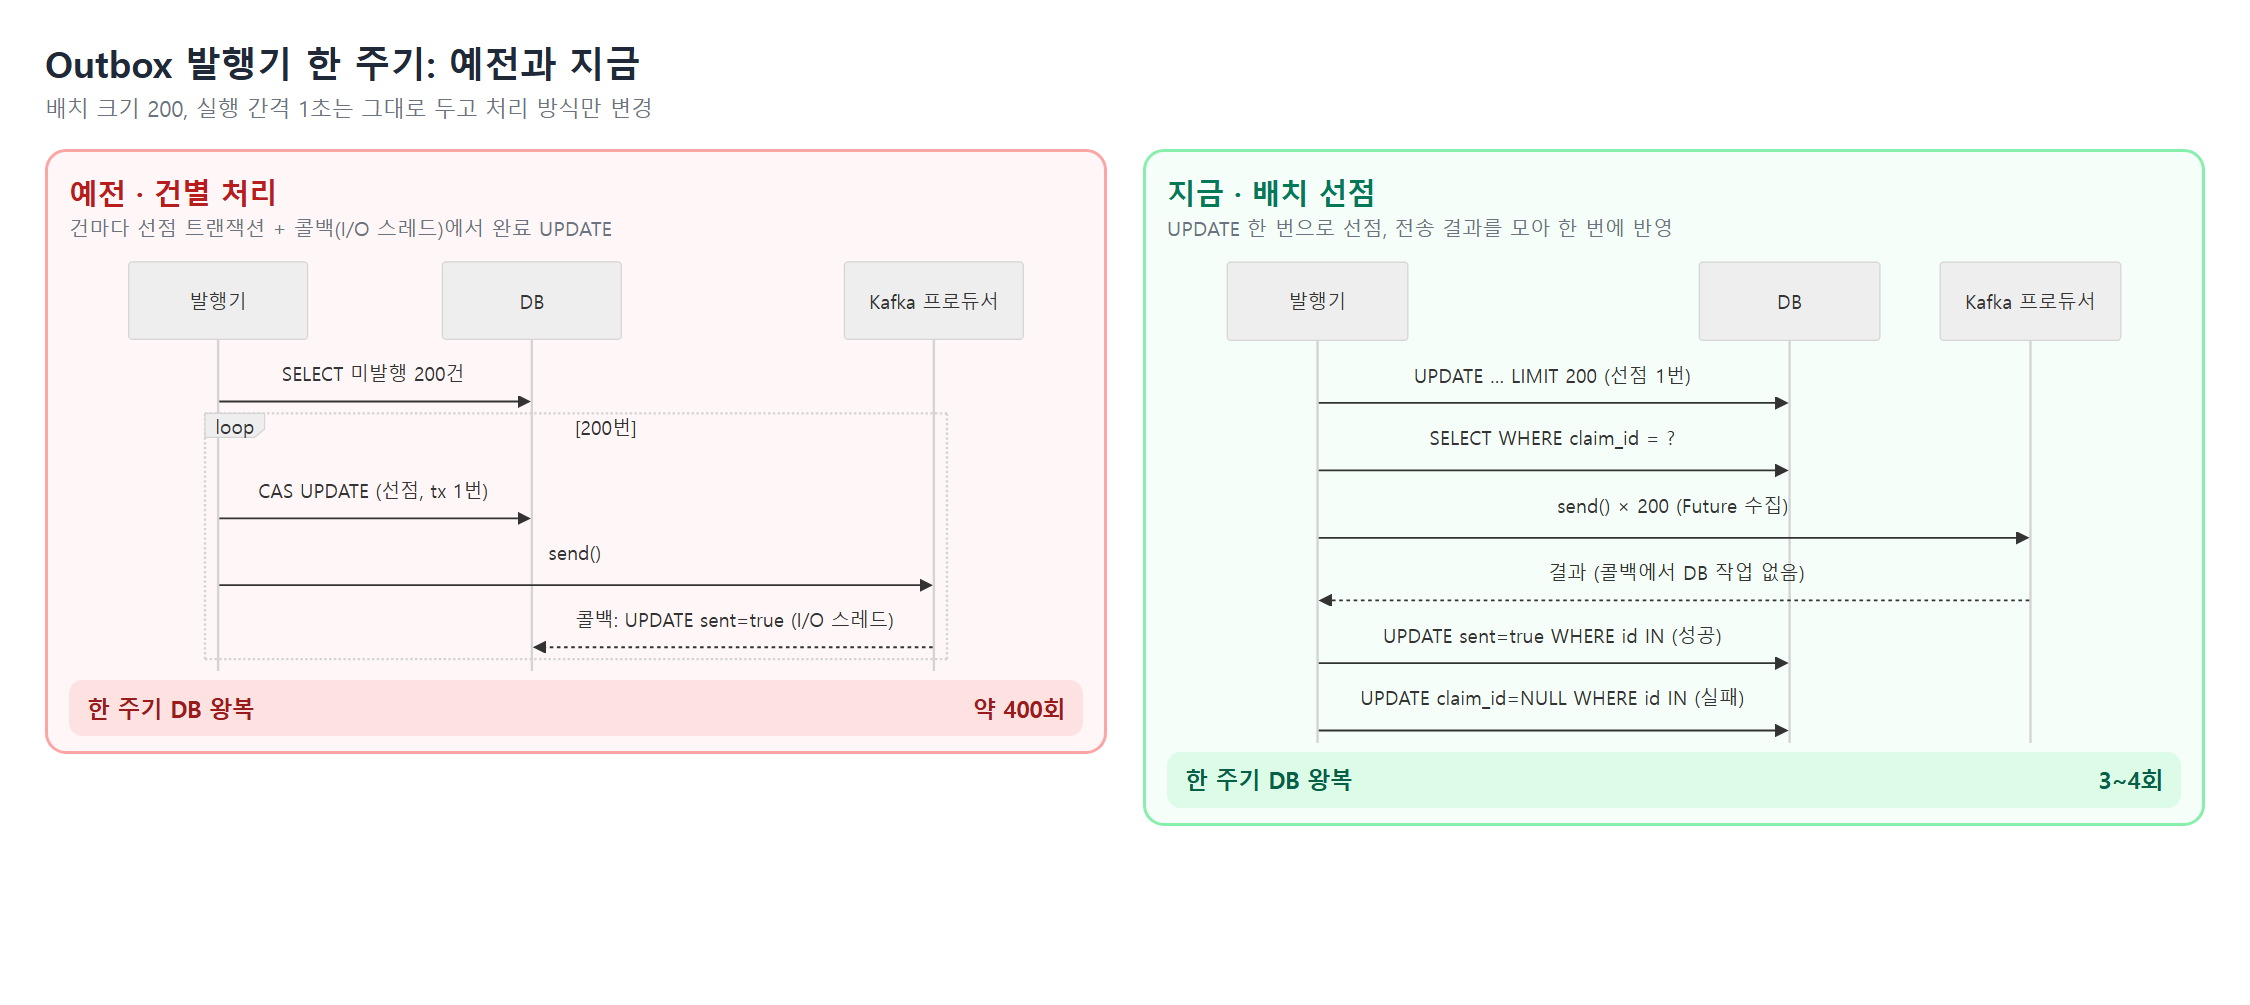
| 단계 | 예전 | 개선후 |
| 선점 | 건마다 CAS UPDATE (트랜잭션 200번) | UPDATE 1번으로 최대 200건에 claim_id 기록 |
| 전송 | 건마다 전송, 콜백에서 DB 갱신 | 전부 전송한 뒤 결과를 한꺼번에 대기, 콜백에서 DB 작업 없음 |
| 결과 반영 | 성공 UPDATE 200번 | 성공 UPDATE 1번, 실패 UPDATE 1번(선점 해제 → 다음 주기 재시도) |
| 한 주기 DB 왕복 | ≈ 400 | 3~4 |
UPDATE
	outbox_event_entity
SET
	claim_id = :claimId, claimed_at = :now, retry_count = retry_count + 1
WHERE
	sent = false AND (claim_id IS NULL OR claimed_at < :staleBefore)
ORDER BY created_at
LIMIT 200;
UPDATE가 대상 행에 쓰기 락을 잡고, 이미 선점된 행은 claim_id IS NULL 조건에서 빠지므로 두 실행이 같은 행을 가져가지 않습니다. 발행 도중 서버가 죽어 선점이 남은 행은 30초 뒤 다른 실행이 회수합니다.
Kafka 메시지 키는 aggregateId(일정 ID)로 지정했습니다. 키가 없던 예전에는 같은 일정의 생성·수정 이벤트가 다른 파티션으로 가서 순서가 바뀔 수 있었습니다. 같은 키는 같은 파티션으로 가므로 파티션 안에서 순서가 지켜집니다.
대가도 있습니다. 10초 안에 전송 결과가 오지 않은 건은 실패로 보고 다시 보내므로, 뒤늦게 성공한 건이 한 번 더 나갈 수 있습니다. 이 경우는 컨슈머가 (consumer, event_id) 기준으로 중복을 걸러냅니다. 최소 한 번 발행과 컨슈머 멱등성의 조합입니다.
3-6.재측정 결과
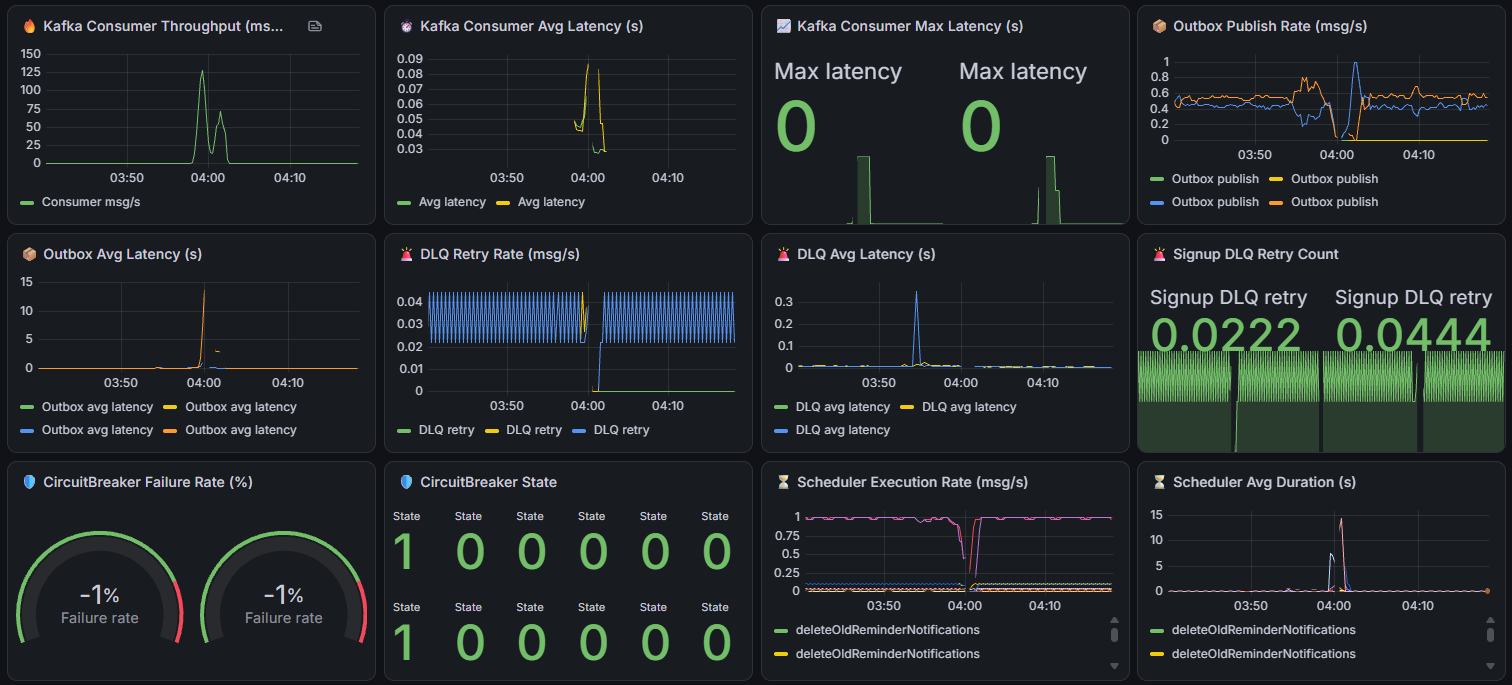
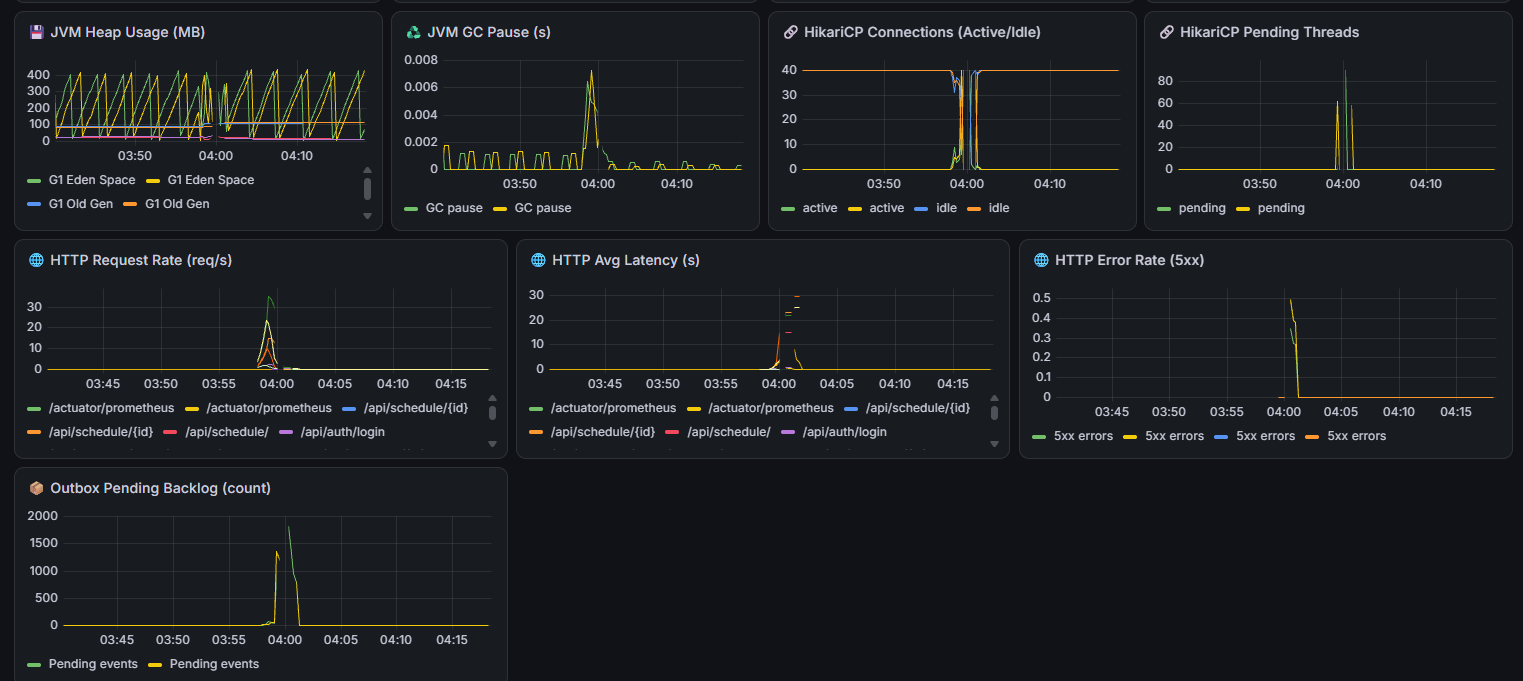
배치 선점을 배포하고 9월 30일과 같은 조건(490VU, 램프업 120초, loop 100)으로 다시 측정했습니다. 그런데 램프업이 끝나기도 전에 502가 쏟아졌습니다. 두 서버 모두 커넥션 40개를 전부 사용 중이었고, 커넥션을 기다리는 스레드가 60~90개까지 올라갔습니다. HTTP 평균 응답은 15~30초까지 늘었습니다.
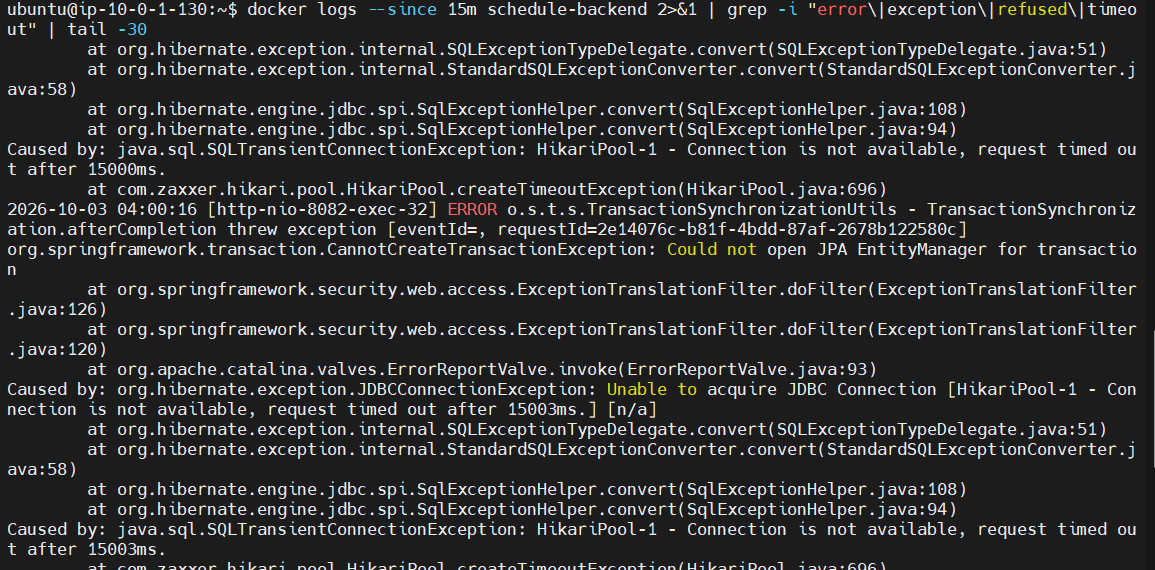
에러 로그를 보면 ERROR TransactionSynchronization.afterCompletion threw exception
CannotCreateTransactionException: Could not open JPA EntityManager for transaction
HikariPool-1 - Connection is not available, request timed out after 15003ms 으로 afterCompletion, 즉 커밋 직후에 실행되는 리스너가 새 커넥션을 받지 못해 실패하고 있었습니다. 해당 리스너는 리마인더 저장이었습니다.
@TransactionalEventListener(phase = TransactionPhase.AFTER_COMMIT)
@Transactional(propagation = Propagation.REQUIRES_NEW)
public void handleReminderRegistration(ScheduleDomainEvent event) { ... }
원인은 리스너 단계(AFTER_COMMIT)와 전파 속성(REQUIRES_NEW)의 조합이었습니다. Spring은 AFTER_COMMIT 리스너가 끝날 때까지 원래 트랜잭션의 커넥션을 반납하지 않습니다. 이 상태에서 REQUIRES_NEW로 새 트랜잭션을 열면 커넥션을 하나 더 요청합니다.
원인은 리스너 단계(AFTER_COMMIT)와 전파 속성(REQUIRES_NEW)의 조합이었습니다. Spring은 AFTER_COMMIT 리스너가 끝날 때까지 원래 트랜잭션의 커넥션을 반납하지 않습니다. 이 상태에서 REQUIRES_NEW로 새 트랜잭션을 열면 커넥션을 하나 더 요청합니다. 결국 일정 생성 요청 하나가 커넥션 두 개를 잡았습니다. 490VU에서는 동시에 40개가 넘는 요청이 첫 번째 커넥션을 쥔 채 두 번째를 기다리면서, 풀이 바닥났습니다.
이 코드는 이틀 전, 리마인더가 저장되지 않던 버그를 고치며 넣은 것이었습니다. 원래는 기본 전파(REQUIRED)로 저장했는데, AFTER_COMMIT 시점에는 이미 끝난 트랜잭션에 참여하게 되어 리마인더가 예외 없이 버려지고 있었습니다. 그래서 이 두 번째 커넥션 요청 자체가 없었고, 문제가 드러나지 않았습니다. 90VU에서는 동시 요청이 적어 풀이 버텼습니다.
수정: 리마인더를 Outbox와 같은 트랜잭션(BEFORE_COMMIT)에서 저장하도록 바꿨습니다. 9월 11일 리마인더를 트랜잭션 밖으로 뺐던 이유는 생성 때마다 실행되던 느린 DELETE(2.6~3.2초)였습니다. 이 DELETE는 이미 제거했기 때문에, 지금 트랜잭션에 추가되는 작업은 INSERT 1건입니다. 일정과 리마인더가 함께 커밋되므로, "커밋 후 리마인더 저장이 실패하면 재시도할 방법이 없다"는 한계도 함께 사라졌습니다.
3-7. 재측정 2차
수정 후 같은 조건으로 다시 측정했습니다.
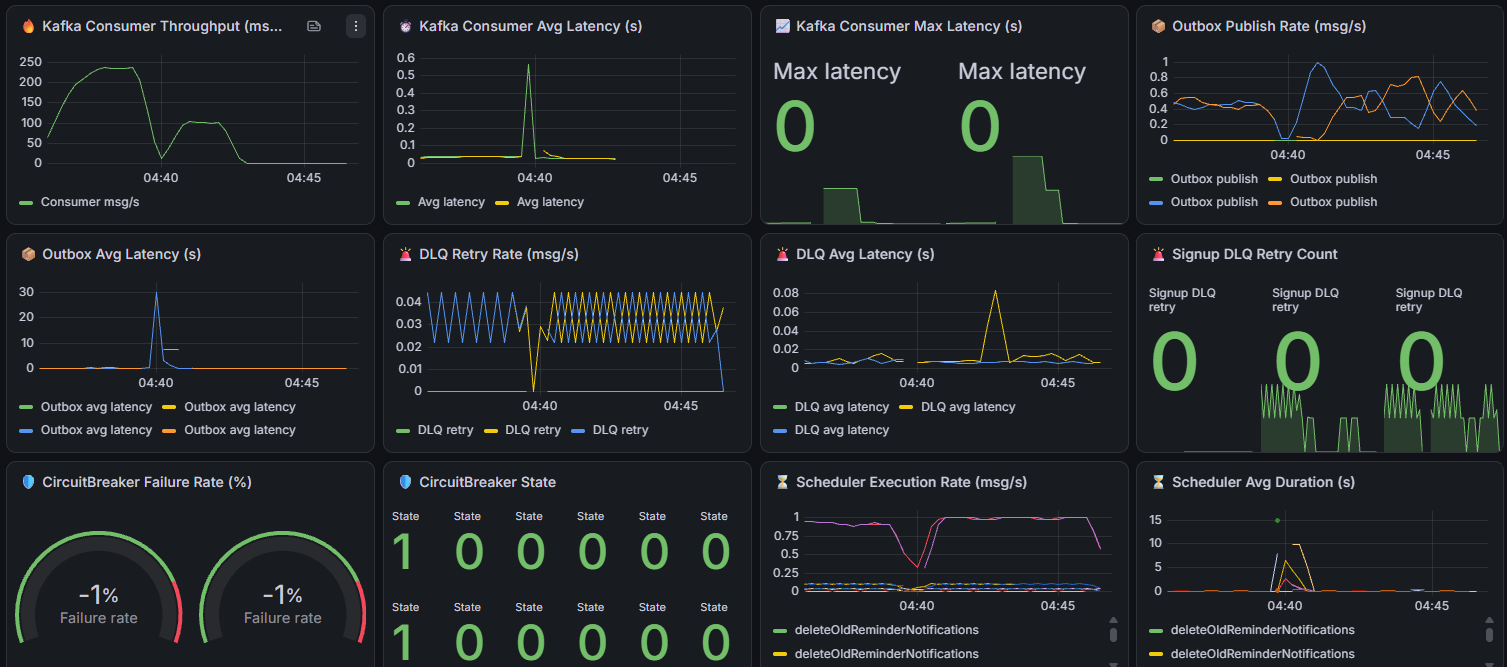
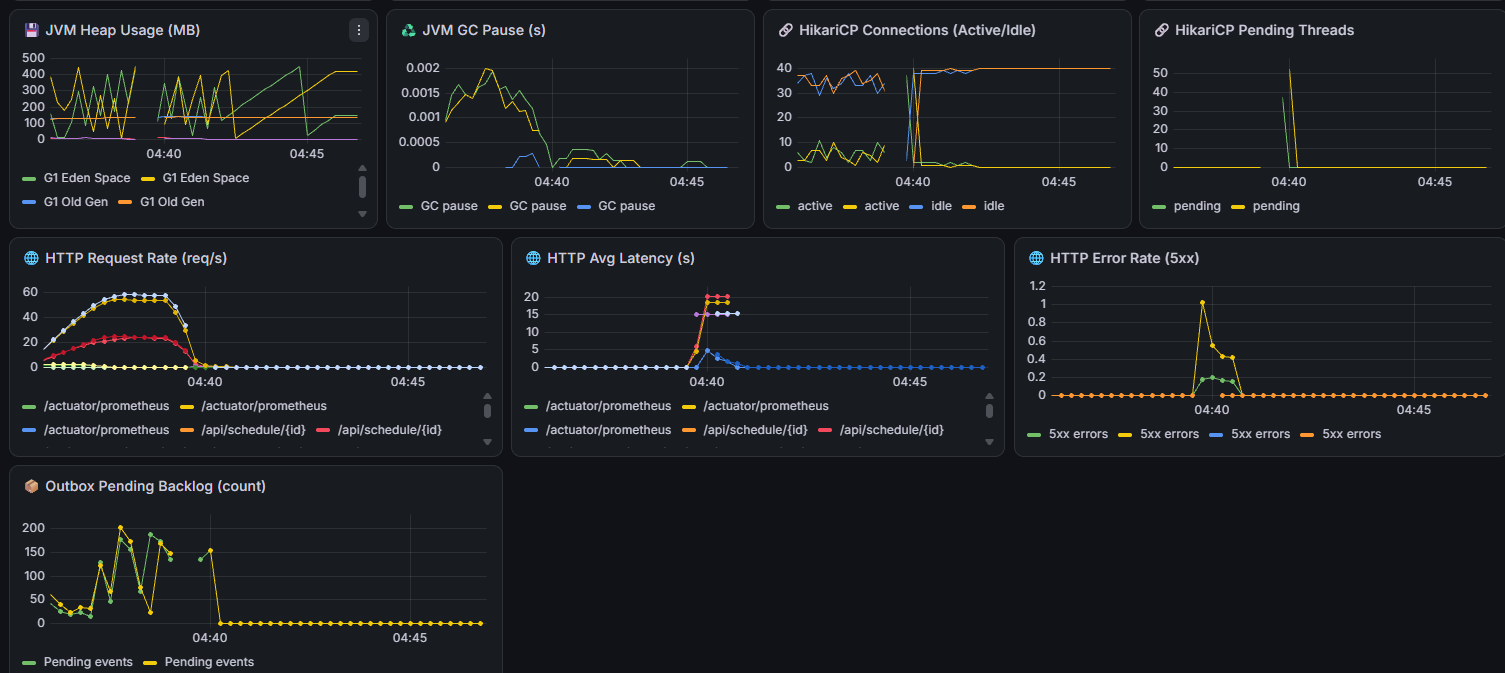
490VU 부하가 모두 걸린 약 3분 동안 결과는 이랬습니다.
| 지표 | 건별 처리시 | 배치 선점 |
| Outbox 적체 최대 | 약 25500건 | 약 200건 |
| Kafka 컨슈머 처리량 | 120~150 msg/s | 약 230 msg/s |
발행이 유입을 따라잡았습니다. 이벤트가 쌓이지 않고 바로 컨슈머로 넘어갔습니다. 그런데 테스트 시작 약 4분 뒤, 두 서버의 커넥션 풀이 동시에 40개로 차고 대기 스레드가 약 55개까지 올라가며 다시 502가 발생했습니다. 앱 로그에는 HTTP 요청 스레드뿐 아니라 Kafka 컨슈머 스레드도 커넥션을 기다리다 실패한 기록만 남아 있었습니다. 데드락이나 락 대기 타임아웃 기록은 없었습니다.
두 서버가 동시에 막혔기 때문에, 처음에는 공유 자원인 DB 자체의 한계를 의심했고 RDS의 CloudWatch의 모니터링 지표를 봤습니다.
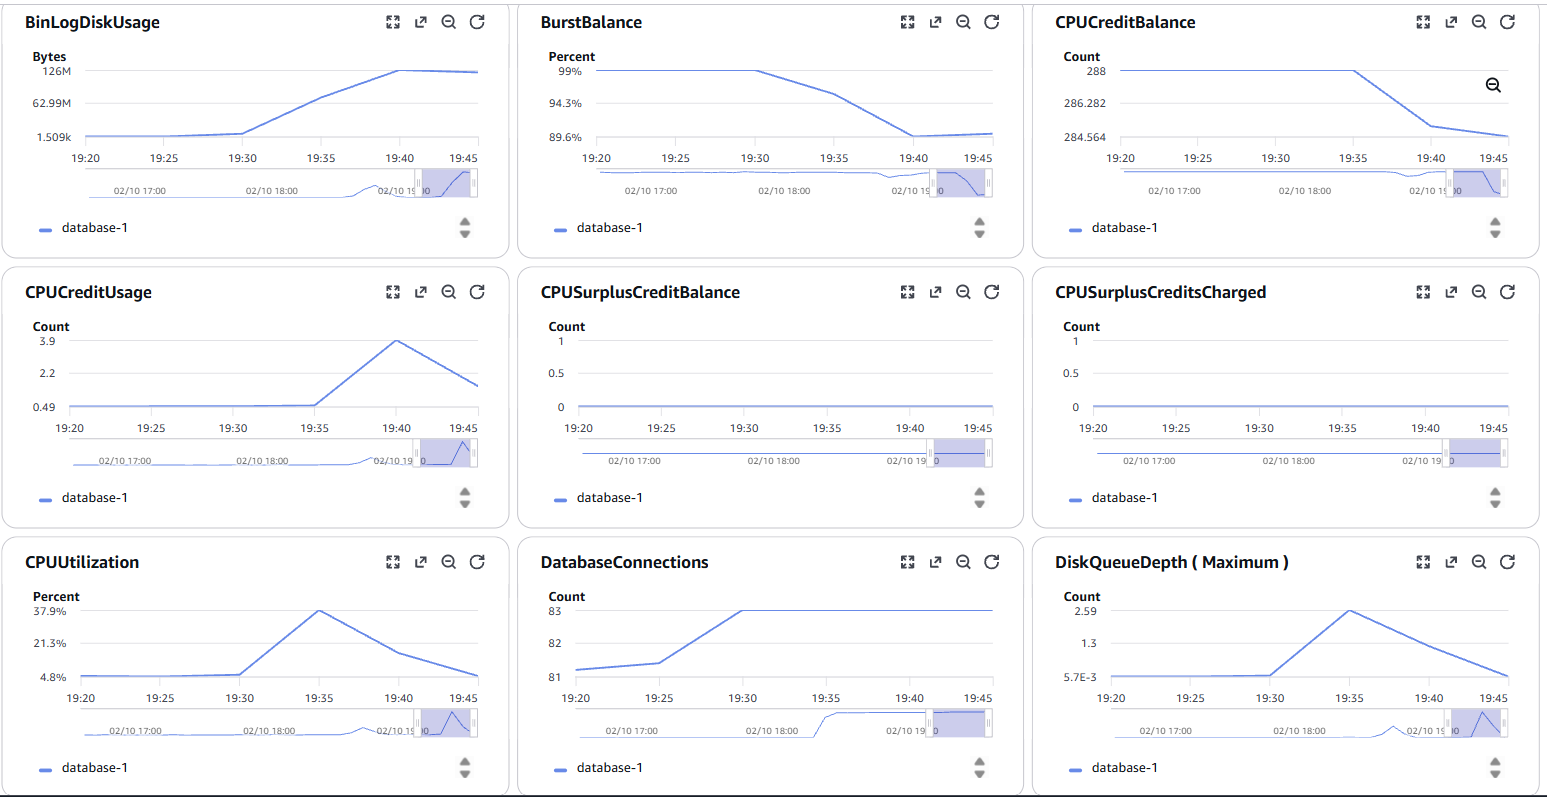
디스크와 CPU 크레딧 모두 여유가 있었고, 사용률도 포화와는 거리가 멀었습니다. DB 자원이 바닥나서 멈췄다고 보기는 어려웠습니다.
현재 가설은 배치 선점 쿼리가 원인일 가능성이 있습니다.
UPDATE outbox_event_entity SET claim_id = ?, claimed_at = ?, ...
WHERE sent = false AND (claim_id IS NULL OR claimed_at < ?)
ORDER BY created_at LIMIT 200
MySQL 기본 격리 수준(REPEATABLE READ)에서 범위 UPDATE는 스캔한 행과 그 사이 간격까지 잠급니다. 적체가 작으면 이 쿼리는 미발행 구간의 끝까지 스캔하고, 그 끝의 간격까지 잠그게 됩니다. 그런데 그 간격은 일정을 생성하는 모든 요청이 새 Outbox 행을 넣는 자리입니다. 잠금이 겹치는 동안 요청들이 커넥션을 쥔 채 기다리면, 두 서버의 풀이 한꺼번에 바닥날 수 있습니다. 이전 발행기는 잠그지 않는 SELECT와 PK 단건 UPDATE만 사용해 이런 범위 잠금이 없었습니다.
아직 가설입니다. 다음 측정에서는 커넥션이 고갈되는 순간 performance_schema.data_lock_wait 와 information_schema.innodb_trx를 조회해 실제로 누가 누구를 기다리는지 확인하려고 합니다.
3-8.원인 확인과 해결: 선점 트랜잭션의 격리 수준
3-7의 가설을 확인하는 방법은 두 가지였습니다. 첫번째는 커넥션이 고갈되는 순간 락 대기 상황을 조회하는 것과, 두번째는 원인으로 의심되는 부분만 바꿔서 다시 측정하는 것입니다. 락 조회는 고갈이 일어나는 몇 초 사이에 실행해야 하고, 테스트를 멈추면 락이 바로 풀려 아무것도 남지 않습니다. 그래서 의심되는 부분 하나만 바꾸고 같은 조건으로 다시 측정하기로 했습니다.
바꾼 것은 선점 트랜잭션의 격리 수준 하나입니다.
@Transactional(propagation = Propagation.REQUIRES_NEW, isolation = Isolation.READ_COMMITTED)
public List<OutboxEventEntity> claimBatch(String claimId, int limit, Duration staleAfter) { ... }
READ COMMITTED에서는 범위 UPDATE가 간격(gap)을 잠그지 않습니다. 또 아직 커밋되지 않은 행을 만나면 기다리지 않고 건너뜁니다. 건너뛴 행은 다음 주기에 선점됩니다. 그래서 새 Outbox 행이 들어가는 자리를 막지 않습니다. 이미 다른 실행이 선점한 행을 다시 가져가지 않는 것은 그대로입니다. 선점 조건(claim_id IS NULL OR claimed_at < 30초 전)은 커밋된 최신 값으로 다시 확인되기 때문입니다.
READ COMMITTED에서 InnoDB 쓰기를 하려면 binlog 형식이 ROW 또는 MIXED여야 합니다. 적용 전에 SHOW VARIABLES LIKE 'binlog_format'으로 ROW인 것을 확인했습니다.
나머지 코드와 테스트 조건(490VU, 램프업 120초, loop 100, think-time 1~5초)은 그대로 두고 다시 측정했습니다.

이번에는 끝까지 커넥션 대기가 0이었습니다. 4분 근처의 고갈도 다시 나타나지 않았습니다. 격리 수준 하나만 바꿨을 때 문제가 사라졌으므로, 선점 UPDATE의 범위 잠금이 원인이었다고 판단했습니다. 락 대기 표를 직접 캡처해 확인한 것은 아닙니다. "원인으로 의심한 부분만 바꿨더니 사라졌다"는 방식의 확인입니다.
3-9.최종 결과
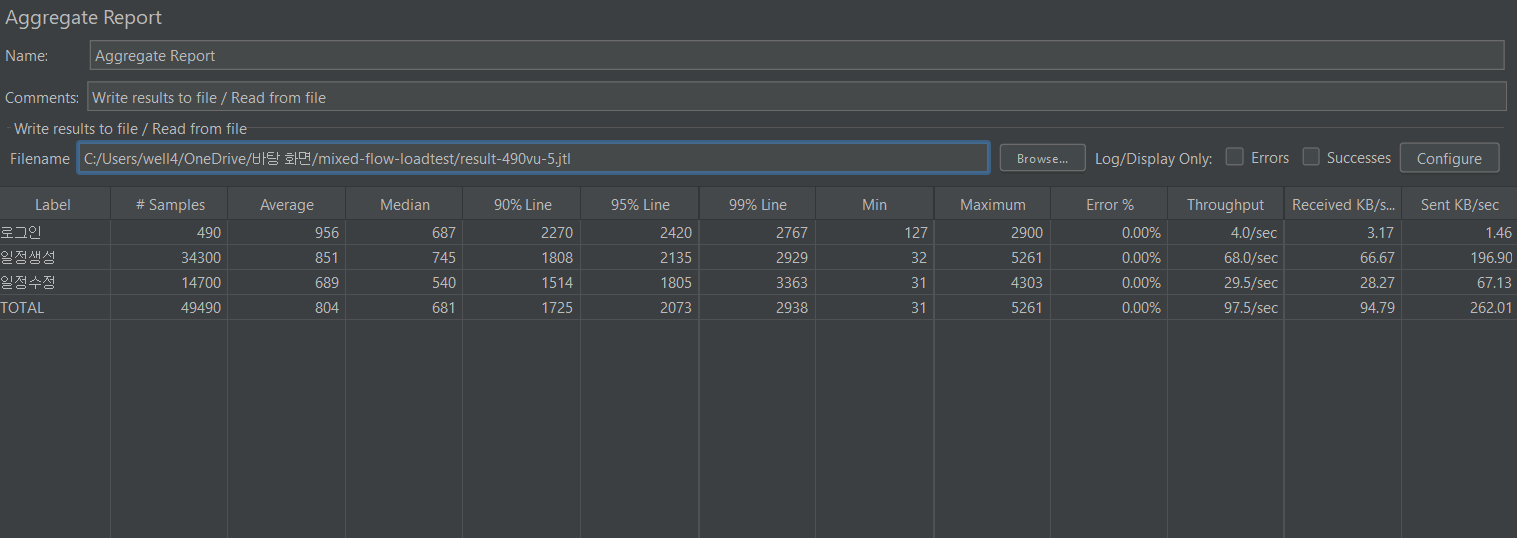
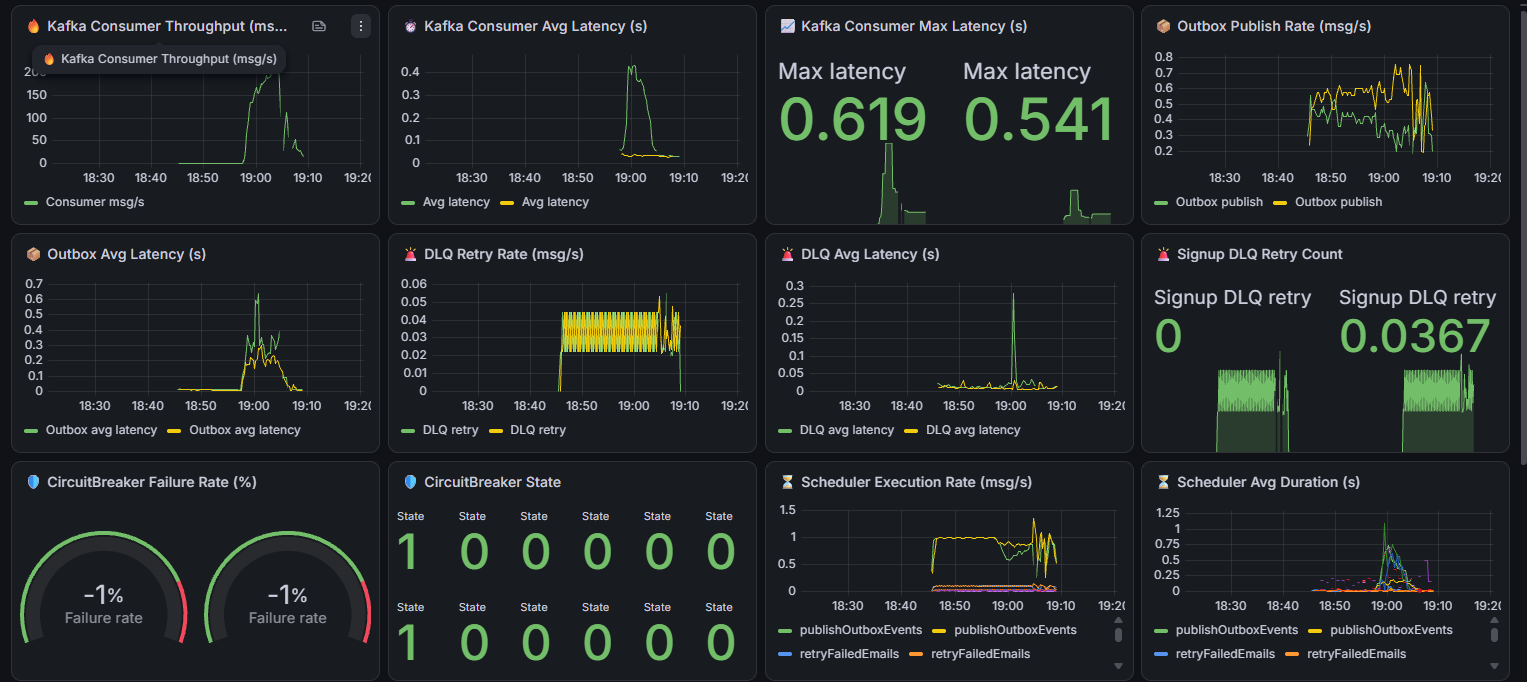
| 지표 | 건별 처리 | 개선 후 |
| 요청 수 / 에러율 | 49490 / 0.00% | 49490 / 0.00% |
| Outbox 적제 최대 | 약 25500건 | 약 200건 |
| 적체 해소 | 부하 종료 약 6분 뒤 | 부하 중에도 계속 해소 |
| Kafka 컨슈머 처리량 | 120~150 msg/s | 약200 msg/s |
| 리마인더 저장 | 0건 | 34300건 |
| HikariCP 대기 | 0 | 0 |
사후 정합성 검증 (테스트 계정 기준)
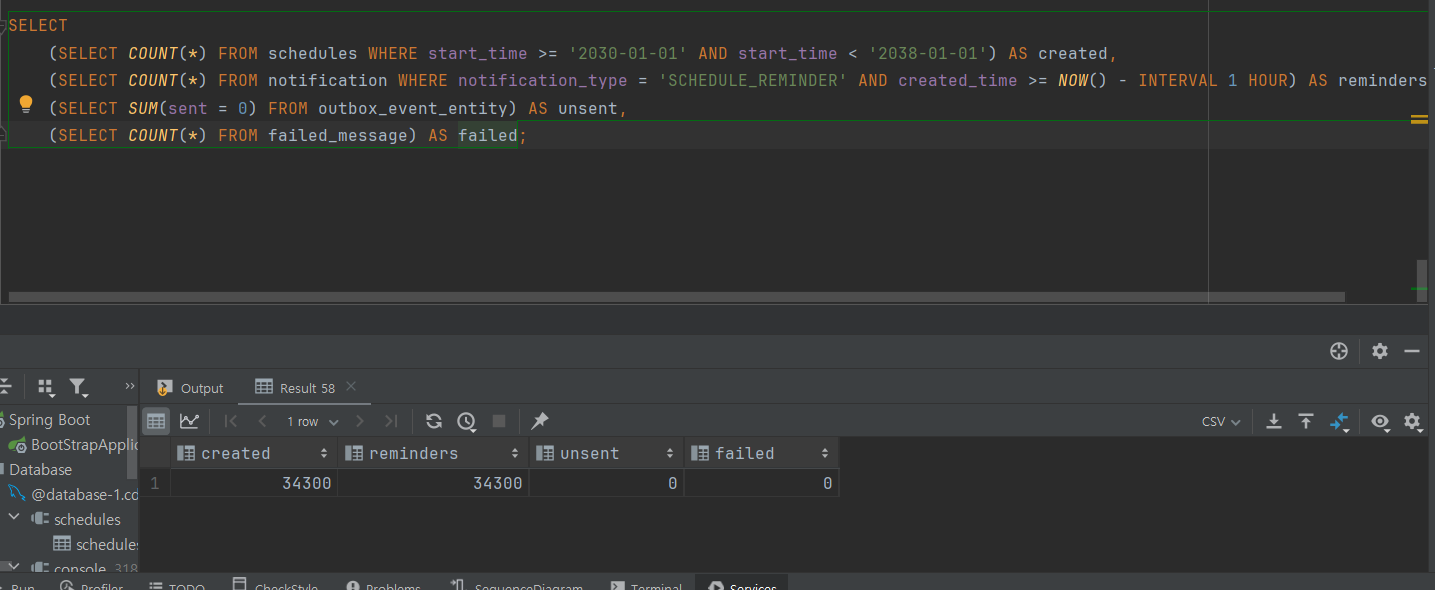
| 확인 | 기대 | 결과 |
| 일정생성 | 34300 (Jmeter 생성 요청 수) | 34300 |
| 리마인더 | 34300 (일정 1건당 1건) | 34300 |
| 미발행 Outbox | 0 | 0 |
| 재처리 대상(failed_message) | 0 | 0 |
처음 조회했을 때는 일정 34,092건, 미발행 33건이 나왔습니다. JMeter의 마지막 요청이 끝나기 전에 조회한 것이었고, 테스트가 끝난 뒤 다시 조회하자 위 값과 일치했습니다.
대신 API 응답 시간이 늘었습니다.
| 지표 | 개선전 | 개선후 |
| 평균 응답 | 65ms | 804ms |
| p95 / p99 | 142 / 469ms | 2073 / 2938ms |
| 전체 처리량 | 109.6 req/s | 97.5 req/s |
| HikariCP 사용 중 최대 | 약 8 / 40 | 약 38 / 40 |
커넥션 대기는 0이었지만, 커넥션 40개를 거의 다 쓰고 있었습니다. 풀이 모자라서 기다린 것이 아니라, DB 작업 하나하나가 느려져 커넥션을 오래 쥐고 있었다는 뜻입니다. 개선 전과 비교해 DB에 쓰는 양이 늘었습니다.
- 리마인더 INSERT가 처음으로 포함됐습니다. 개선 전에는 버그 때문에 저장되지 않고 있었습니다.
- 발행이 빨라지면서 컨슈머가 처리하는 이벤트가 늘었고, 알림 저장과 처리 기록 INSERT도 같은 DB에 그만큼 더 몰렸습니다.
두 요인 중 어느 쪽이 더 큰지는 아직 나눠서 측정하지 않았습니다. 발행 경로의 병목을 풀자, 그 부하가 DB 쓰기로 옮겨 간 것입니다.
4.결론
이번 테스트는 "실제 사용 패턴에서 서비스가 버티는가, 그리고 비동기 파이프라인이 따라오는가"를 확인하기 위한 것이었습니다.
- API는 490VU에서도 에러 없이 처리했습니다. 9월 30일 측정에서는 처리량이 Little's Law로 계산한 상한(약 160 req/s)에 도달했습니다. 개선 후 측정은 응답 시간이 0.8초로 늘어, 같은 식으로 계산한 상한도 약 129 req/s(490 ÷ 3.8초)로 낮아졌습니다.
- 비동기 파이프라인은 처음에는 따라오지 못했습니다. 건별 처리 발행기의 한계(초당 약 60~70건)로 적체가 25,500건까지 쌓였습니다. 배치 선점으로 바꾼 뒤에는 적체가 약 200건 안쪽에서 유지됐습니다.
- 이벤트는 한 건도 잃지 않았습니다. 테스트가 중간에 멈추고 서버를 내렸다 다시 켰을 때도, 남아 있던 이벤트를 재시작 후 다시 발행했습니다.
과정에서 배운 것은 세 가지입니다.
1. 병목은 사라지지 않고 옮겨 간다. 발행 병목을 풀자 DB 쓰기 부하가 드러났습니다. 성능 개선은 한 지점을 고치고 끝나는 일이 아니라, 다음 병목이 어디로 옮겨 가는지 확인하는 일이었습니다.
2. 고부하에서만 보이는 문제가 있다. AFTER_COMMIT 리스너에서 REQUIRES_NEW로 쓰면 요청 하나가 커넥션 두 개를 잡습니다. 범위 UPDATE는 REPEATABLE READ에서 간격까지 잠급니다. 두 문제 모두 90VU에서는 보이지 않았고, 490VU에서 처음 드러났습니다. 그래서 부수 작업은 "같은 트랜잭션" 아니면 "Outbox를 통한 비동기" 둘 중 하나로만 처리하기로 정했습니다.
3. 측정 조건부터 의심해야 한다. 리마인더가 저장되지 않던 버그 때문에, 9월 11일 이후의 부하 테스트는 모두 리마인더 INSERT가 빠진 상태였습니다. 숫자를 비교하기 전에 두 측정이 정말 같은 일을 하고 있었는지 먼저 확인해야 한다는 것을 배웠습니다.
다음 과제
- API 응답 시간 증가 원인 분리: 리마인더 INSERT와 컨슈머 처리량 증가 중 어느 쪽이 더 큰지 측정
- 리마인더 생성을 Outbox 이벤트로 옮겨, 메인 트랜잭션의 쓰기를 줄이는 방안 검토
- 컨슈머 동시성 조정 또는 처리 기록 쓰기 묶기
'포폴 > 일정관리 프로젝트 vol.02' 카테고리의 다른 글
| 분산 서버 전환 후 부하 테스트로 병목 구간 찾기6 (0) | 2026.09.14 |
|---|---|
| 분산 서버 전환 후 부하 테스트로 병목 구간 찾기5 (0) | 2026.09.13 |
| 분산 서버 전환 후 부하 테스트로 병목 구간 찾기4 (0) | 2026.09.11 |
| ContextSnapshot과 OTLP를 활용한 분산 추적(Distributed Tracing) 구축기 (0) | 2026.06.25 |
| 분산 서버 전환 후 부하 테스트로 병목 구간 찾기3 (0) | 2026.05.03 |


