
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | ||
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 13 | 14 | 15 | 16 | 17 | 18 | 19 |
| 20 | 21 | 22 | 23 | 24 | 25 | 26 |
| 27 | 28 | 29 | 30 |
- 코테
- 프로그래머스
- JPA
- 이것이 자바다
- CI/CD
- Join
- 연습문제
- Java
- 일정관리 프로젝트
- 데이터 베이스
- spring boot
- 알고리즘
- AWS
- SQL
- 일정관리프로젝트
- Kafka
- mysql
- LV02
- LV0
- nginx
- 포트폴리오
- JMeter
- docker
- Lv.0
- Redis
- LV03
- LV.02
- LV01
- 디자인 패턴
- CoffiesVol.02
- Today
- Total
코드 저장소.
분산 서버 전환 후 부하 테스트로 병목 구간 찾기6 본문
목차
1.지난 글의 문제점
2. 개선 방향 검토
3.적용
4.CAS 회귀 테스트
1.지난 글의 문제점
1-1. 재현 테스트에서 드러난 격차
5편에서 리마인더 DELETE 원인 수정과 테스트 데이터 정리를 마친 뒤 재현 테스트를 진행했고 결과는 기대 이상이었습니다.
| 지표 | 4차 | 5차 |
| Average | 1463ms | 278ms |
| Max | 5153ms | 1435ms |
| 에러율 | 0.00% | 0.00% |
| Throughput | 55.83/sec | 249.2/sec |
표를 보면 Average는 5배, Throughput은 4배 이상 개선되었습니다. 그런데 이 좋은 결과가 새로운 계산을 하나 요구했습니다.
생성 속도: 249.2건/초
폴러 이론상 드레인 속도: 33.3건/초 (3초마다 100건)
249.2 ÷ 33.3 ≈ 7.5배
생성 속도가 폴러 드레인 속도의 7.5배에 달했습니다. 폴러가 아무리 정상 작동해도, 애초에 이 정도로 빠르게 쏟아지는 이벤트를 다 소화할 수 없는 구조였습니다. 실제로 이번 재현 테스트에서 Outbox Pending Backlog는 최대 11000건까지 치솟았습니다.
1-2. 1차 테스트 때 기각했던 가설의 재부상
이 발견은 사실 완전히 새로운 게 아니었습니다. 1차 테스트 때 세웠다가 증거 부족으로 넘어갔던 가설이 있었습니다.
"90VU가 폴러의 이론상 드레인 한계(33.3건/초)보다 빠르게 이벤트를 만들어내면 못 따라갈 것이다"
당시엔 요청 실패율이 32.30%나 됐던 탓에, 실제 이벤트 생성 속도 자체가 이론적 드레인 한계 근처까지도 못 갔습니다. 그래서 이 가설은 검증할 조건조차 되지 않았고, 대신 DLQ 재시도와 트랜잭션 지연 쪽으로 원인이 옮겨갔습니다.
그런데 5편에 이르러 앞단 병목(트랜잭션 길이, 리마인더 DELETE, 충돌체크 COUNT)을 순차적으로 걷어내자, 역설적으로 시스템이 너무 빨라진 나머지 진짜로 이론적 드레인 한계를 훌쩍 뛰어넘는 속도로 이벤트를 만들어내기 시작했습니다. 앞단의 병목을 하나씩 없앨수록, 그 뒤에 가려져 있던 뒷단(폴러)의 진짜 처리 한계가 더 선명하게 드러나는 구조였습니다.
이번 편은 이 새로 드러난 문제 Outbox 폴러의 처리 용량 한계를 어떻게 다룰지에 대한 기록입니다.
2. 개선 방향 검토
2-1. 검토한 옵션 세 가지
폴러의 처리 용량을 늘리는 방법을 에이전트와 함께 세 가지로 좁혀봤습니다.
옵션 1 — 락(claim)과 발송 상태 갱신을 벌크로 묶기
지금 구조는 이벤트 하나당 최소 두 번의 개별 트랜잭션이 나갑니다. "락 시도"(tryLockEvent)와, Kafka 콜백에서의 "발송 완료 처리"입니다. 이걸 배치 단위로 묶으면 이렇게 바뀝니다.
-- 1) 후보 조회 (1번)
SELECT id FROM outbox_event WHERE sent=false ORDER BY retry_count, created_at LIMIT 300;

-- 2) 조회된 ID들을 한 번에 락 (벌크, 1번)
UPDATE outbox_event SET retry_count = retry_count + 1
WHERE id IN (:ids) AND sent = false;

-- 3) Kafka 발송은 그대로 개별 루프 (DB 부하와 무관)

-- 4) 성공한 것만 모아서 한 번에 완료 처리 (벌크, 1번)
UPDATE outbox_event SET sent = true, sent_at = NOW() WHERE id IN (:successIds);
이러면 이벤트가 몇 건이든 DB 트랜잭션은 틱당 딱 3번으로 고정됩니다. 지금처럼 이벤트 수에 비례해서 트랜잭션 수가 늘어나는 구조 자체를 없애는 것이라, 파라미터 튜닝보다 훨씬 근본적이고 예측 가능합니다. @SchedulerLock이 이미 "한 번에 하나의 인스턴스만 실행"을 보장하고 있으니 동시성 걱정도 추가로 할 필요가 없습니다.
다만 설계상 짚어야 할 지점이 하나 있습니다. send()는 whenComplete 기반 비동기입니다. 즉 3번(발송) 루프가 끝나는 시점엔 아직 어떤 이벤트가 성공했는지 알 수 없다는 점입니다. 그래서 4번(벌크 완료 처리) 전에 이번 배치의 모든 콜백이 끝날 때까지 명시적으로 기다리는 지점이 필요합니다.
CompletableFuture.allOf(futures.toArray(new CompletableFuture[0])).join();
// 이 시점에서야 successIds가 확정된다
ShedLock으로 어차피 다음 틱까지 다른 인스턴스가 못 들어오니, 이 정도의 대기는 안전하고 예측 가능한 선택입니다.
옵션 2 폴러를 여러 워커로 병렬화
SELECT ... FOR UPDATE SKIP LOCKED 패턴으로 여러 스레드나 인스턴스가 서로 겹치지 않게 다른 행을 동시에 가져가게 하는 방식이다. 옵션 1보다 스케일이 더 나오지만, 그만큼 설계가 복잡해집니다.
옵션 3 CDC (Debezium)
이건 이전 병목처리 글에서도 생각을 해봤던 방법입니다. 지금 문제(개별 트랜잭션이 이벤트 수만큼 반복되는 N+1 구조)는 옵션 1로 충분히 풀리는 문제라고 판단이 들었고, CDC까지 도입하는 건 여전히 오버스펙으로 판단해 배제했습니다.
2-2. 왜 파라미터 튜닝부터 시도하는가
옵션 1이 가장 근본적인 해법이라는 데는 이견이 없습니다. 하지만 바로 큰 리팩토링으로 가지 않고, 그보다 훨씬 싼 방법부터 먼저 시도하기로 했습니다. 이유는 "진짜 한계가 파라미터(주기·배치 크기)에 있는지, 아니면 개별 트랜잭션이 이벤트 수만큼 반복되는 구조 자체에 있는지"부터 구분해야 했기 때문입니다.
tryLockEvent는 각자 트랜잭션을 열고 쿼리,커밋하는 구조라서, 이벤트 하나 처리에 넉넉잡아 5~10ms만 걸려도 300개면 1.5~3초가 걸립니다. 배치 크기(limit)를 무작정 키우면서 주기(fixedDelay)를 그대로 두면, 그 배치 하나를 처리하는 시간 자체가 새로운 병목이 되어 이론상 계산(limit ÷ fixedDelay)대로 나오지 않을 수 있습니다.
그래서 1단계로 다음 조합을 먼저 시도하기로 했습니다.
@Scheduled(fixedDelay = 1000)  // 3000 → 1000
public void publishOutboxEvents() {
    List<OutboxEventEntity> events = outboxEventService.getPendingEvents(200);  // 100 → 200
    ...
}
@SchedulerLock(lockAtLeastFor = "PT500MS") // 기존 PT2S에서 단축
이론상 드레인 속도는 200건 ÷ 1초 = 200건/초로, 실제 생성 속도(249.2건/초)에 근접한다.
판정 기준은 다음과 같이 정했습니다.
- 이 조합으로 재현 테스트를 돌려서 Outbox Backlog가 안정적으로 유지가 된다면 파라미터 튜닝으로 충분했던 것이고 옵션 1(벌크 처리)까지 가지 않아도 됩니다.
- 여전히 쌓인다면 파라미터 문제가 아니라 개별 트랜잭션이 이벤트 수만큼 반복되는 구조 자체가 진짜 천장이라는 뜻이므로, 그때 옵션 1로 넘어간다.
3.적용
3-1. 파라미터 수정
@Scheduled(fixedDelay = 1000)  // 3000 → 1000
public void publishOutboxEvents() {
    List<OutboxEventEntity> events = outboxEventService.getPendingEvents(200);  // 100 → 200
    ...
}

@SchedulerLock(lockAtLeastFor = "PT500MS")  // 기존 PT2S에서 단축
이론상 드레인 속도는 200건 ÷ 1초 = 200건/초로, 실제 생성 속도(249.2건/초)에는 못 미치지만 근접한 수치였다. 변경을 한 내용을 토대로 측정을 해보겠습니다.
3-2. 측정
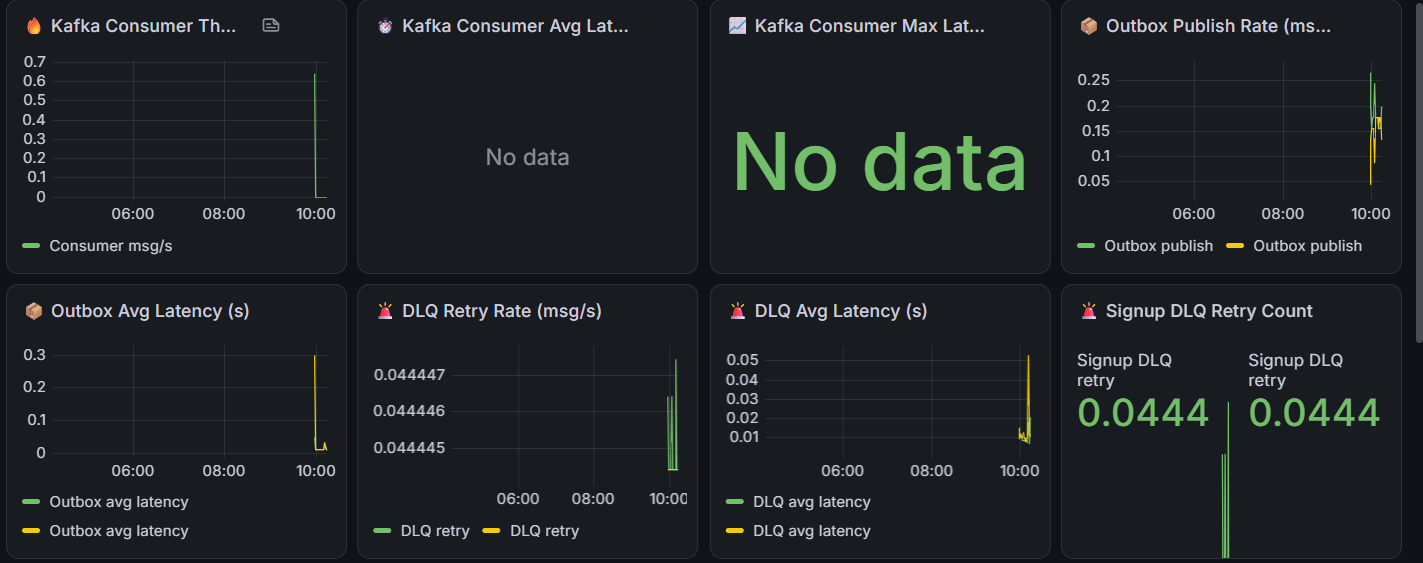
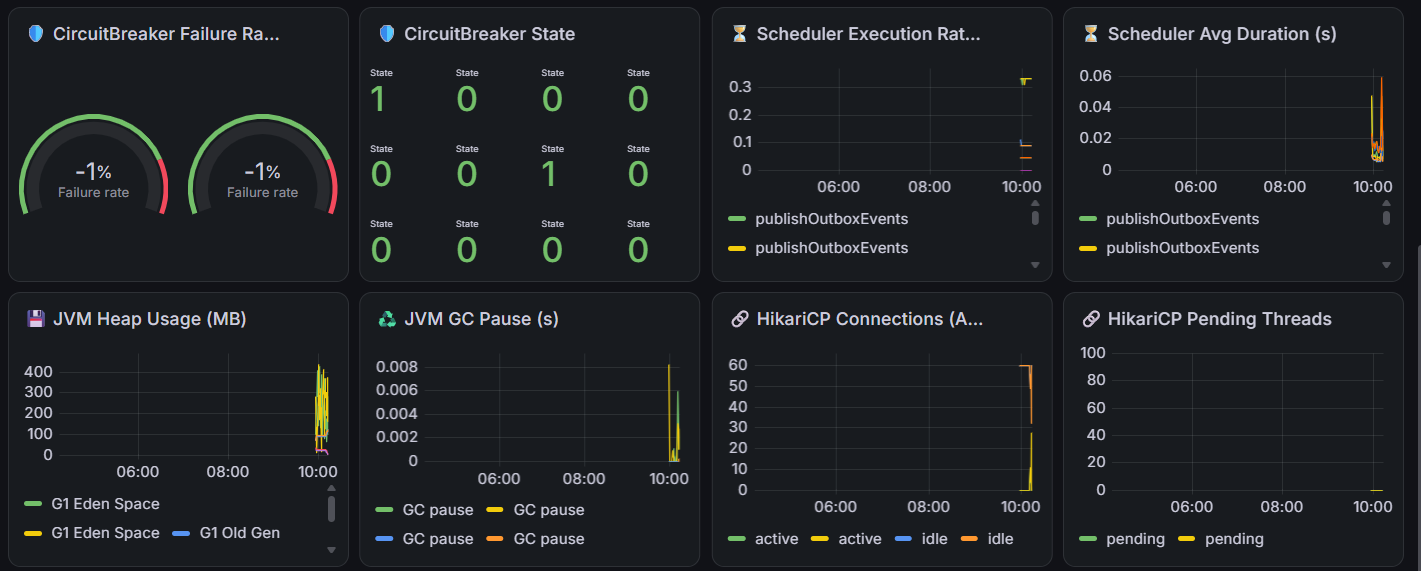
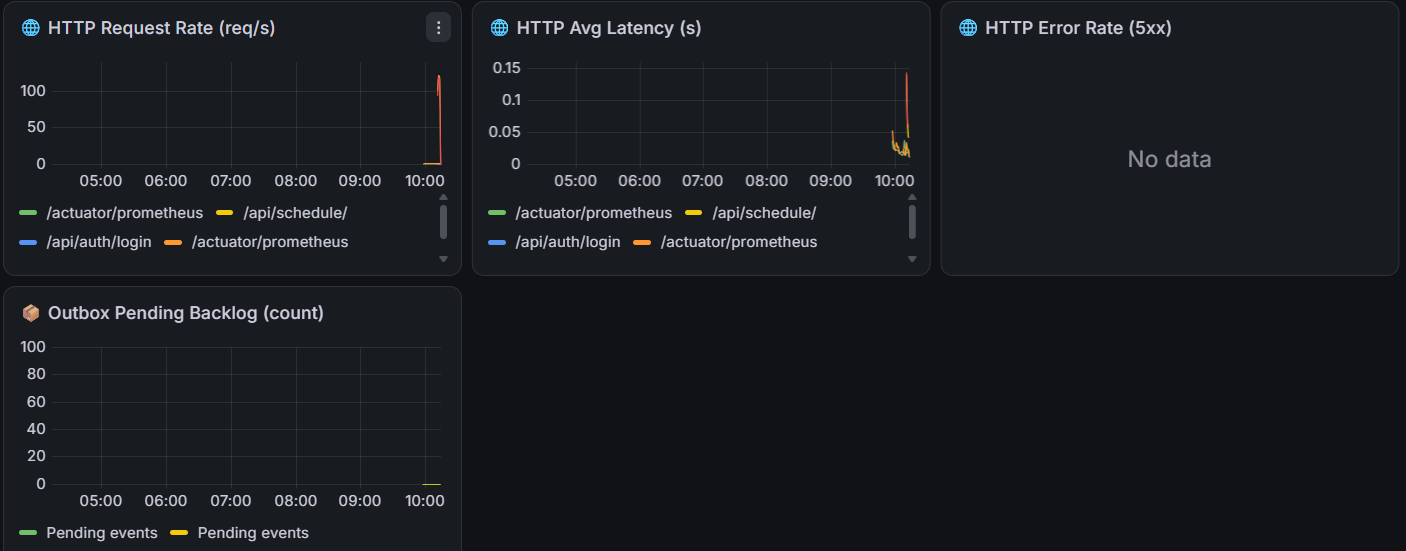
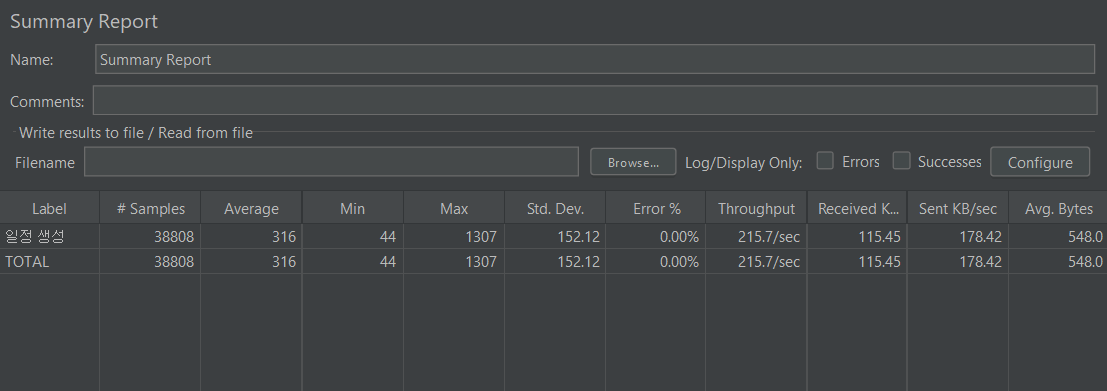
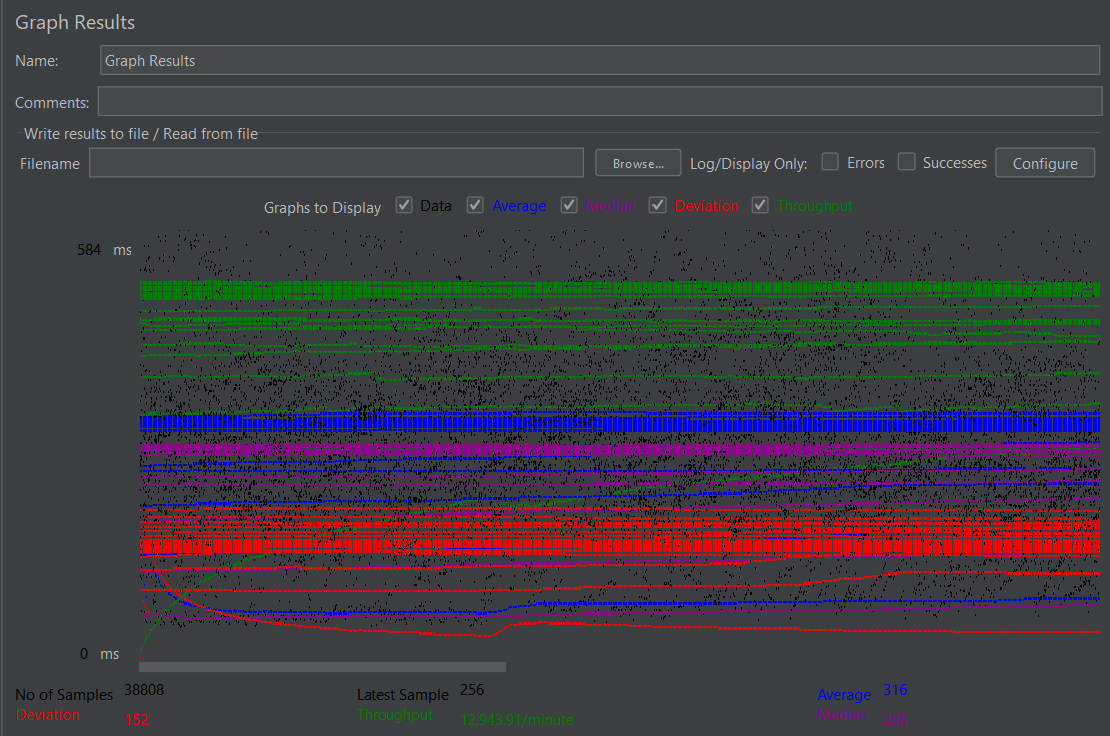
결과는 아래와 같습니다.
| 지표 | 개선전 | 개선후 |
| Samples | 44749 | 38808 |
| Average | 278ms | 316ms |
| Max | 1435ms | 1307ms |
| 에러율 | 0.00% | 0.00% |
| Throughput | 249.2/sec | 215.7/sec |
| Outbox Pending Backlog (최대) | 11,000건 | ~100건 |
| Scheduler Avg Duration (최대) | - | 0.06초 |
Backlog가 11,000건에서 100건대로, 100분의 1 이하 수준으로 줄었습니다. Scheduler Avg Duration도 fixedDelay(1초)의 10분의 1도 안 되는 0.06초 안에서 여유 있게 끝났고 폴러가 밀리는 징후가 전혀 없었습니다.
3-3. 판정
세워뒀던 판정 기준대로면, Backlog가 안정적으로 유지됐으니 옵션 1(벌크 UPDATE)로 넘어갈 필요가 없었다. 개별 트랜잭션 구조 자체가 천장이 아니라, 단순히 주기와 배치 크기가 그 시점의 트래픽에 비해 보수적으로 잡혀 있었을 뿐이었습니다.
Throughput이 249.2 → 215.7로 소폭 낮아진 점은, 폴러 압박이 줄면서 시스템 전체가 더 안정적인 균형점을 찾은 결과로 해석했습니다.
에러율과 Average/Max Latency는 5편 수준을 그대로 유지했습니다. 가장 큰 리팩토링 비용(개별 트랜잭션을 벌크로 묶는 작업, 그리고 그 과정에서 필요했던 CompletableFuture 기반 동기화)을 들이지 않고도 문제를 해결했다는 점에서, "싼 것부터 시도한다"는 접근이 이번에도 유효했습니다.
4. CAS 회귀 테스트
4-1. 조건 원복
지금까지 3~5편을 거치며 조건을 여러 차례 조정해왔다. 328번 글의 원래 베이스라인과 직접 비교하려면, 그때와 같은 조건으로 되돌려야 한다.
| HikariCP maximum-pool-size | 60 | 40 |
| HikariCP connection-timeout | 15초 | 15초 (변경 없음) |
| nginx proxy_read_timeout | 60초 (3편에서 진단 목적으로 상향) | 10초 |
| Outbox 폴러 fixedDelay/limit | 1000ms / 200 (이번 편에서 개선) | 그대로 유지 (CAS + 개선 사항 전체 검증이 목적이므로) |
nginx와 pool은 328번 조건으로 되돌리되, CAS와 이번 편의 개선사항(리마인더, 충돌체크, 폴러 튜닝)은 그대로 남겨둔다. 이번 테스트의 목적이 "CAS 도입 이전과 이후, 같은 인프라 조건에서 얼마나 달라졌는가"를 보는 것이기 때문이다.
4-2. 328번 글 베이스라인
| 처리량 | 84.3 TPS |
| 에러율 | 8.04% |
| 평균 응답시간 | 1,225ms |
| 붕괴 시점 | 테스트 시작 후 약 1분 37초 |
| 99% Line Latency | 10,040ms |
4-3. 재현 결과
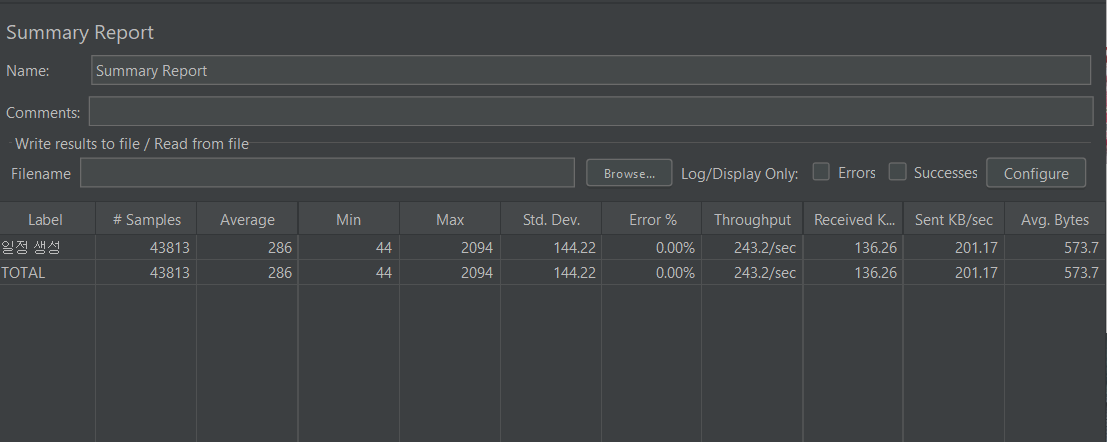
| 지표 | CAS 도입전 | 이번(조건 원복) |
| 처리량 | 84.3 TPS | 243.2/sec |
| 에러율 | 8.04% | 0.00% |
| 평균 응답시간 | 1,225ms | 286ms |
| 붕괴 여부 | 1분 37초에 붕괴 | 붕괴 없음 |
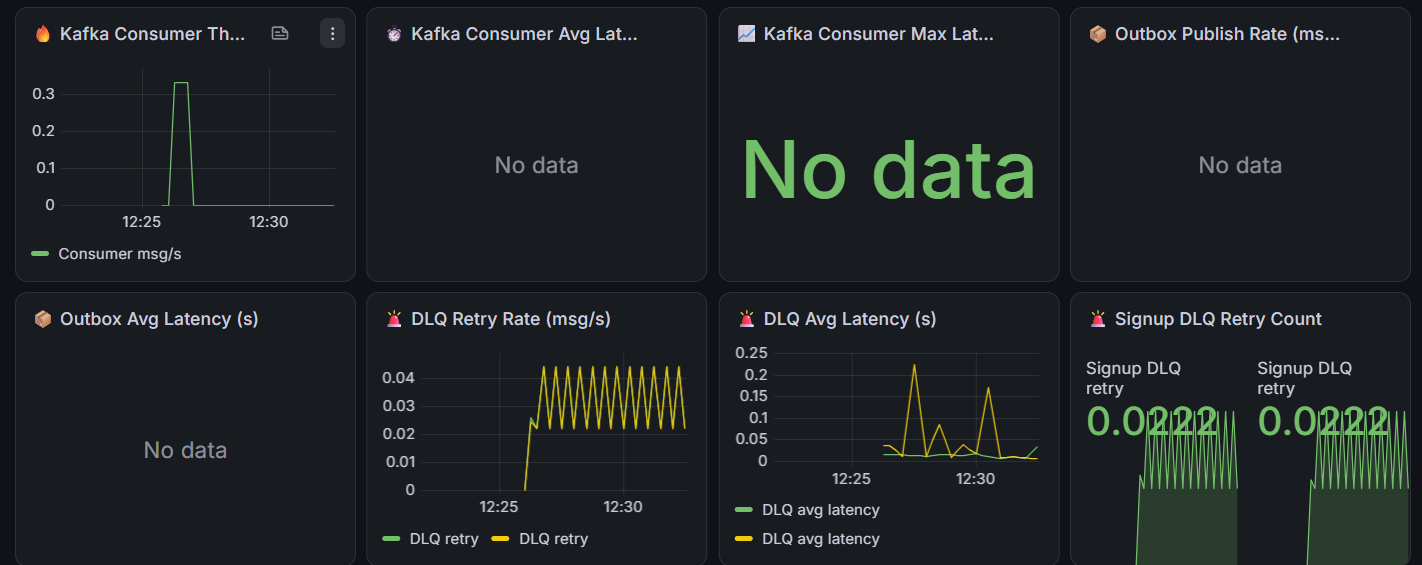
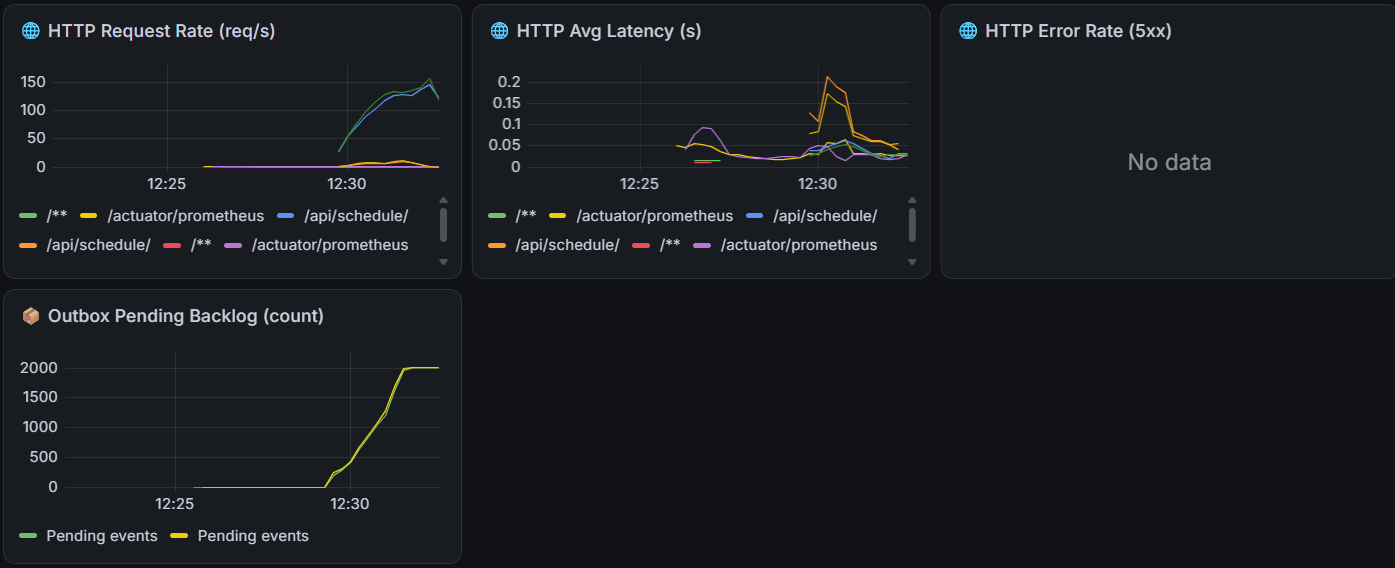
숫자만 보면 압도적으로 개선된 결과였다. 그런데 Outbox Pending Backlog가 걸렸다. 재현 테스트를 돌려봤는데 backlog가 적체된 채로 그래프가 내려오지 못하고 계속 정체된 모습을 보여줬다. 테스트가 끝난 뒤에도 시간이 한참 지나도록 이 값이 그대로였습니다.
4-4. 원인을 Prometheus로 소거
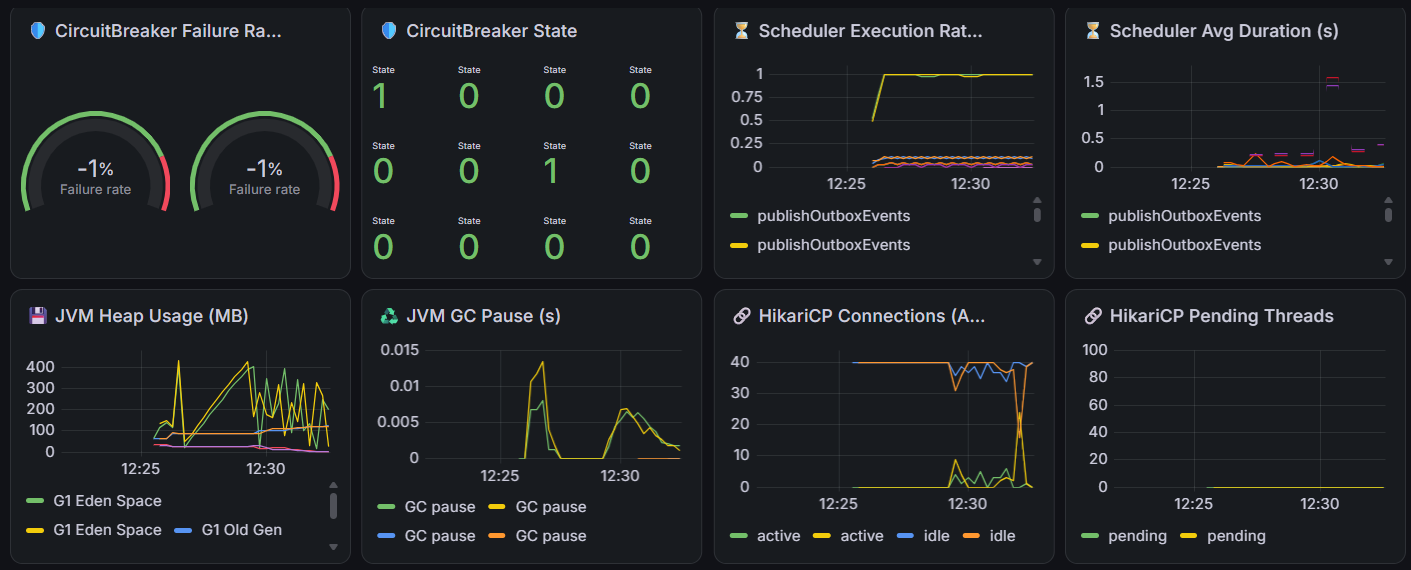
우선은 backlog의 적체의 원인을 찾아보기 위해서 의심이 되었던 부분은 커넥션 풀과 폴러 부분이었다. 우선은 커넥션 풀 부분부터 프로메테우스로 확인을 해보기로 했습니다.
1) 커넥션 풀
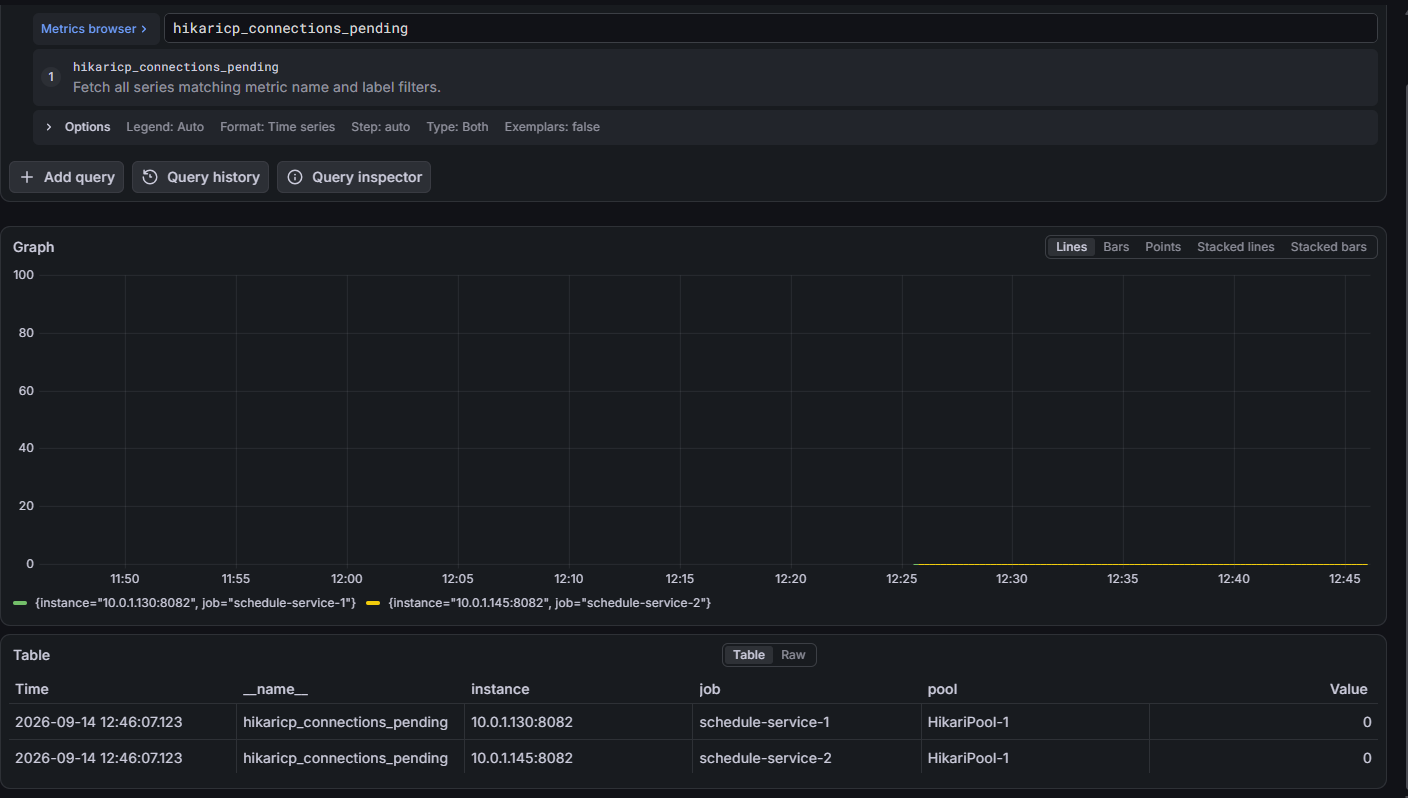
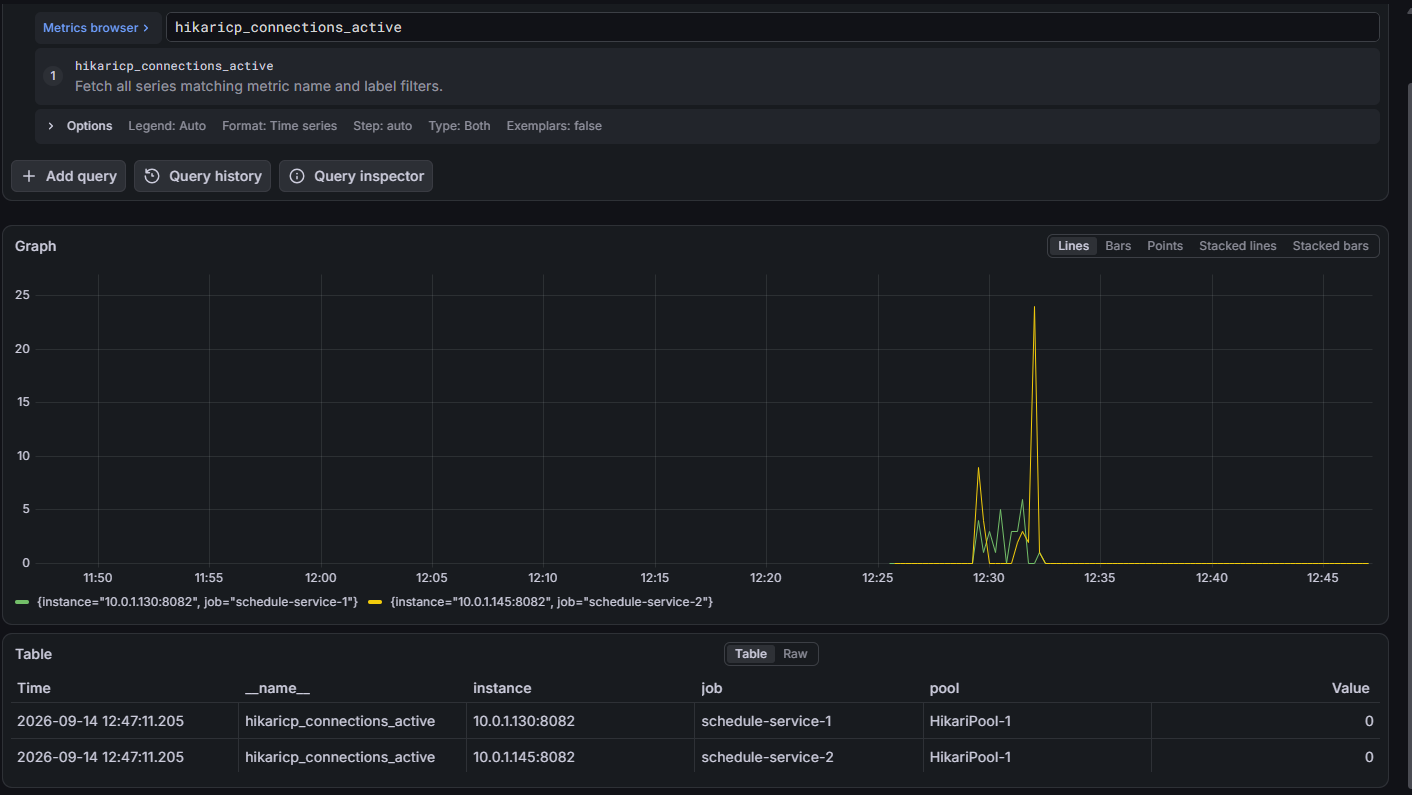
지금(테스트 종료 후) 커넥션 경합은 전혀 없었다. pool을 40으로 줄이면서 폴러가 커넥션을 못 얻고 있는 게 아닌가했던 의심은 거두었습니다.
2) 폴러
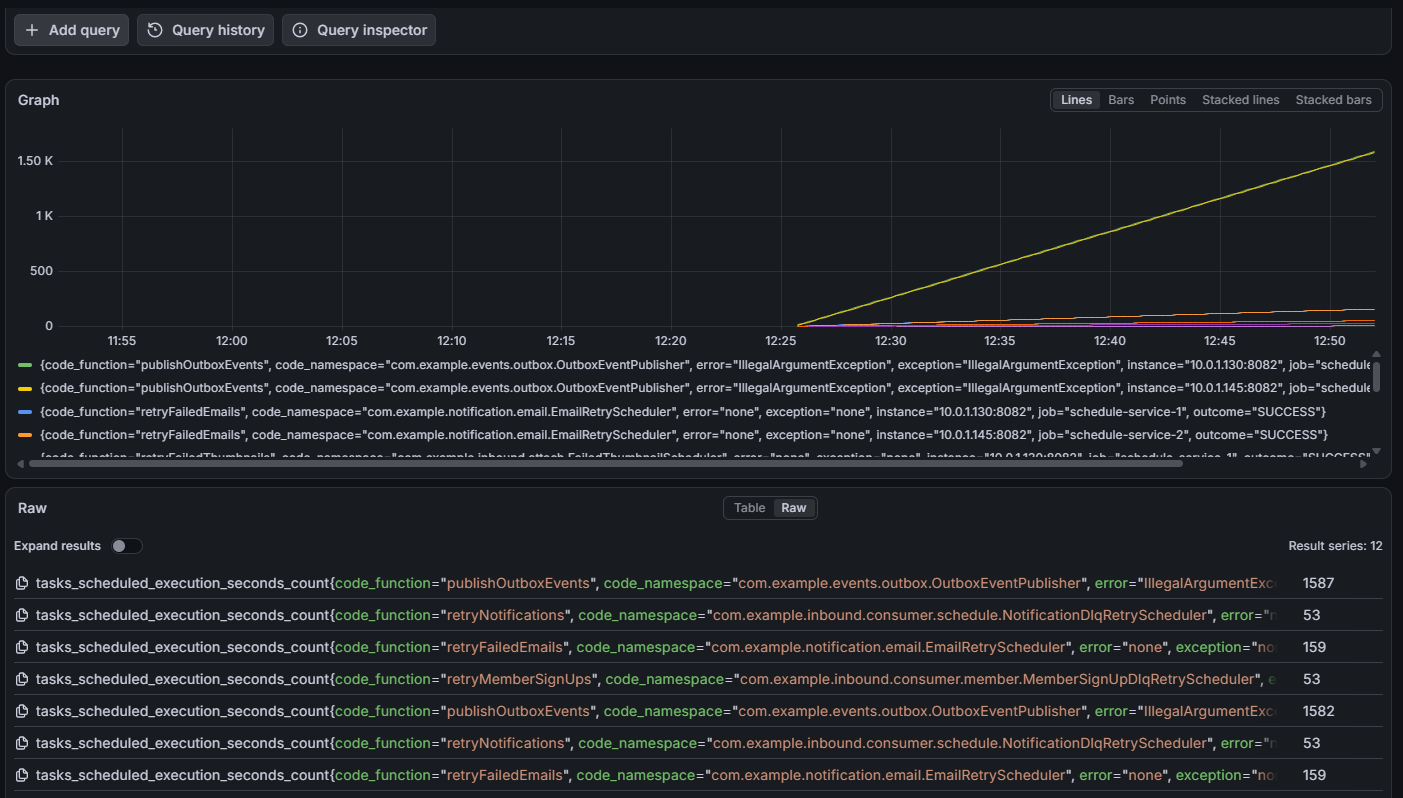
publishOutboxEvents의 실행 카운터를 확인하니, 두 인스턴스 모두 계속 증가하고 있었습니다. 즉 스케줄러 자체는 죽지 않고 계속 실행되고 있었습니다. 다만 라벨을 자세히 보니 전부 error="IllegalArgumentException"이 붙어 있었습니다. 폴러는 1초마다 계속 시도하지만, 매번 예외를 던지며 실패하고 있었던 것이다. 이게 backlog가 안 빠지는 이유였습니다.
4-5. Loki 로그로 정확한 원인 확인
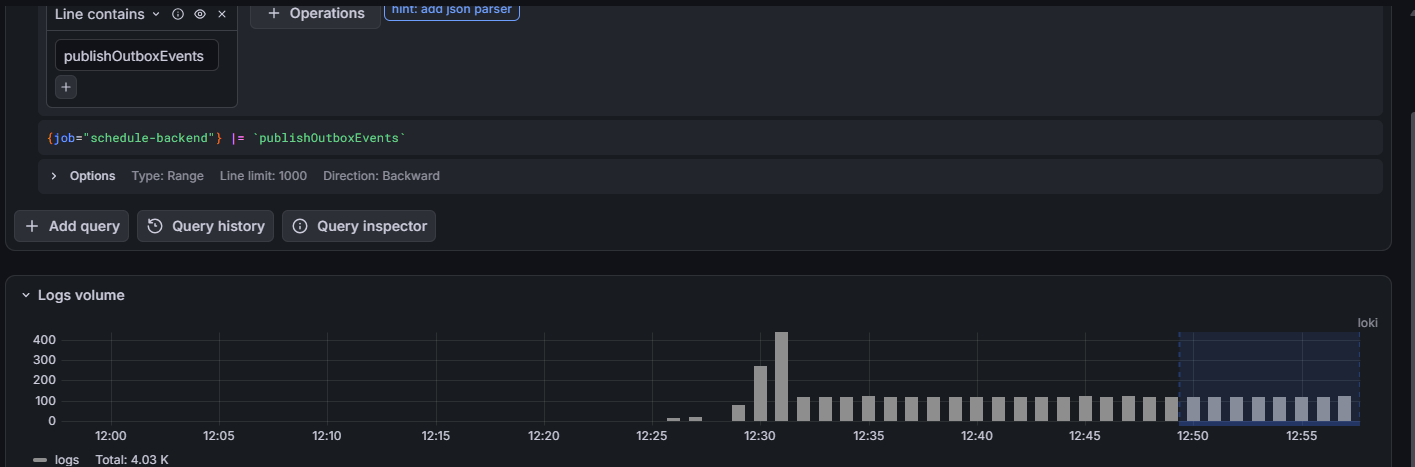
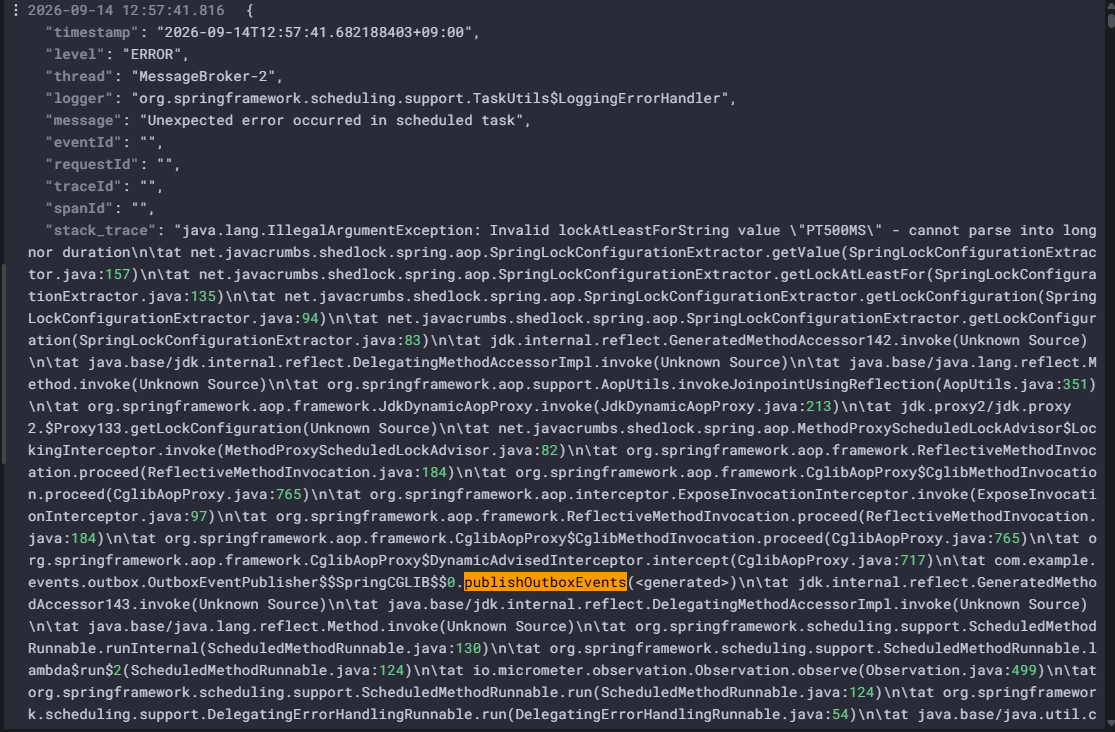
폴러 파라미터를 튜닝하며 아래처럼 설정했던 부분이 원인이었습니다.
@Scheduled(fixedDelay = 1000)
@SchedulerLock(name = "OutboxPublisherLock", lockAtMostFor = "PT10M", lockAtLeastFor = "PT500MS")
ShedLock의 lockAtLeastFor/lockAtMostFor는 두 형식만 지원합니다.
- 순수 밀리초 숫자 (예: "500")
- ISO-8601 Duration의 초 단위 표기 (예: "PT0.5S")
PT500MS처럼 밀리초(MS) 단위 표기는 ISO-8601 Duration 표준 자체에는 존재하지만, ShedLock의 파서가 지원하는 범위 밖이었다. lockAtMostFor = "PT10M"(분 단위)은 문제없이 파싱됐지만, PT500MS는 파싱에 실패하며 매 실행마다 예외를 던지고 있었습니다.
이 버그로 인해 폴러 파라미터가 실제로는 한 번도 정상 동작한 적이 없었을 가능성이 있습니다. 즉 "파라미터 튜닝만으로 충분했다"고 내렸던 결론이, 실제로는 다른 이유(그 시점의 실제 부하가 이론상 한계보다 낮았던 것 등)로 우연히 좋게 나왔을 가능성을 배제할 수 없었고 이 부분은 수정 후 재검증이 필요했습니다. 수정은 간단했습니다.
@SchedulerLock(name = "OutboxPublisherLock", lockAtMostFor = "PT10M", lockAtLeastFor = "500")
수정 후 배포하고, 밀려있던 backlog가 정상적으로 빠지는지 확인한 뒤 회귀 테스트를 다시 진행하기로 했습니다.
4-6. 최종 회귀 테스트 결과
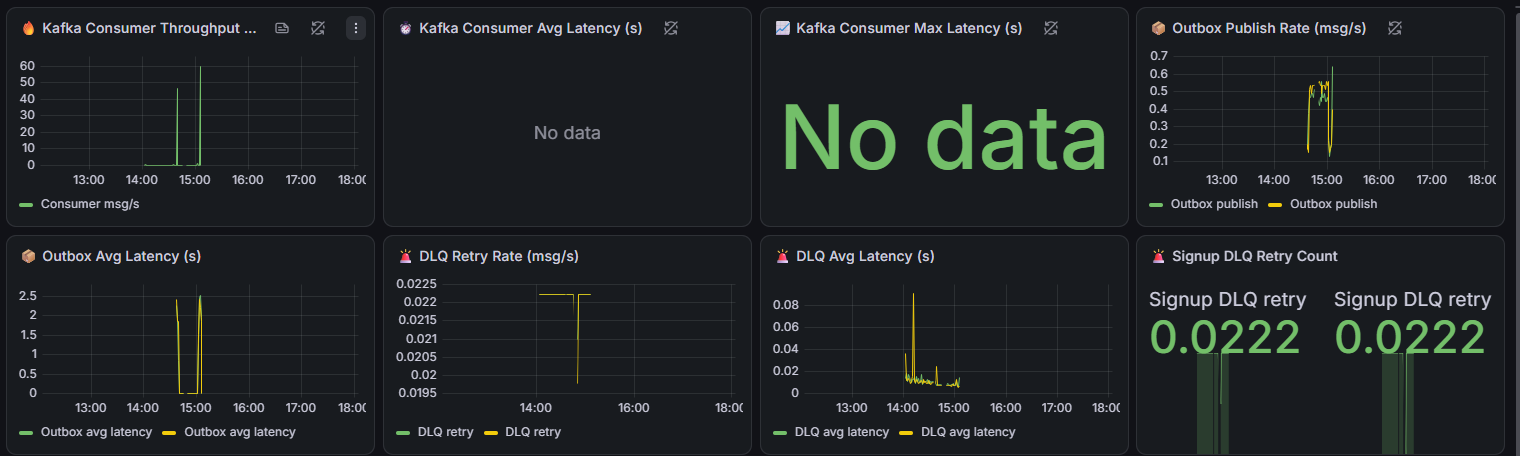
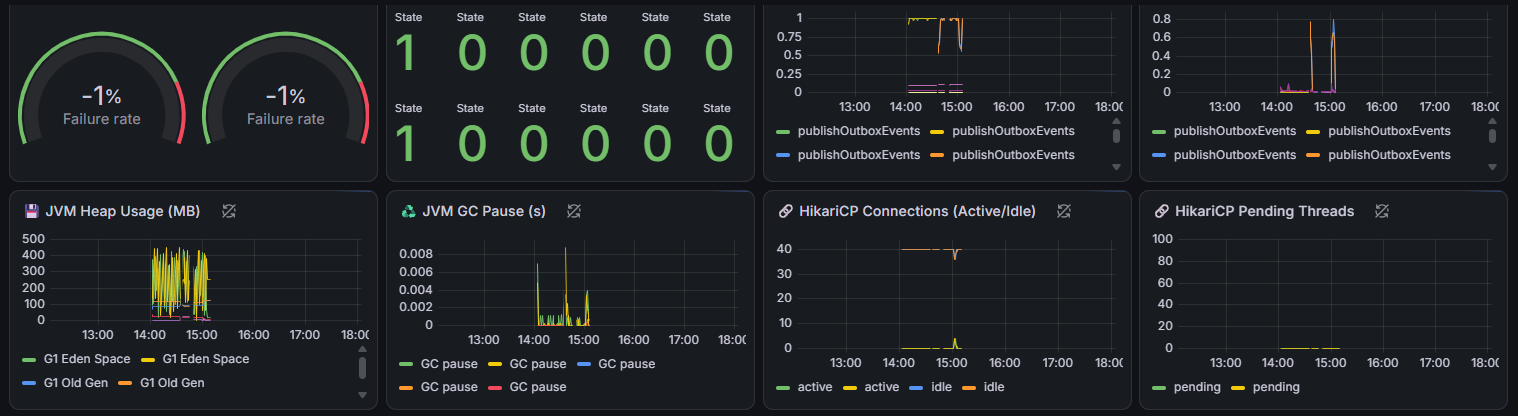
배포 상태를 digest로 확정하고, 밀려있던 backlog가 정상적으로 처리되는 것까지 확인한 뒤, 테스트 데이터(schedules 테이블의 member_id=1)를 정리하고 90VU 회귀 테스트를 다시 진행했습니다.
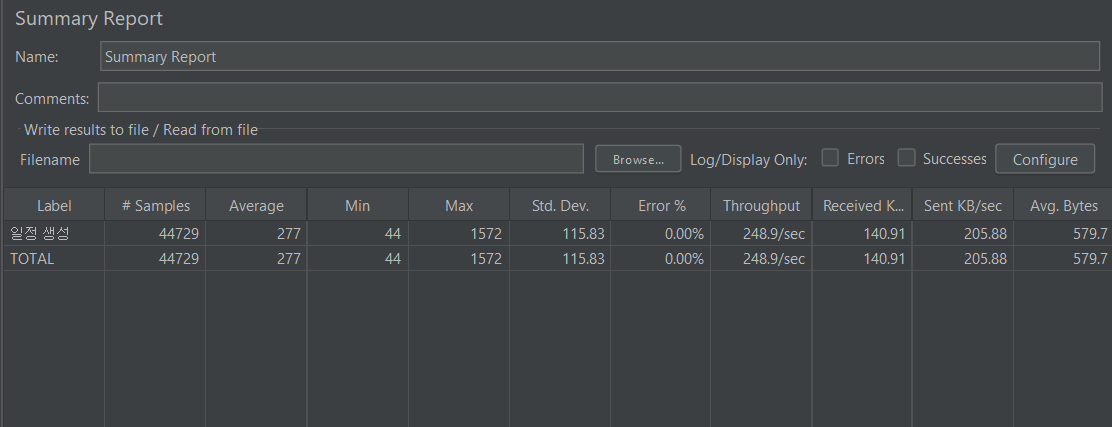
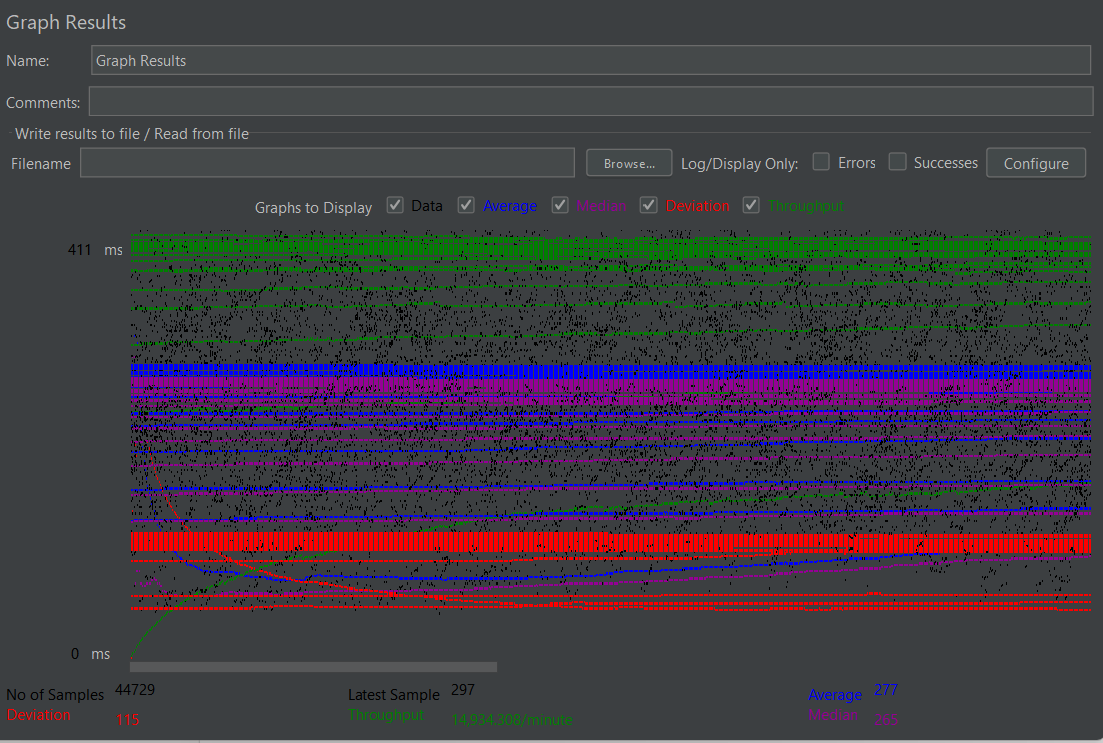

| 지표 | CAS 도입전 | 최종 회귀 테스트 |
| Samples | 5934 | 44,729 |
| 처리량 | 84.3 TPS | 248.9/sec |
| 에러율 | 8.04% | 0.00% |
| 평균 응답시간 | 1,225ms | 277ms |
| Max Latency | 10107ms | 1,572ms |
| 붕괴 시점 | 1분 37초 | 붕괴 없음 |
Outbox Pending Backlog는 테스트 도중 순간적으로 0→2,000건까지 쌓였지만, 이번엔 그대로 다시 0으로 완전히 수렴했습니다. 폴러 버그가 고쳐진 뒤 밀린 이벤트를 정상적으로 소화해낸다는 걸 실제로 확인한 것입니다.
4-7. 최종 결론
CAS 기반 원자적 UPDATE 도입, 그리고 뒤이은 트랜잭션 구조 개선, 리마인더·충돌체크 쿼리 최적화, Outbox 폴러 파라미터 튜닝까지 거친 결과, 같은 인프라 조건(pool 40, connection-timeout 15초, nginx read timeout 10초)에서 이전의 90vu에서의 붕괴 임계점을 완전히 넘어섰습니다.
- 처리량: 84.3 → 248.9 TPS (약 3배)
- 에러율: 8.04% → 0.00%
- 평균 응답시간: 1,225ms → 277ms (약 4.4배)
- 1분 37초에 발생하던 붕괴: 재현되지 않음
이 시리즈는 328번 글에서 던진 하나의 질문 "CAS 기반 원자적 UPDATE가 Outbox 재처리 경합을 실제로 없앴는가" 에서 출발했습니다. 그 답을 얻기까지 여러 겹의 다른 문제(트랜잭션 길이, nginx의 조용한 failover, 리마인더 로직, 인덱스 방향, 테스트 데이터 누적, 폴러 처리 한계, 그리고 이번 편의 ShedLock 설정 오류와 배포 확인 절차)를 거쳐야 했지만, 최종적으로 9월 한 달치 실데이터 감사와 이번 회귀 테스트를 통해 답을 확인했습니다.
'포폴 > 일정관리 프로젝트 vol.02' 카테고리의 다른 글
| 분산 서버 전환 후 부하 테스트로 병목 구간 찾기5 (0) | 2026.09.13 |
|---|---|
| 분산 서버 전환 후 부하 테스트로 병목 구간 찾기4 (0) | 2026.09.11 |
| ContextSnapshot과 OTLP를 활용한 분산 추적(Distributed Tracing) 구축기 (0) | 2026.06.25 |
| 분산 서버 전환 후 부하 테스트로 병목 구간 찾기3 (0) | 2026.05.03 |
| 카프카의 복구 과정을 측정 - ISR 테스트 (0) | 2026.05.02 |


