
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | ||
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 13 | 14 | 15 | 16 | 17 | 18 | 19 |
| 20 | 21 | 22 | 23 | 24 | 25 | 26 |
| 27 | 28 | 29 | 30 |
- CoffiesVol.02
- 일정관리프로젝트
- 일정관리 프로젝트
- 포트폴리오
- LV0
- CI/CD
- LV.02
- LV03
- spring boot
- 프로그래머스
- docker
- AWS
- Java
- LV02
- Join
- JPA
- SQL
- nginx
- LV01
- 데이터 베이스
- 알고리즘
- 디자인 패턴
- 연습문제
- 코테
- Kafka
- Lv.0
- 이것이 자바다
- Redis
- mysql
- JMeter
- Today
- Total
코드 저장소.
분산 서버 전환 후 부하 테스트로 병목 구간 찾기5 본문
목차
1. 지난 글에서의 재검토와 원인 분석
2. 검증
3.결론
1. 지난 글에서의 재검토와 원인 분석
3차 결과, 다시 들여다보기
3차 테스트에서 에러율은 32.30% → 6.13% → 0.0%까지 떨어졌습니다. 트랜잭션 길이를 줄인 조치(인덱스 추가, 카테고리 캐싱, 리마인더 AFTER_COMMIT 분리)가 정확히 목표했던 효과를 냈고, 붕괴 패턴도 더 이상 관측되지 않았습니다.
그런데 이 좋은 소식 뒤에 새로운 문제가 숨어 있었습니다. Outbox Pending Backlog가 0 → 약 900건까지 급등한 것입니다. 1, 2차에서는 backlog가 최대 75건 정도까지만 튀었던 걸 감안하면, 확연히 다른 규모였습니다.
같은 시간대 Scheduler Avg Duration도 폴러 1회 실행당 최대 7.5초까지 치솟았습니다. 원래 @Scheduled(fixedDelay = 3000)으로 3초 주기여야 하는데, 실행 자체에 7.5초가 걸리면 실질 주기는 (7.5초 실행 + 3초 대기) = 10.5초가 됩니다. 이 경우 실질 드레인 속도는 이론치 33.3건/초가 아니라 100건 ÷ 10.5초 = 9.5건/초로 3배 이상 떨어지고, 900건을 이 속도로 처리하면 약 95초(1분35초)가 걸린다는 계산이 나옵니다. 다행히 backlog는 완전히 멈추지 않고 스파이크 형태로 다시 0까지 떨어졌습니다.
그럼 왜 지금 와서 문제가 되었을까요?
원인을 추론하기 전에 먼저 짚어야 할 게 있습니다. 지금까지의 조치들은 전부 "HTTP 요청 하나하나가 얼마나 빨리, 실패 없이 끝나느냐"를 겨냥한 것이었고, 그건 완벽하게 성공했습니다. 그런데 그 성공이 역설적으로 새로운 부하를 만들어냈습니다. 1, 2차에서는 32%, 6%의 요청이 실패하면서 애초에 outbox에 쌓일 이벤트 자체가 덜 만들어졌습니다. 이번엔 실패가 0%가 되면서 거의 모든 요청이 outbox row를 남겼고, 그만큼 폴러가 감당해야 할 이벤트 양이 늘어난 것입니다.
앞단(HTTP/트랜잭션)의 병목을 없애니, 그동안 실패로 가려져 있던 뒷단(Outbox 폴러 → Kafka 발행)의 처리 용량 한계가 처음으로 수면 위에 드러났습니다.
우선 publishOutboxEvents() 폴러 코드를 다시 봤습니다.
// OutboxEventPublisher
@Scheduled(fixedDelay = 3000)
@SchedulerLock(name = "OutboxPublisherLock", lockAtMostFor = "PT10M", lockAtLeastFor = "PT2S")
public void publishOutboxEvents() {
    List<OutboxEventEntity> events = outboxEventService.getPendingEvents(100);

    for (OutboxEventEntity event : events) {
        if (outboxEventService.tryLockEvent(event.getId())) {
            outboxEventSender.send(event);   // Kafka 비동기 발행 (whenComplete, 논블로킹)
        }
    }
    outboxDlqProcessor.process(events);
}

// OutboxEventService
@Transactional
public boolean tryLockEvent(String id) {
    int updatedRows = outboxEventRepository.tryLockAndIncrement(id);
    return updatedRows > 0;
}
인스턴스 간 폴러 경합 (배제한 가설)
가장 먼저 의심했던 건 "두 인스턴스의 폴러가 동시에 같은 배치를 긁어가며 경합하는 것"이었습니다. 인스턴스가 2대이니 자연스러운 의심이었습니다. 하지만 코드에 이미 @SchedulerLock(name = "OutboxPublisherLock", ...)이 걸려 있었습니다. ShedLock으로 다중 인스턴스 환경에서 이 스케줄러는 항상 한 인스턴스에서만 실행되도록 보장되고 있었기 때문에, 이 가설은 코드로 바로 기각됐습니다.
100번의 개별 트랜잭션 (진짜 의심되는 부분)
tryLockEvent()에 @Transactional이 개별로 붙어 있다는 점이 눈에 띄었습니다. publishOutboxEvents() 자체는 트랜잭션이 없고, 그 안에서 100건을 순회하며 매번 tryLockEvent()를 호출하는 구조입니다. Spring AOP 프록시 특성상, 이건 호출할 때마다 새 트랜잭션을 열고 커밋한다는 뜻입니다.
즉 폴러가 한 번 실행될 때(100건 기준), 커넥션 체크아웃이 100번 일어나는 구조입니다. send() 자체는 whenComplete 콜백 기반이라 논블로킹이라 for 루프를 막지 않지만, 그 앞의 tryLockEvent() — CAS UPDATE 한 건씩 — 이 100번 순차 반복되는 게 문제였습니다.
사실상 N+1과 같은 패턴입니다. 평상시엔 개별 UPDATE가 워낙 빨라서(수 ms) 100번 반복해도 티가 안 났지만, 3차에서 앞단 트랜잭션 병목을 없애고 나니 DB 자체가 전체적으로 더 바빠졌습니다. 스케줄 생성 처리량이 실제로 늘어났고, 그 상황에서 100개의 개별 트랜잭션 각각이 HikariCP 풀을 두고 90VU의 HTTP 요청들과 커넥션을 다투게 되었습니다. 매번 조금씩만 지연돼도(예: 평균 75ms) 100번이 누적되면 75ms × 100건 = 7.5초가 되고, 이는 관측된 Scheduler Avg Duration 스파이크와 정확히 맞아떨어지는 수치입니다.
이번 편에서 검증할 가설은 다음과 같았습니다.
폴러가 100건을 처리할 때, CAS UPDATE를 건별 트랜잭션으로 순차 실행하는 구조가 커넥션 획득 대기를 100배로 누적시켜 폴러 실행 시간을 7.5초까지 늘렸다.
2. 검증
2-1.슬로우 쿼리 로그 세팅
가설을 직접 확인하기 위해 AWS RDS 파라미터 그룹에서 슬로우 쿼리 로그를 켰습니다.
slow_query_log = 1
long_query_time = 0.05  (50ms)
log_output = TABLE
개별 CAS UPDATE(tryLockAndIncrement)는 정상 상황이면 PK 단건 조회로 몇 ms 안에 끝나야 하는 쿼리입니다. 만약 가설이 맞다면, 이 UPDATE들이 50ms 기준에 다수 걸려 나와야 합니다.
2-2.4차 측정

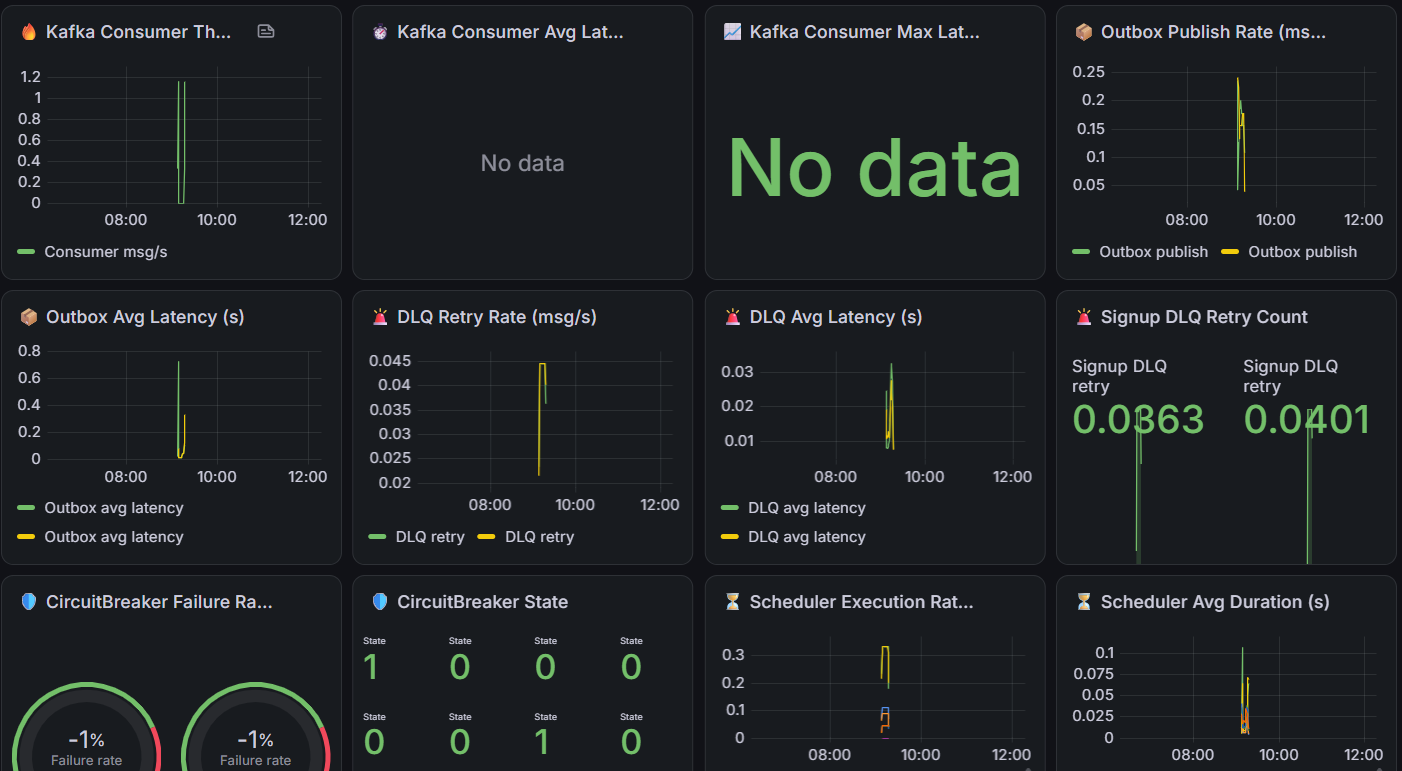
Aggregate Report부터 보면, Samples 10105, Average 1463ms, Max 5153ms, 에러율 0.00%, Throughput 55.8/sec였습니다. 흥미로운 지점은 Max Latency입니다. 3차(19512ms)의 4분의 1 수준으로 떨어졌는데, 이건 조건이 달라져서가 아니라 이번 실행에서는 그 정도로 심하게 몰린 순간 자체가 적었기 때문으로 보입니다.
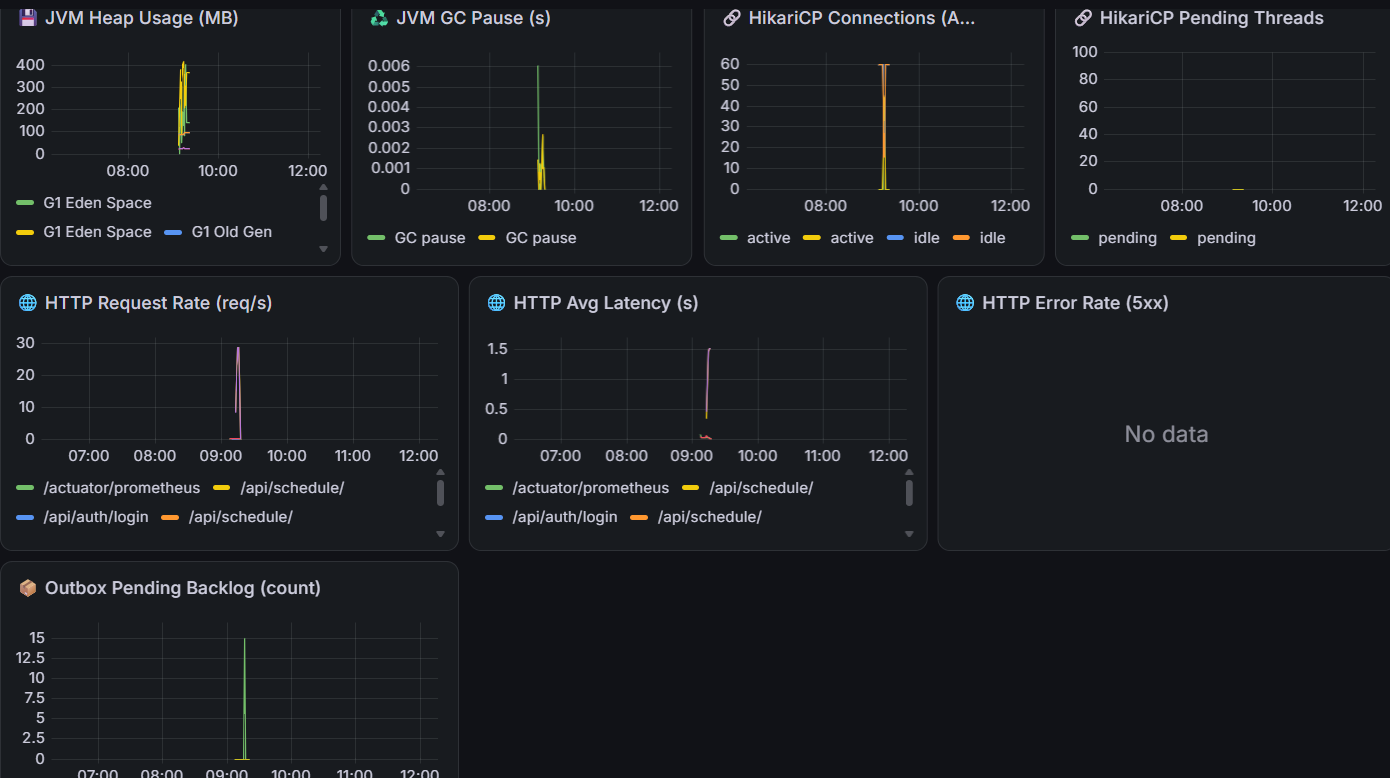
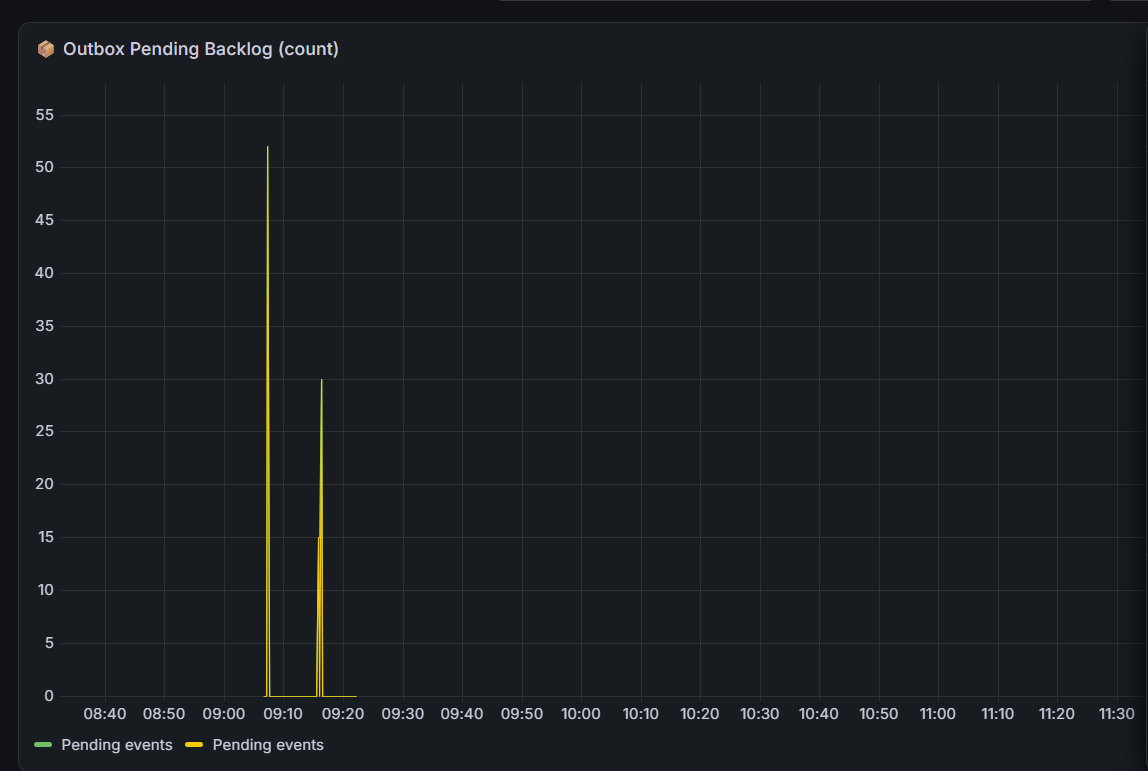
실제로 Outbox Pending Backlog를 보면 이번엔 최대 52건 정도까지만 튀었습니다(3차의 900건과 비교하면 훨씬 완만한 규모입니다). 같은 맥락에서 Scheduler Avg Duration도 최대 0.1초 안팎이었고, 3차에서 봤던 7.5초짜리 스파이크는 이번엔 재현되지 않았습니다.
이 지점이 처음엔 살짝 혼란스러웠습니다. "폴러가 100번의 개별 트랜잭션 때문에 느려진다"는 가설을 검증하려고 슬로우 쿼리 로그까지 켜놓은 상황인데, 정작 폴러 실행 시간 자체는 이번엔 정상 범위였기 때문입니다. 하지만 뒤이어 슬로우 쿼리 로그에서 확인했듯, 이번 실행에서 문제가 된 건 폴러 구조가 아니라 리마인더 DELETE와 충돌체크 COUNT라는 개별 쿼리 두 개였습니다. 즉 3차 때 관측된 7.5초짜리 폴러 지연은 그 순간 우연히 여러 부하가 겹친 결과였을 가능성이 높고, 이번처럼 폴러 자체는 멀쩡한 상황에서도 다른 두 쿼리가 각각 2~3초씩 걸리는 문제는 그대로 재현됐다는 점이 오히려 "폴러 구조 자체는 범인이 아니다"라는 결론을 한 번 더 뒷받침해줍니다.
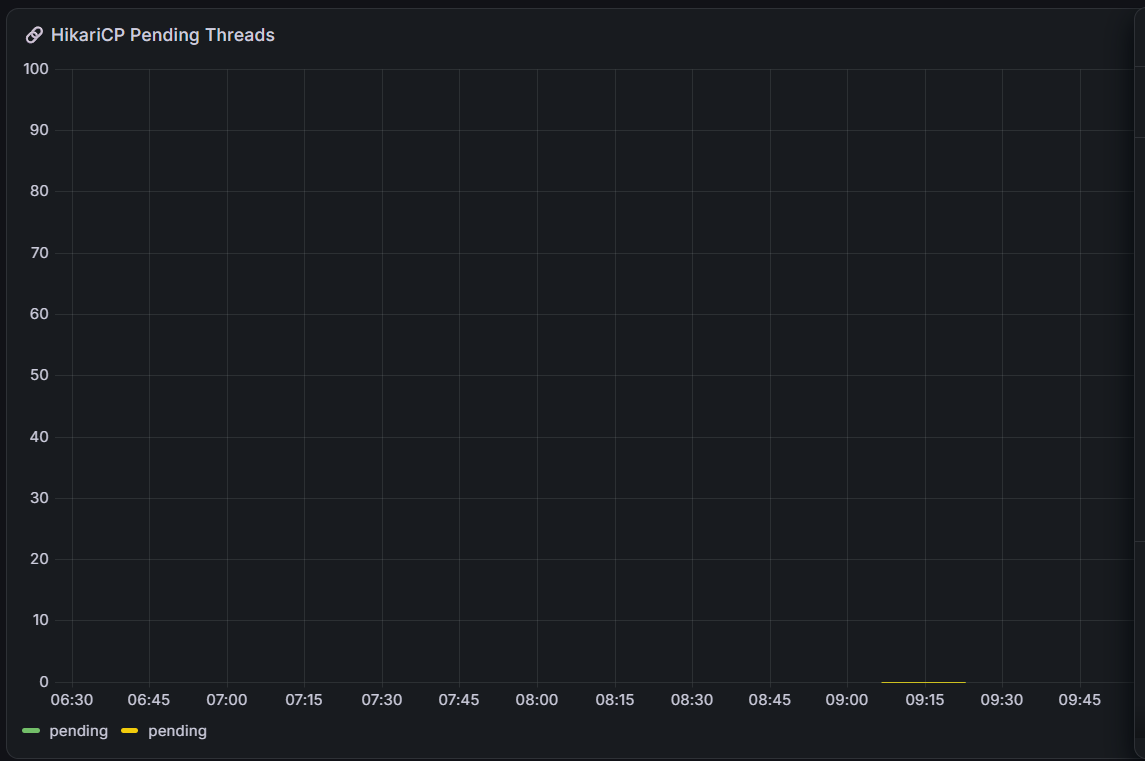
HikariCP 쪽을 보면, Active Connections가 순간적으로 풀 상한(60)까지 치솟긴 했지만 Pending Threads는 시종일관 0에 가까웠습니다. 커넥션이 부족해서 대기가 발생한 게 아니라, 커넥션은 확보했는데 그 안에서 실행되는 쿼리 자체(DELETE, COUNT)가 오래 걸렸다는 그림과 일치합니다. DLQ Retry Count나 CircuitBreaker Failure Rate도 특별한 이상 없이 평소 수준을 유지했습니다.
정리하면, 이번 측정에서 시스템 전반의 지표(에러율, 붕괴 여부, 커넥션 풀)는 안정적이었지만, 그 안에 숨어있던 두 개의 느린 쿼리는 여전히 살아있었다는 게 이 대시보드가 보여주는 그림입니다. 정확히 무엇이 느렸는지는 슬로우 쿼리 로그에서 확인했습니다.
2-1에서 세운 조건대로, 동일 조건(90VU)으로 재현 테스트를 진행한 뒤 mysql.slow_log를 조회했습니다.
SELECT start_time, query_time, sql_text
FROM mysql.slow_log
ORDER BY query_time DESC
LIMIT 30;
내역을 보니깐 tryLockAndIncrement 관련 UPDATE는 단 한 건도 나오지 않았습니다. 세워뒀던 가설인 "CAS UPDATE를 건별 트랜잭션으로 순차 실행하는 구조가 커넥션 획득 대기를 누적시켰다" 는 이 시점에서 기각해야 했습니다. 대신 슬로우 쿼리 상위 30건을 확인해본 결과 전혀 다른 두 종류의 쿼리로 채워져 있었습니다.
내역을 확인해보니 tryLockAndIncrement 관련 UPDATE는 단 한 건도 나오지 않았습니다. 세워뒀던 가설 — "CAS UPDATE를 건별 트랜잭션으로 순차 실행하는 구조가 커넥션 획득 대기를 누적시켰다" — 은 이 시점에서 기각해야 했습니다. 대신 슬로우 쿼리 상위 30건을 확인해본 결과, 전혀 다른 두 종류의 쿼리로 채워져 있었습니다.
1) 리마인더 DELETE, 2.6~3.2초
delete from notification where schedule_id=25635 and notification_type='SCHEDULE_REMINDER'
이런 쿼리가 여러 건, 각각 2.6~3.2초씩 걸린 채로 잡혀 있었습니다. 원인은 이미 알고 있던 곳에 있었습니다. ReminderNotificationService.createReminder()는 여전히 "생성 시점에도 우선 DELETE부터 실행"하는 기존 구조를 쓰고 있었습니다. 지난 글에서 "생성/수정 메서드 분리"를 검토했지만 우선순위에서 밀려 보류 상태로 남겨뒀던 항목인데, 이번 슬로우 로그가 그게 실제로 느리다는 것을 직접 증거로 보여준 셈입니다.
2) 일정 충돌체크 COUNT, 1.7~2.6초
select count(s1_0.id) from schedules s1_0
where s1_0.member_id=1 and s1_0.is_deleted_scheduled=0
and s1_0.start_time<'2026-05-29 00:07:00' and s1_0.end_time>'2026-05-28 23:07:00'
이 쿼리 역시 1.7~2.6초 사이에 수백 건이 잡혔습니다. 실제 코드는 다음과 같습니다.
@Query("""
    SELECT COUNT(s) FROM Schedules s
    WHERE s.memberId = :userId
    AND s.scheduleType = 'SINGLE_DAY'
    AND s.isDeletedScheduled = false
    AND (:startTime < s.endTime AND :endTime > s.startTime)
    AND (:excludeId IS NULL OR s.id != :excludeId)
""")
Long countOverlappingSchedules(...)
인덱스는 (memberId, startTime, endTime) 순서로 걸려 있습니다. 문제는 이 쿼리가 startTime, endTime 양쪽 다 범위(부등호) 조건이라는 점입니다. 이 인덱스 순서로는 memberId 등호까지는 정확히 좁혀지지만, startTime < X는 아래쪽 경계가 없는 범위라 "이 member의 startTime이 X보다 작은 모든 행"을 다 훑은 뒤에야 endTime > Y로 추가 필터링하게 됩니다.
그리고 SELECT DISTINCT contents FROM schedules WHERE member_id = 1 LIMIT 5;를 돌려보니 값이 전부 테스트-135... 형태였습니다. 즉 1~4차 테스트를 거치며 같은 테스트 계정(member_id=1)에 일정이 계속 쌓이기만 하고, 한 번도 정리된 적이 없었던 것입니다.
그래서 DB에서 member_id가 1인 일정 건수를 조회했습니다.
SELECT COUNT(*) FROM schedules WHERE member_id = 1;
-- 10272
결과는 10,272건이었습니다. 아래쪽 경계 없는 범위 쿼리가 이 정도 규모의 행을 매번 스캔해야 했다면, 1.7~2.6초라는 수치가 충분히 설명됩니다. 그리고 이건 테스트를 거듭할수록 스스로 커지는 병목이었다는 뜻이기도 합니다. 1차보다 2차가, 2차보다 3차가 이 쿼리 입장에서는 매번 더 불리한 조건이었던 셈입니다.
그래서 DB에서 member_id =1인 일정 테이블의 갯수를 조회를 했습니다.
SELECT COUNT(*) FROM schedules WHERE member_id = 1;
-- 10272
결과는 10272건 아래쪽 경계 없는 범위 쿼리가 이 정도 규모의 행을 매번 스캔해야 했다면, 1.7~2.6초라는 수치가 충분히 설명됩니다. 그리고 이건 테스트를 거듭할수록 스스로 커지는 병목이었다는 뜻이기도 하고 1차보다 2차가, 2차보다 3차가, 이 쿼리 입장에서는 매번 더 불리한 조건이었던 셈입니다.
데이터 초기화 후 재검증
contents 값이 전부 테스트-135... 형태인 것으로 이 데이터가 순수 부하테스트용 데이터임을 다시 한 번 확인한 뒤, 정리를 진행했습니다.
DELETE FROM schedules WHERE member_id = 1;
10272건을 삭제하고 나면, 이론상 countOverlappingSchedules 쿼리가 스캔해야 할 행 수가 크게 줄어들어 슬로우 로그에서 사라지거나 소요시간이 눈에 띄게 짧아져야 합니다. 이 예상이 맞는지는 리마인더 DELETE 수정과 함께 반영한 뒤, 재현 테스트에서 한 번에 확인하기로 했습니다.
2-3. 리마인더 DELETE 원인 수정
데이터 정리와는 별개로, 리마인더 DELETE는 코드 문제였습니다. ReminderNotificationService와 ScheduleEventListener를 다시 열었습니다.
@TransactionalEventListener(phase = TransactionPhase.AFTER_COMMIT)
public void handleReminderRegistration(ScheduleDomainEvent event) {
    ...
    notificationInterfaces.createReminder(target);
}
event.actionType()으로 생성(SCHEDULE_CREATED)과 수정(SCHEDULE_UPDATE)을 이미 구분하고 있었는데, 정작 그 뒤에서는 둘 다 createReminder() 하나로 처리하고 있었습니다. 그리고 그 안에서는 생성 시점에도 무조건 DELETE부터 실행했습니다.
public void createReminder(SchedulesModel schedule) {
    notificationOutConnector.deleteReminderByScheduleId(schedule.getId()); // 생성인데 지울 게 있을 리 없음
    ...
}
방금 막 만든 스케줄에는 리마인더가 있을 수 없는데, 매번 이 헛수고 쿼리를 태우고 있었던 셈입니다. actionType이 이미 구분되고 있었으니, 분기만 추가하면 됐습니다.
// 생성 전용 - 방금 막 생성된 스케줄이라 기존 리마인더가 존재할 수 없으므로 DELETE 없이 INSERT만 한다
public void createReminder(SchedulesModel schedule) {
    notificationOutConnector.saveNotification(buildReminder(schedule));
}

// 수정 전용 - 시작시간이 바뀌면 리마인더 시각도 바뀌어야 하므로 기존 것을 지우고 새로 만든다
public void upsertReminder(SchedulesModel schedule) {
    notificationOutConnector.deleteReminderByScheduleId(schedule.getId());
    notificationOutConnector.saveNotification(buildReminder(schedule));
}

// ScheduleEventListener
if (event.actionType() == ScheduleActionType.SCHEDULE_CREATED) {
    notificationInterfaces.createReminder(target); // DELETE 없이 INSERT만
} else {
    notificationInterfaces.upsertReminder(target); // 기존 DELETE+INSERT
}
빌드와 관련 테스트를 통과시킨 뒤 CI를 거쳐 머지했습니다. 이제 생성 흐름에서는 DELETE가 아예 나가지 않게 되었습니다.
2-4. CAS 정합성 최종 확인
리마인더를 고치는 과정에서, 더 가벼운 대안(INSERT 전 존재 여부 체크)을 검토하다가 궁금한 게 생겼습니다. 지금 이 시스템에서 실제로 중복 생성이 일어나고 있을까요. 이건 CAS를 도입한 근본 이유이자, 이 시리즈 전체가 처음(328번 글) 던졌던 질문과 정확히 같았습니다.
SELECT schedule_id, notification_type, COUNT(*) AS cnt
FROM notification
GROUP BY schedule_id, notification_type
HAVING COUNT(*) > 1;
결과는 SCHEDULE_REMINDER가 아니라 SCHEDULE_CREATED 타입이었습니다. 그래서 타임스탬프를 확인했습니다.
SELECT schedule_id, notification_type, created_time
FROM notification
WHERE schedule_id IN (14952, 14883, 15060)
ORDER BY schedule_id, created_time;14952, SCHEDULE_CREATED, 2026-04-28 06:14:42
14952, SCHEDULE_CREATED, 2026-04-28 06:14:42
15060, SCHEDULE_REMINDER, 2026-04-28 06:14:46
15060, SCHEDULE_CREATED, 2026-04-28 06:14:48
15060, SCHEDULE_CREATED, 2026-04-28 06:14:48
2026년 4월 28일은 CAS를 도입하기 전, JPA dirty-check 기반으로 sent 상태를 갱신하던 구조였습니다. 특히 14952의 두 row는 타임스탬프가 초 단위까지 완전히 같았습니다. 우연이 아니라, 두 스레드가 정확히 같은 순간에 같은 이벤트를 처리한 진짜 레이스 컨디션의 흔적을 알 수 있었습니다.
그럼 CAS 도입 이후로는 어떨지 9월 한 달 동안 90VU 부하테스트를 여러 차례(1~4차) 반복한 기간만 따로 떼어 같은 검증을 돌려 보기 위해서 아래와 같은 쿼리를 작성해 돌려봤습니다.
SELECT schedule_id, notification_type, COUNT(*) AS cnt
FROM notification
WHERE created_time >= '2026-09-01'
GROUP BY schedule_id, notification_type
HAVING COUNT(*) > 1;
결과는 완전히 비어 있었습니다.
4월의 중복은 CAS 도입 이전, 콜백 기반 갱신 방식이 만든 유물이었다. CAS를 도입한 이후 9월 한 달간 수 차례의 90VU 부하테스트를 거치는 동안 새로 정합성 검증 테스트를 따로 돌릴 필요도 없이 단 한 건의 중복도 발생하지 않았습니다. 그 말인 즉슨 CAS 기반 원자적 UPDATE는 재처리 경합을 실제로 없앴고. 이 시리즈 전체가 처음부터 검증하려던 질문이었고, 이번 편에 이르러서야 완결된 답을 얻었습니다.
남겨둔 과제 (유니크 제약)
(schedule_id, notification_type) 유니크 제약을 걸면 이 문제를 DB 레벨에서 원천 차단할 수 있습니다. 다만 4월의 중복 데이터가 아직 남아있는 상태라 지금 바로 걸면 마이그레이션이 실패합니다. CAS가 이미 실증적으로 증명된 만큼, 이번 라운드는 급한 처방으로 보지 않고 오래된 중복 데이터 정리와 유니크 제약 추가를 다음 라운드 과제로 이월합니다.
2-5. 수정 반영 후 재현 테스트
리마인더 DELETE 수정을 배포하고, member_id=1 데이터를 정리한 뒤 동일 조건(90VU)으로 재현 테스트를 진행했습니다.
첫 시도 자정 배치와의 우연한 충돌
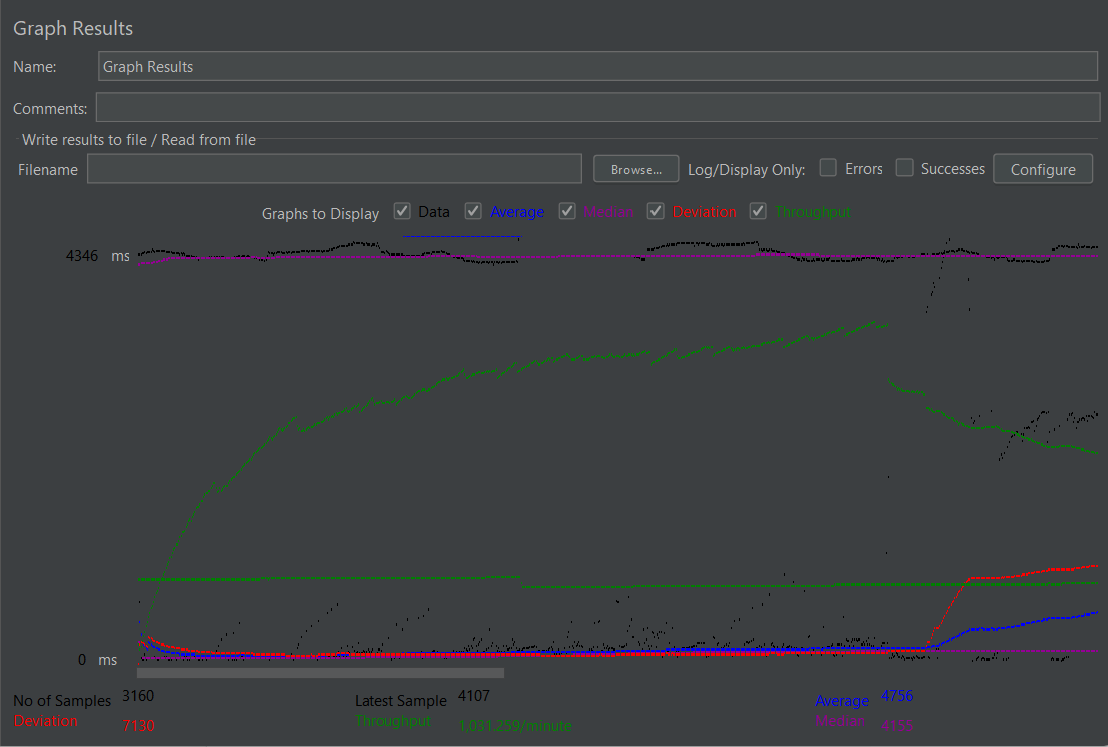
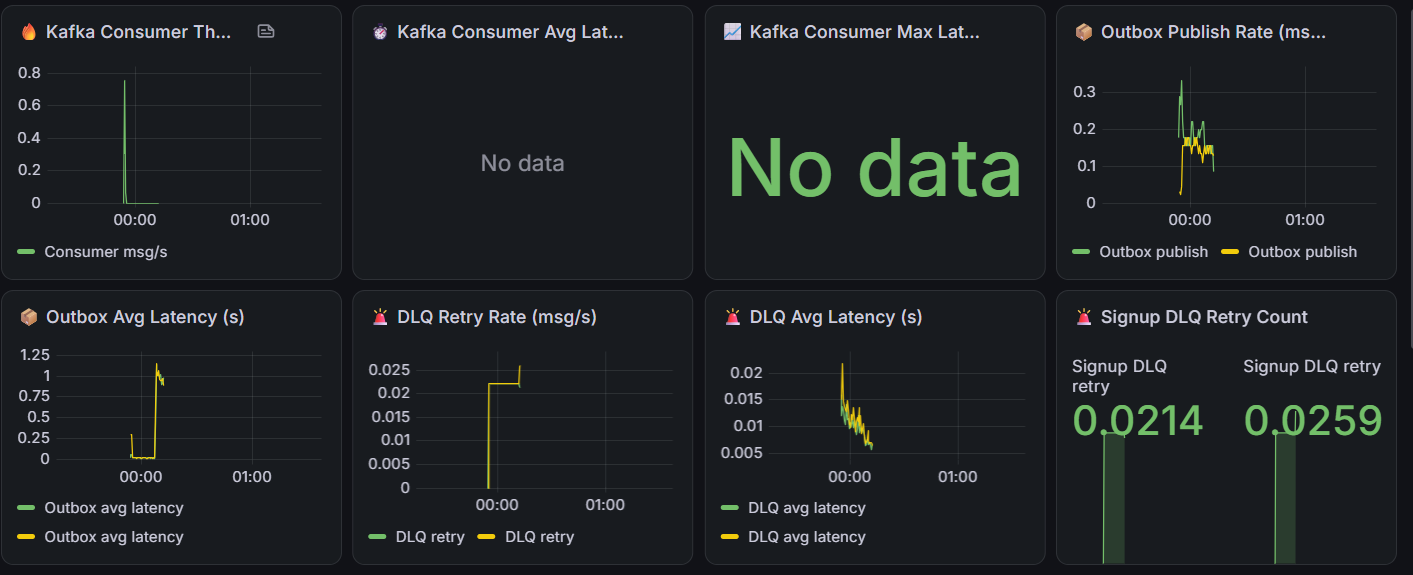
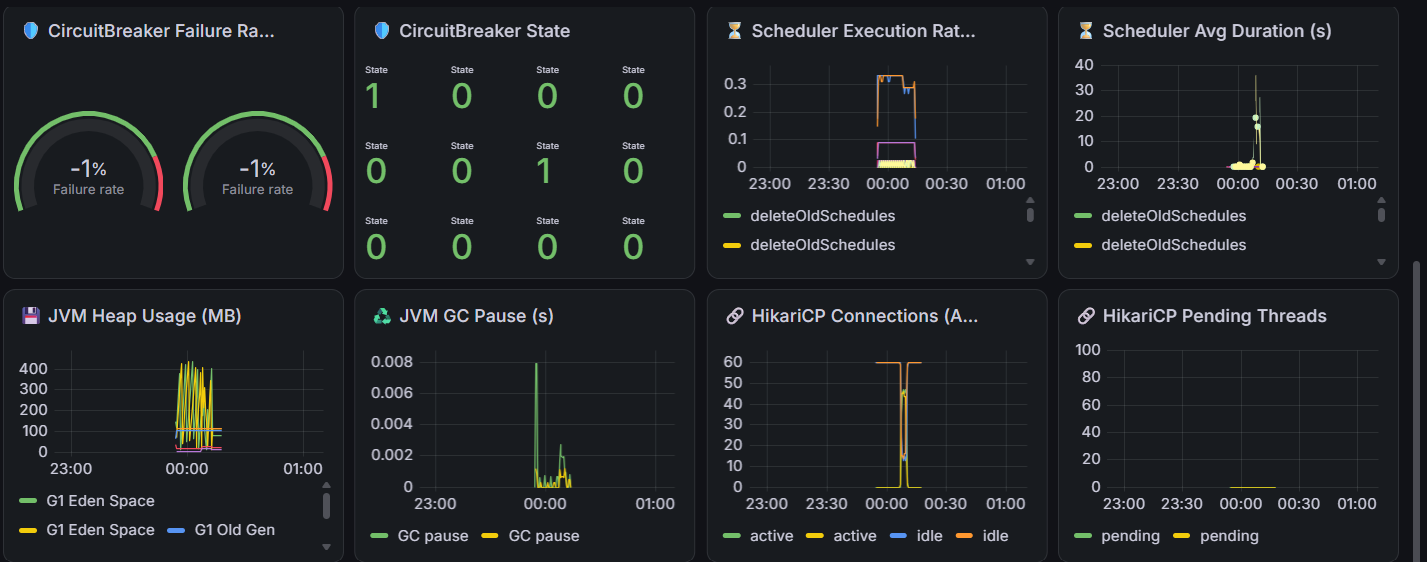
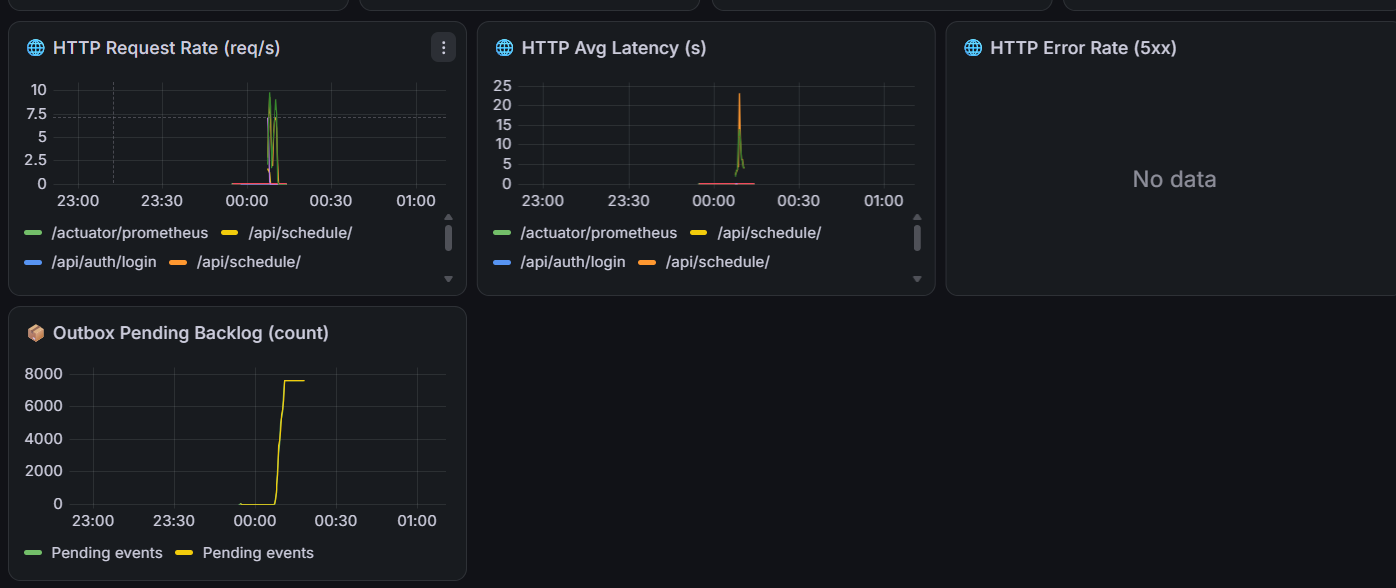
첫 재현 테스트는 하필 자정 근처에 돌아갔다. 결과가 심상치 않았습니다. Average 4756ms, Max 41934ms, Throughput 17.2/sec으로 오히려 4차보다 크게 나빠졌고, Outbox Pending Backlog는 8000건 가까이 치솟았다. Grafana의 Scheduler 패널을 보니 이번엔 publishOutboxEvents가 아니라 deleteOldSchedules가 40초 가까이 걸린 게 눈에 띄었습니다.
@Scheduled(cron = "0 0 0 * * ?")
public void deleteOldSchedules() {
    LocalDateTime thresholdDate = LocalDateTime.now().minusMonths(1);
    scheduleRepositoryPort.deleteOldSchedules(thresholdDate);
}
매일 자정 0시에 실행되는 오래된 일정 정리 배치였습니다. 하필 이 재현 테스트를 자정 근처에 돌리는 바람에, 90VU 부하와 이 대량 DELETE 배치가 정확히 겹쳐버린 것이었습니다. schedules 테이블에 긴 락이 걸리는 동안 생성 요청과 폴러가 전부 밀렸고, 그 결과가 Max Latency 41초, Backlog 8000건으로 나타났습니다. 이건 오늘 수정한 것과 무관한 별개의 문제라, 이번 결과는 공식 비교 대상에서 제외하고 데이터를 다시 정리한 뒤 자정을 피해 재측정하기로 했습니다.
두 번째 시도
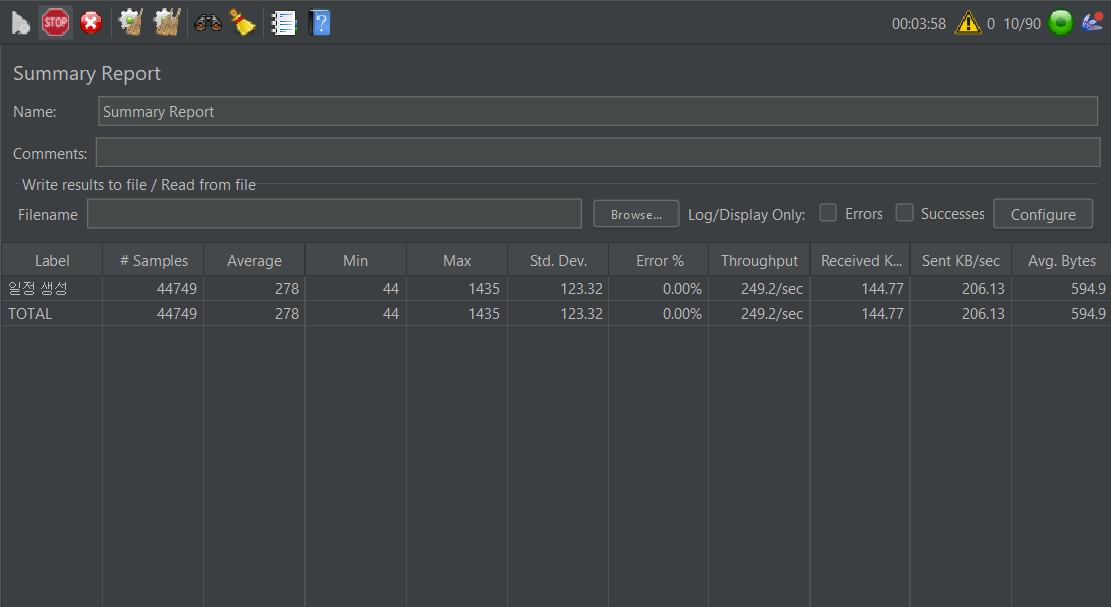
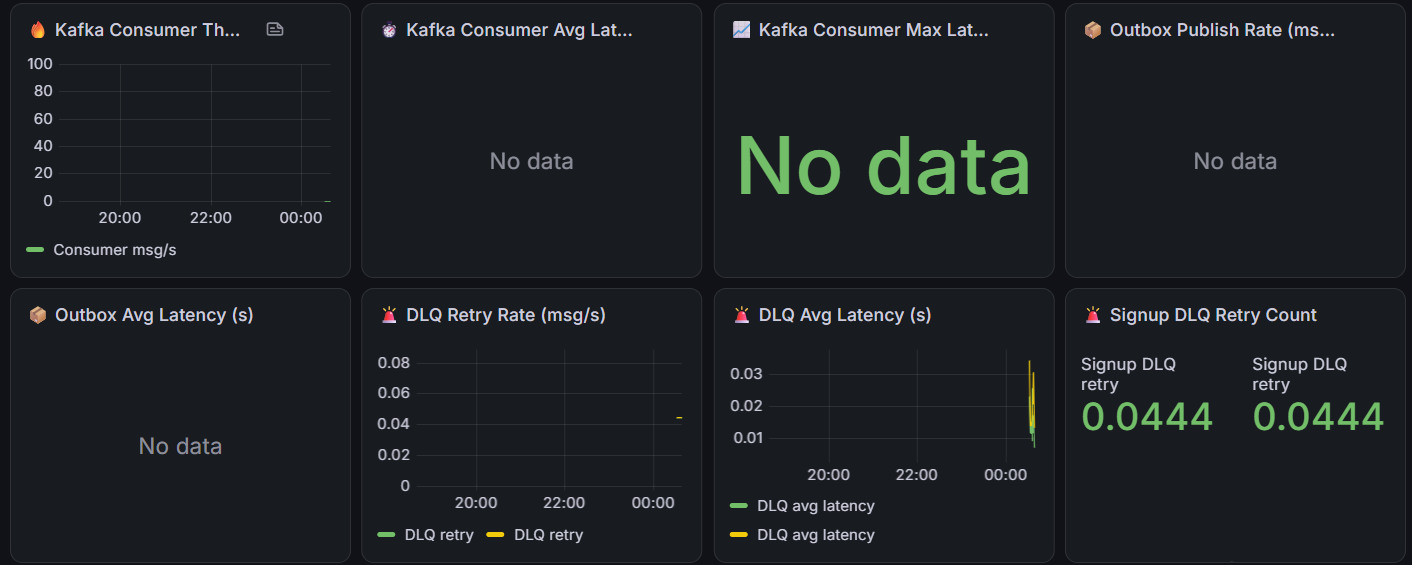
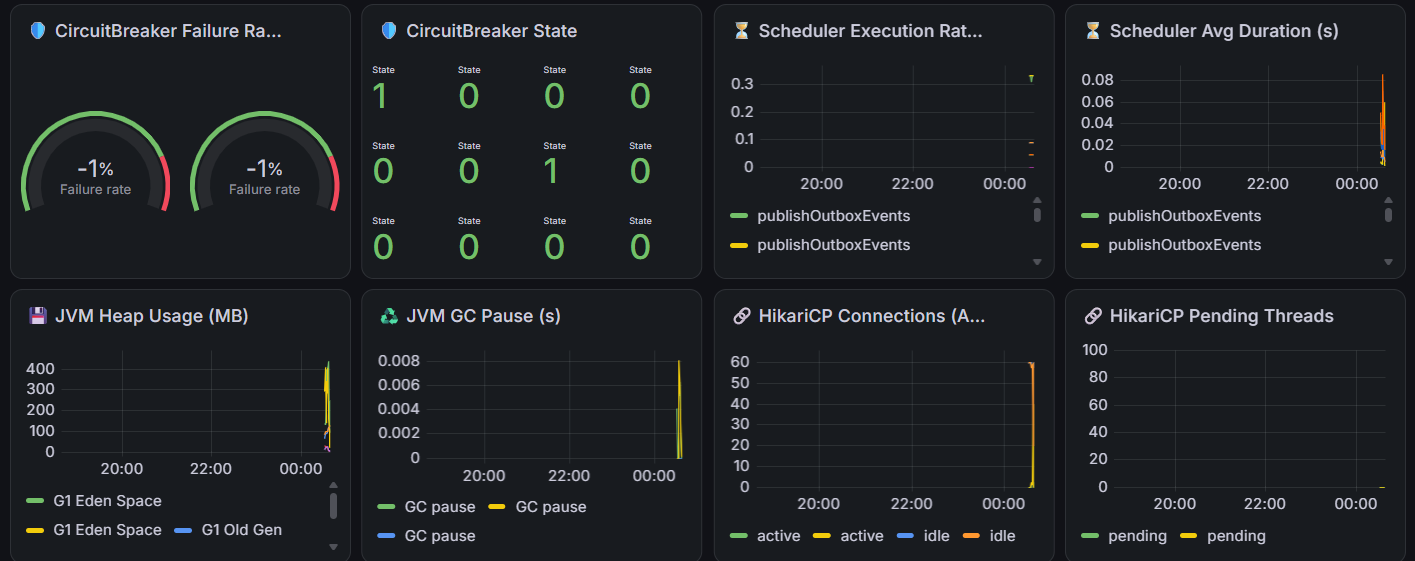
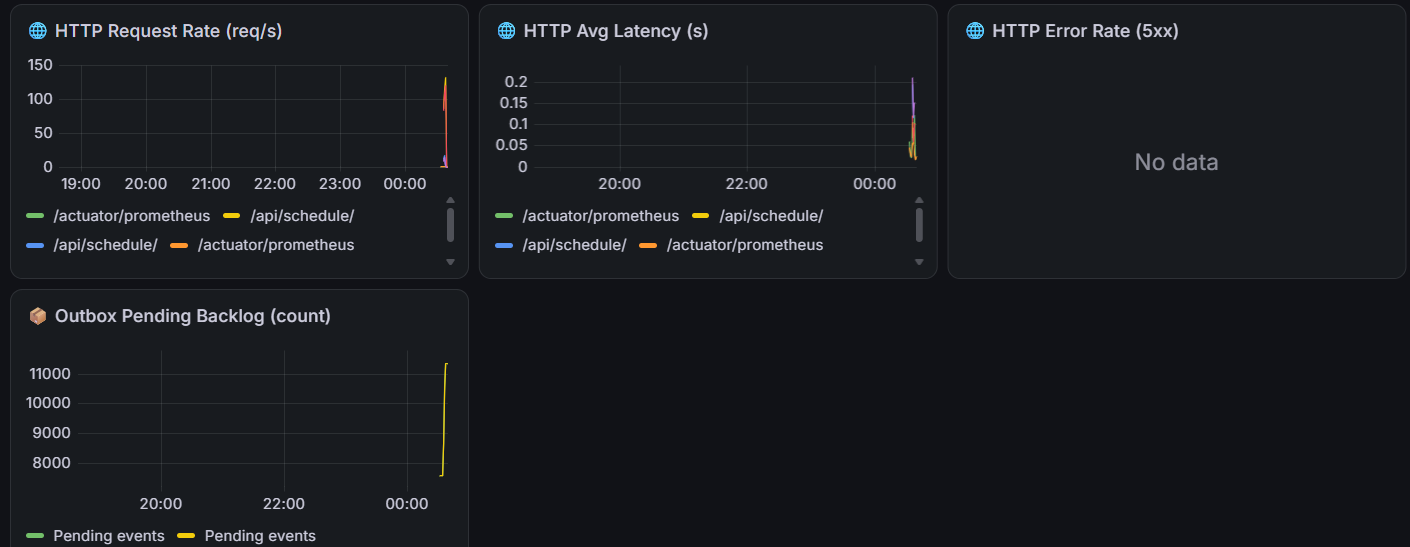
| 지표 | 4차 | 5차 |
| Samples | 10105 | 44749 |
| Average | 1463ms | 278ms |
| Max | 5153ms | 1435ms |
| 에러율 | 0.00% | 0.00% |
| Throughput | 55.8/sec | 249.2/sec |
Average가 1463ms → 278ms로 5배 이상, Throughput은 55.8 → 249.2/sec으로 4배 이상 개선됐다. 리마인더 DELETE 제거와 테스트 데이터 정리, 두 조치가 기대했던 것 이상으로 확실하게 효과를 냈다는 뜻이다.
참고로 JMeter 화면에 테스트 종료 시점 근처 10/90이 표시되는데, 이건 이상 현상이 아니다. Thread Group을 Duration 180초로 설정해두면 180초가 지나는 순간부터 각 스레드가 처리 중이던 마지막 요청을 끝내는 대로 순서대로 종료되는데, 지금 화면은 그 꼬리 부분(80개는 이미 종료, 10개만 마지막 요청 처리 중)을 캡처한 것이다.
정합성 SQL 2종 최악의 조건에서도 재확인
수정된 코드로 재현 테스트를 마친 뒤, 2-4에서 확인한 중복 검증에 이어 남은 두 가지 정합성 항목도 이번 재현 테스트 데이터로 확인했습니다.
-- Stuck 이벤트 (재시도만 반복하다 DLQ 임계값 근처까지 간 이벤트)
SELECT id, aggregate_id, event_type, retry_count, created_at
FROM outbox_event_entity
WHERE created_at > '테스트 시작 시각'
  AND sent = false
  AND retry_count >= 3
ORDER BY retry_count DESC;
-- 유실 이벤트 (스케줄은 생성됐는데 대응하는 outbox row가 없는 경우)
SELECT s.id, s.member_id, s.created_time
FROM schedules s
LEFT JOIN outbox_event_entity o
ON o.aggregate_id = CAST(s.id AS CHAR) AND o.event_type = 'SCHEDULE_CREATED'
WHERE s.created_time > '테스트 시작 시각'
AND o.id IS NULL;
(참고: 두 테이블의 collation이 서로 달라 처음엔 Illegal mix of collations 에러가 났다. COLLATE를 명시해 해결했습니다.)
결과는 둘다 0건이었다.
특히 이번 정합성 확인은 앞서 자정 배치와 겹쳐 backlog가 최대 11,000건까지 치솟았던 극단적 조건에서 나온 데이터를 기준으로 했다. 평범한 조건이 아니라 시스템이 크게 밀린 상황에서도 중복·stuck·유실이 전부 0건이었다는 건, 2-4에서 9월 전체 데이터로 확인한 결론을 한 번 더, 그것도 더 가혹한 조건에서 뒷받침하는 결과입니다.
그런데 여기서 예상 못한 새로운 문제가 드러났습니다
Throughput 249.2/sec인데, Outbox Pending Backlog는 오히려 최대 11,000건까지 치솟았다. 계산해보면 이유가 명확하다.
생성 속도: 249.2건/초
폴러 이론상 드레인 속도: 33.3건/초 (3초마다 100건)
249.2 ÷ 33.3 ≈ 7.5배
생성 속도가 폴러 드레인 속도의 7.5배에 달했습니다. 폴러가 아무리 정상 작동해도 애초에 이 정도로 빠르게 쏟아지는 이벤트를 다 소화할 수 없는 구조였던 것입니다.
이건 1차 테스트 때 세웠다가 "실패율이 32%라 애초에 이벤트가 그만큼 안 만들어졌다"는 이유로 증거 부족으로 넘어갔던 바로 그 가설입니다.
"90VU가 폴러의 이론상 드레인 한계(33.3건/초)보다 빠르게 이벤트를 만들어내면 못 따라갈 것이다"
당시엔 앞단 실패율이 너무 높아 이 가설을 검증할 조건 자체가 안 됐습니다. 이번 편에서 트랜잭션 길이, 리마인더 DELETE, 충돌체크 COUNT라는 앞단 병목을 전부 걷어내고 나니, 시스템이 실제로 이론적 드레인 한계를 훌쩍 뛰어넘는 속도로 이벤트를 만들어내기 시작했습니다. 앞단을 고칠수록 뒷단(폴러)의 진짜 한계가 더 선명하게 드러나는 구조입니다.
이 부분은 이번 편의 범위를 벗어나는 별도의 스케일링 이슈로 판단해, 다음 편의 과제로 남겨둡니다.
3. 결론
CAS 적용 후 처음 걸었던 90VU 부하테스트에서 시작해, 이번 5편에 이르기까지 여러 겹의 문제를 하나씩 벗겨냈다.
- 1차: 32.30% 에러율. CAS 도입 지점의 경합을 의심했지만, 핵심 지표(Outbox backlog)가 계측 실패로 확인 불가.
- 2차: 6.13%까지 개선. HikariCP 풀 고갈은 근거 부족으로 기각, 진짜 원인은 saveSchedule() 트랜잭션 안에 쌓인 불필요한 쿼리(알림 채널 중복 조회 등)로 특정. "정확히 10초"에서 끊기던 latency의 정체가 nginx의 조용한 failover(proxy_next_upstream)였다는 것도 이때 밝혀졌다.
- 3차: 인덱스 추가, 카테고리 캐싱, 리마인더 AFTER_COMMIT 분리 적용 후 에러율 0.0% 달성. 그런데 이 성공이 역설적으로 Outbox 폴러의 처리 용량 한계를 처음으로 드러냈다.
- 5차(이번 편): 폴러 자체의 N+1 트랜잭션 가설을 슬로우 쿼리 로그로 검증했지만 기각. 대신 리마인더 DELETE와 충돌체크 COUNT라는 두 개의 숨은 병목을 찾아 수정했고, 그 과정에서 곁가지로 확인한 CAS 정합성(중복,stuck,유실)이 9월 한 달치 데이터 전체에서 전부 0건으로 확인됐다.
CAS 기반 원자적 UPDATE는 재처리 경합을 실제로 없앴습니다. 이 시리즈 전체가 처음부터 검증하려던 질문이었고, 자정 배치와 겹쳐 시스템이 크게 밀렸던 최악의 조건에서도 답은 흔들리지 않았습니다.
동시에 이번 편은 새로운 과제도 남겼습니다. 앞단 병목을 걷어내자 폴러의 진짜 처리 한계(33.3건/초)가 실제 생성 속도(249.2건/초)에 크게 못 미친다는 사실이 드러났습니다. 이건 다음 편에서 다룰 문제입니다.
다음 과제
- Outbox 폴러 처리 용량 확장 (배치 크기, 폴링 주기, 또는 병렬화 검토)
- (schedule_id, notification_type) 유니크 제약 추가 (4월 중복 데이터 정리 선행 필요)
- CAS 회귀 테스트 -> pool 40, connection-timeout 15초, nginx 10초로 조건을 원복해 328번 글의 원래 베이스라인(84.3 TPS, 1분 37초 붕괴)과 직접 비교
- Mixed-flow 부하테스트로 전환 (생성/수정 비율, VU당 로그인 세션, think-time, 가정 기반 목표 TPS까지 갖춘 현실적인 로드 테스트 설계)
'포폴 > 일정관리 프로젝트 vol.02' 카테고리의 다른 글
| 분산 서버 전환 후 부하 테스트로 병목 구간 찾기6 (0) | 2026.09.14 |
|---|---|
| 분산 서버 전환 후 부하 테스트로 병목 구간 찾기4 (0) | 2026.09.11 |
| ContextSnapshot과 OTLP를 활용한 분산 추적(Distributed Tracing) 구축기 (0) | 2026.06.25 |
| 분산 서버 전환 후 부하 테스트로 병목 구간 찾기3 (0) | 2026.05.03 |
| 카프카의 복구 과정을 측정 - ISR 테스트 (0) | 2026.05.02 |


