
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | 6 | 7 |
| 8 | 9 | 10 | 11 | 12 | 13 | 14 |
| 15 | 16 | 17 | 18 | 19 | 20 | 21 |
| 22 | 23 | 24 | 25 | 26 | 27 | 28 |
| 29 | 30 |
- Join
- spring boot
- mysql
- 포트폴리오
- 알고리즘
- LV02
- 이것이 자바다
- 코테
- docker
- CI/CD
- LV.02
- LV03
- JMeter
- SQL
- 데이터 베이스
- LV01
- 연습문제
- nginx
- Java
- JPA
- Kafka
- 일정관리프로젝트
- Lv.0
- 디자인 패턴
- CoffiesVol.02
- 일정관리 프로젝트
- Redis
- 프로그래머스
- AWS
- LV0
- Today
- Total
코드 저장소.
ArrayList 와 LinkedList 의 직접 구현 및 비교 본문
목차
1.쓰게 된 이유
2.ArrayList 의 내부 구조
3.LinkedList 의 내부 구조
4.ArrayList vs LinkedList
5.마치며
1.쓰게 된 이유
최근에 자료구조와 알고리즘을 공부를 하면서 코딩 테스트를 풀고 있던 도중에 타인의 풀이를 보면서 코드를 분석을 하는 과정에서 간혹 보면 자료구조를 실제로 구현을 해서 풀었던 내용을 본 적이 있었습니다. 그러던중 문득 실제로 코드에 자주 나오는 List, Map의 내부 구조가 궁금해지기 시작했습니다. 이번 글에서는 그중 List부터 보려고 합니다.
이번에는 자주 사용이 되는 ArrayList와 LinkedList의 JDK의 내부 구조를 보면서 어떻게 작동이 되는지 그리고 실제 코드를 직접 구현해 보려고 합니다.
2.ArrayList 의 내부 구조
2-1.기본적인 특징
ArrayList의 기본적인 특징은 다음과 같습니다.
- 안에 배열을 하나 들고 있는 리스트입니다.
- 몇 번째 값이든 바로 꺼낼 수 있습니다. (조회가 빠릅니다.)
- 배열이 꽉 차면 더 큰 배열을 만들어 옮깁니다. 크기를 신경 쓰지 않고 계속 넣을 수 있습니다.
- 중간에 넣거나 빼면 뒤쪽 값들을 전부 밀거나 당겨야 합니다. (중간 추가와 삭제가 느립니다.)
| 동작 | 시간 |
| get(i), set(i) | O(1) |
| 맨 끝 add | 평균 O(1) |
| add(index), remove(index) | O(1) |
| indexOf, contains | O(1) |
2-2. 내부 코드의 구조
다음으로는 ArrayList의 내부코드에 관한 내용입니다. 코드를 보는 순서는 아래와 같습니다.
선언한 변수
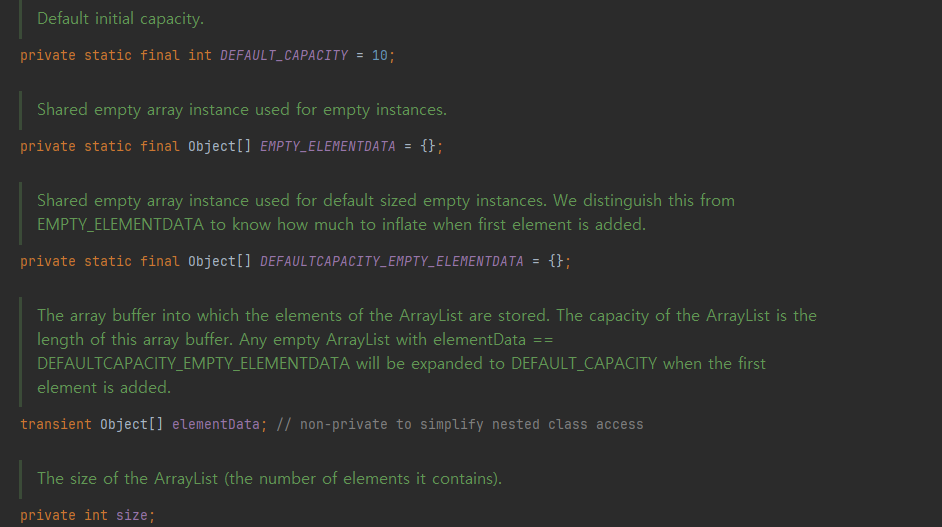
변수를 설명을 하자면 다음과 같습니다.
DEFAULT_CAPACITY : ArrayList의 기본 크기를 말합니다. 크기는 10입니다.
EMPTY_ELEMENTDATA : 빈 배열 상수이고 크기를 0으로 정해서 만들었을 때 사용합니다.
DEFAULTCAPACITY_EMPTY_ELEMENTDATA : 빈 배열 상수이고 기본 생성자로 만들었을 때 사용합니다.
elementData : 실제 값이 들어가 있는 배열입니다.
size: 리스트에 들어있는 값의 개수를 말합니다.
우선 여기에서 주의를 해둬야 할 부분은 elementData.length 와 size 는 다릅니다. 간단하게 예를 들어 보겠습니다.
List<String> list = new ArrayList<>();
list.add("A");
list.add("B");
list.add("C");
아래의 그림처럼 첫 add에서 크기 10짜리 배열이 만들어지고, 값이 3개 들어갑니다.
elementData: [A][B][C][ ][ ][ ][ ][ ][ ][ ]
              0  1  2  3  4  5  6  7  8  9
이때 elementData.length는 10, size는 3입니다. list.size()도 3을 돌려줍니다. 배열 크기는 “얼마나 넣을 수 있나” 이고, size는 "지금 몇 개 들어 있나"입니다. 처음에 이상했던 건 빈 배열 상수가 두 개라는 점입니다. 둘 다 {}인데 왜 나눴을까? 주석에 답이 있었습니다.
We distinguish this from EMPTY_ELEMENTDATA to know how much to inflate when first element is added.
첫 원소를 넣을 때 얼마나 키울지 알기 위해서입니다. 자세한 건 아래 grow에서 다시 보겠습니다.
다음으로는 생성자입니다.

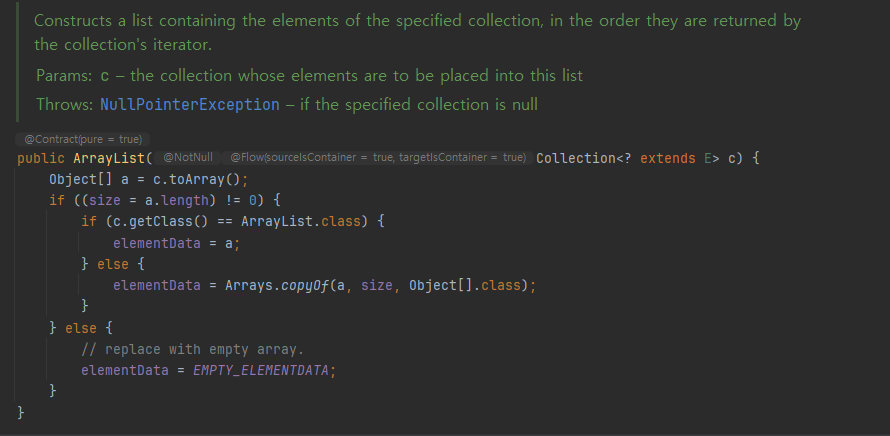
생성자는 3개입니다. 기본 생성자 1개와 인자를 받는 생성자 2개로 되어있습니다.
- ArrayList() (기본 생성자)
- DEFAULTCAPACITY_EMPTY_ELEMENTDATA를 넣습니다.
- 주석에는 "initial capacity of ten"이라고 돼 있지만, 실제로는 빈 배열입니다. 크기 10짜리 배열은 처음 add할 때 만듭니다. 만들어 놓고 안 쓰는 경우 메모리를 아끼려고 하는 것입니다.
- ArrayList(int initialCapacity)
- 0보다 크면 그 크기로 배열을 만듭니다.
- 0이면 EMPTY_ELEMENTDATA를 넣습니다.
- 음수면 IllegalArgumentException을 던집니다.
- ArrayList(Collection<? extends E> c)
- 컬렉션을 toArray()로 배열로 바꾸고, 그 길이를 size에 넣습니다.
- 길이가 0이 아닌 경우면
- 넘어온 컬렉션이 ArrayList면 그 배열을 그대로 씁니다. ArrayList.toArray()는 이미 새로 복사한 배열을 돌려주니까 한 번 더 복사할 필요가 없습니다.
- 다른 컬렉션이면 Arrays.copyOf(a, size, Object[].class)로 한 번 더 복사합니다. 다른 컬렉션의 toArray()는 String[]처럼 Object[]가 아닌 배열을 돌려줄 수도 있어서, Object[]로 맞추려는 것입니다.
- 길이가 0이면 EMPTY_ELEMENTDATA를 넣습니다.
정리하면 빈 배열로 시작하는 경우가 두 가지입니다.
| 만드는 방법 | 들어가는 상수 | 첫 add 때 |
| new ArrayList<>() | DEFAULTCAPACITY_EMPTY_ELEMENTDATA | 크기 10으로 만든다 |
| new ArrayList<>(0), 빈 컬렉션 | EMPTY_ELEMENTDATA | 크기 1부터 조금씩 늘린다 |
new ArrayList<>(0)은 "0으로 만들겠다"고 직접 정한 것이라 10으로 키우지 않고 1 → 2 → 3 → 4 → 6 순서로 늘어납니다.
다음은 get입니다.
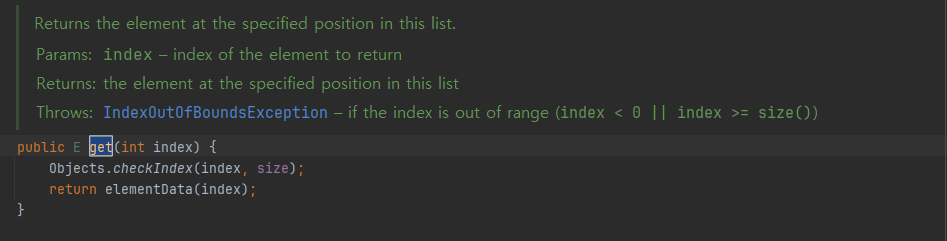
get메서드는 Objects.checkIndex로 범위를 검사하고 배열에서 바로 꺼냅니다. 배열은 "시작 주소 + 칸 크기 × index"로 위치를 바로 계산할 수 있어서 O(1)입니다.
다음은 add입니다.
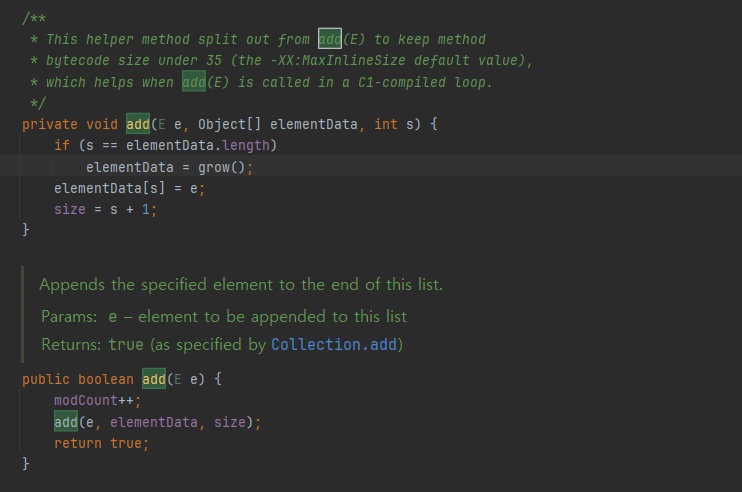
배열이 꽉 찼으면(s == elementData.length) grow()로 늘리고, size 자리에 넣습니다. add가 안에서 add를 한 번 더 부르는 게 이상해 보였는데, JDK 주석에 이유가 있습니다. 메서드를 작게 쪼개서 JIT 컴파일러가 인라인하기 쉽게 하려는 것입니다.
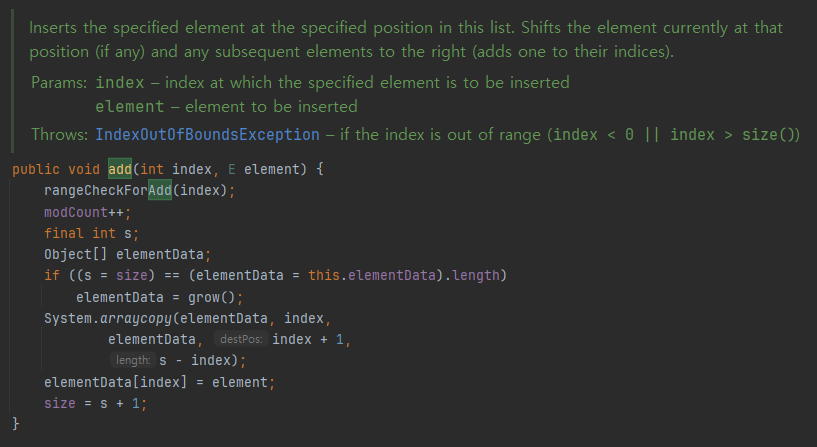
index부터 뒤쪽을 System.arraycopy로 한 칸씩 뒤로 밀고, 빈자리에 넣습니다.
System.arraycopy(원본 배열, 원본 시작 위치, 대상 배열, 대상 시작 위치, 옮길 개수)
같은 배열 안에서 index부터 size - index개를 index + 1로 옮기니까 한 칸씩 밀립니다. add(0, e)처럼 맨 앞에 넣으면 전부 밀어야 해서 O(n)입니다.
다음으로는 grow() 입니다.
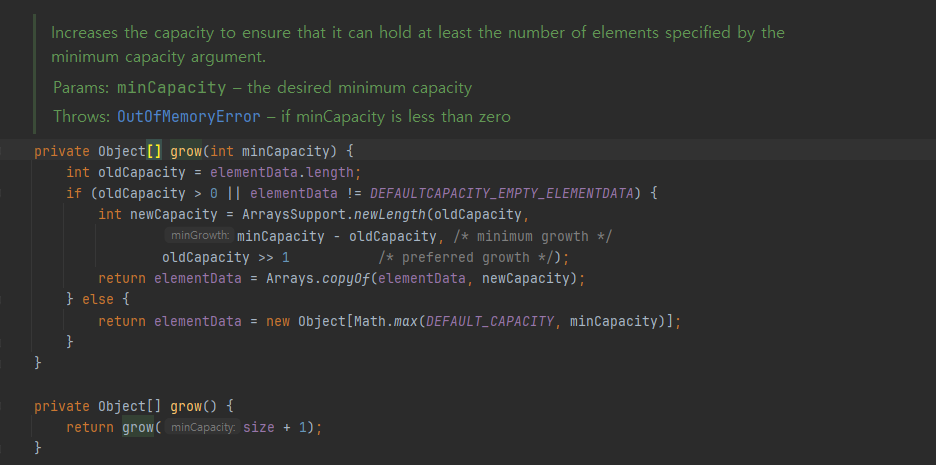
- 처음 넣을 때(빈 배열일 때)는 크기 10짜리 배열을 새로 만듭니다.
- 그 뒤로는 기존 크기의 절반(oldCapacity >> 1)만큼 늘립니다. 즉 1.5배로 늘어나는 구조입니다. 10 → 15 → 22 → 33 …
- Arrays.copyOf로 새 배열을 만들고 기존 값을 전부 옮깁니다.
옮기는 데 O(n)이 걸리지만 꽉 찰 때만 일어납니다. 여러 번 add한 걸 평균 내면 한 번에 O(1)입니다(분할 상환).
다음으로는 remove() 입니다.
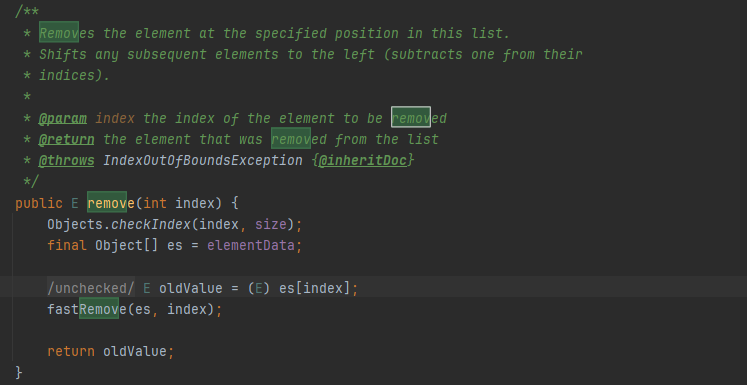
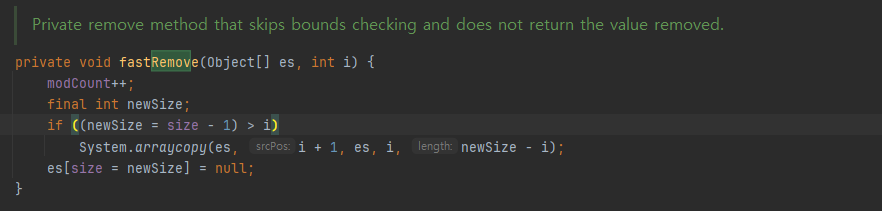
지운 자리 뒤쪽을 한 칸씩 앞으로 당깁니다. add와 반대 방향입니다.
마지막 줄 es[size = newSize] = null이 중요합니다. 당기고 나면 맨 끝 칸에 마지막 값이 하나 더 남아 있습니다. size가 줄어서 리스트로는 안 보이지만, 배열은 여전히 그 객체를 가리키고 있습니다. 그러면 GC가 그 객체를 치우지 못하게 됩니다. 그래서 null로 참조를 끊습니다.
범위 검사
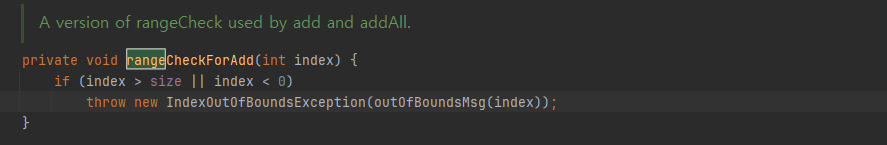
- get, set, remove: Objects.checkIndex(index, size) → 0 <= index < size
- add(index, e): rangeCheckForAdd → 0 <= index <= size
add만 index == size를 허용합니다. size 위치에 넣는 건 맨 끝에 붙이는 것이라 정상입니다. 반면 get(size)는 아직 값이 없는 칸이라 막아야 합니다.
2-3. 직접 구현해 보기
JDK 코드를 보면서 MyList 인터페이스를 만들고 ArrayList를 직접 구현해 봤습니다. 여기서는 핵심만 보겠습니다.
private static final int DEFAULT_CAPACITY = 10;
private static final Object[] EMPTY = {};

private Object[] elementData = EMPTY;   // 지연 초기화
private int size;

private Object[] grow() {
    int oldCapacity = elementData.length;
    if (oldCapacity > 0 || elementData != EMPTY) {
        int newCapacity = oldCapacity + (oldCapacity >> 1);  // 1.5배
        return elementData = Arrays.copyOf(elementData, newCapacity);
    } else {
        return elementData = new Object[DEFAULT_CAPACITY];   // 첫 add 때 10
    }
}

@Override
public void add(int index, E e) {
    rangeValidatedCheck(index);              // 0 <= index <= size
    if (size == elementData.length) {
        grow();
    }
    System.arraycopy(elementData, index, elementData, index + 1, size - index);
    elementData[index] = e;
    size++;
}

@Override
public E remove(int index) {
    checkedIndex(index);                     // 0 <= index < size
    E oldValue = (E) elementData[index];
    int numMoved = size - index - 1;
    if (numMoved > 0) {
        System.arraycopy(elementData, index + 1, elementData, index, numMoved);
    }
    elementData[--size] = null;              // 참조 끊기
    return oldValue;
}
JDK와 다르게 한 점은 다음과 같습니다.
- 생성자를 따로 만들지 않고 필드에서 바로 빈 배열을 넣었습니다. 크기를 받는 생성자가 없어서 빈 배열 상수도 하나만 썼습니다.
- add(e)는 add(size, e)를 부르게 했습니다. 코드는 짧아지지만, 맨 끝에 넣을 때도 arraycopy를 한 번 거칩니다(옮길 개수가 0이라 실제로 옮기는 값은 없습니다). JDK는 맨 끝 추가를 따로 만들어 이 과정을 건너뜁니다.
- grow는 1.5배만 계산했습니다. JDK는 ArraysSupport.newLength로 최소로 필요한 크기와 배열 최대 크기까지 따집니다.
헷갈렸던 점은 다음과 같습니다.
- System.arraycopy 인자 순서를 헷갈렸습니다. add는 index → index + 1(뒤로 밀기), remove는 index + 1 → index(앞으로 당기기)입니다.
- remove 후 null을 넣는 이유를 처음엔 "얕은 복사 때문"이라고 생각했습니다. 실제로는 복사와 상관없고, 안 쓰는 참조가 남아 GC가 치우지 못하는 걸 막는 것입니다.
아직 안 한 것은 iterator(), modCount를 이용한 fail-fast가 남았습니다.
3.LinkedList 의 내부 구조
3-1. LinkedList의 특징
- 값을 노드에 담고, 노드끼리 앞뒤로 연결한 리스트입니다. (이중 연결 리스트)
- 배열이 아니라서 미리 크기를 잡거나 늘릴 필요가 없습니다.
- 맨 앞이나 맨 뒤에 넣고 빼는 건 연결만 바꾸면 돼서 빠릅니다.
- 몇 번째 값을 꺼내려면 처음(또는 끝)부터 하나씩 따라가야 해서 느립니다.
- List뿐만 아니라 Deque도 구현합니다. 그래서 큐나 스택으로도 쓸 수 있습니다.
| 동작 | 시간 |
| get(i), set(i) | O(n) |
| 맨 앞, 맨 뒤 add/remove | O(1) |
| add(index), remove(index) | O(n) (위치를 찾는 데 O(n), 연결 바꾸기는 O(1)) |
| indexOf, contains | O(n) |
3-2. LinkedList의 내부구조
클래스 선언
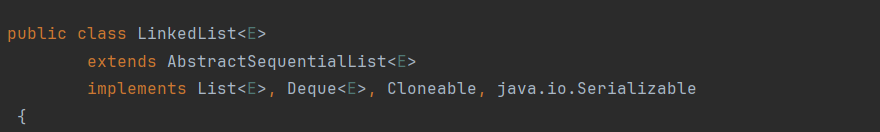
implements 뒤에 Deque<E>가 있습니다. ArrayList에는 없는 부분입니다. 스택은 다음글에서 다루겠습니다.
변수와 Node
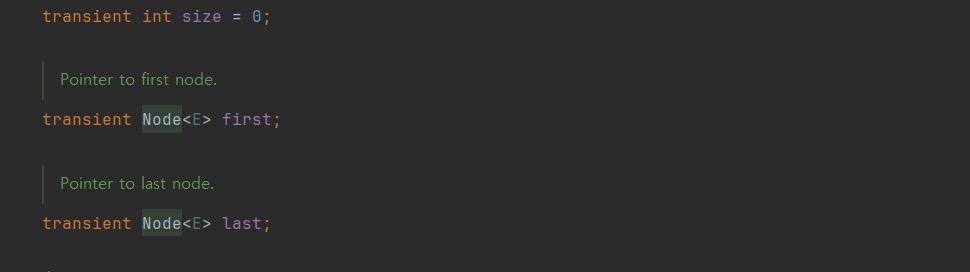
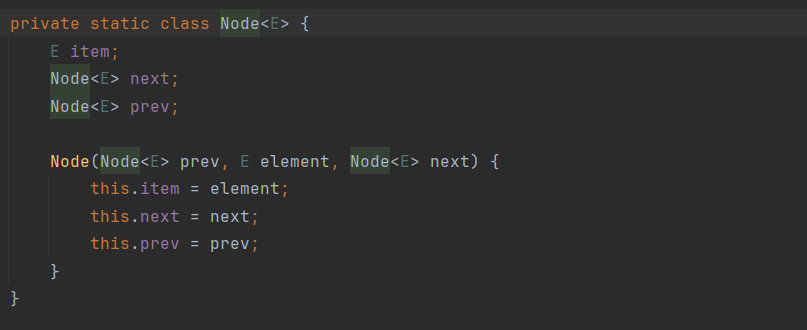
변수뜻
| 변수 | 의미 |
| size | 지금 들어 있는 개수 |
| first | 맨 앞 노드 |
| last | 맨 뒤 노드 |
노드 하나는 값(item)과 앞 노드(prev), 뒤 노드(next)를 들고 있습니다.
first                              last
  ↓                                  ↓
[null | A | →] ⇄ [← | B | →] ⇄ [← | C | null]
ArrayList처럼 배열 크기와 size를 구분할 필요가 없습니다. 노드가 3개면 size도 3입니다. 대신 값 하나마다 prev, next 참조가 붙어서 메모리를 더 씁니다.
생성자
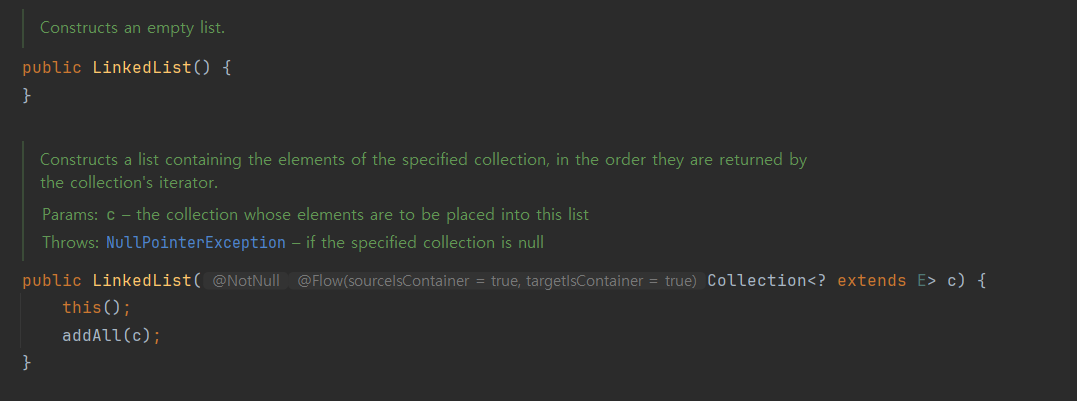
생성자는 2개입니다.
- LinkedList(): 아무것도 하지 않습니다. first, last는 null, size는 0으로 시작합니다. ArrayList처럼 미리 만들어 둘 배열이 없으니까 할 일이 없습니다.
- LinkedList(Collection<? extends E> c): 기본 생성자를 부르고 addAll(c)로 하나씩 연결합니다.
add(e)
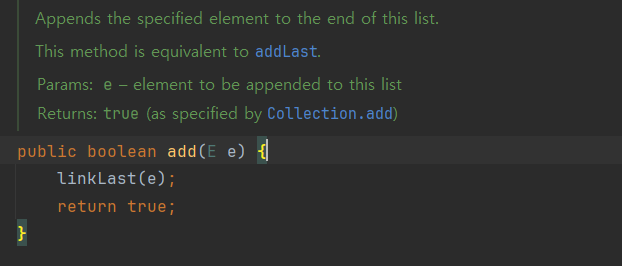
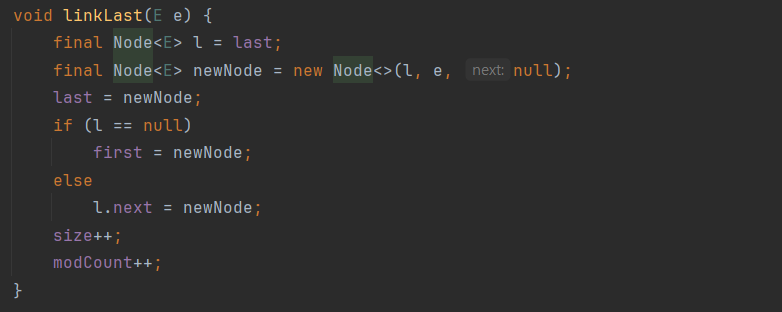
- 지금 last를 l에 잠깐 담아 둡니다.
- 새 노드를 만듭니다. 앞은 l, 뒤는 null입니다.
- last를 새 노드로 바꿉니다.
- l이 null이면(리스트가 비어 있었으면) first도 새 노드입니다. 아니면 l.next를 새 노드로 잇습니다.
배열을 늘리거나 옮기는 일이 없어서 항상 O(1)입니다. ArrayList의 "평균 O(1)"과 다릅니다.
add(index, e)
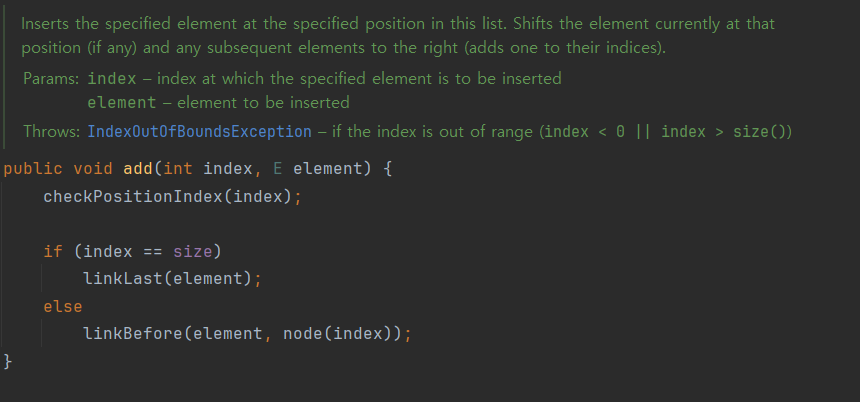
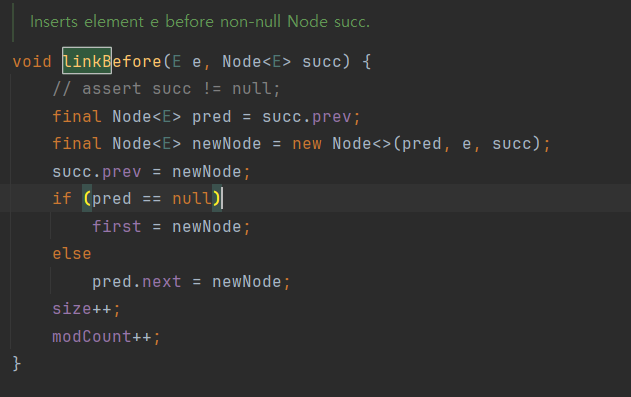
- index == size면 맨 뒤라서 linkLast를 부릅니다.
- 아니면 node(index)로 그 자리의 노드를 찾고, 그 앞에 새 노드를 끼웁니다(linkBefore).
linkBefore는 연결 네 개만 바꾸면 끝이라 O(1)입니다. 하지만 그 전에 node(index)로 위치를 찾는 데 O(n)이 걸립니다. 그래서 "LinkedList는 중간 삽입이 빠르다"는 말은 반만 맞습니다. 왜냐하면 위치를 이미 알고 있을 때만 빠르기 때문입니다.
get(i)와 node(index)
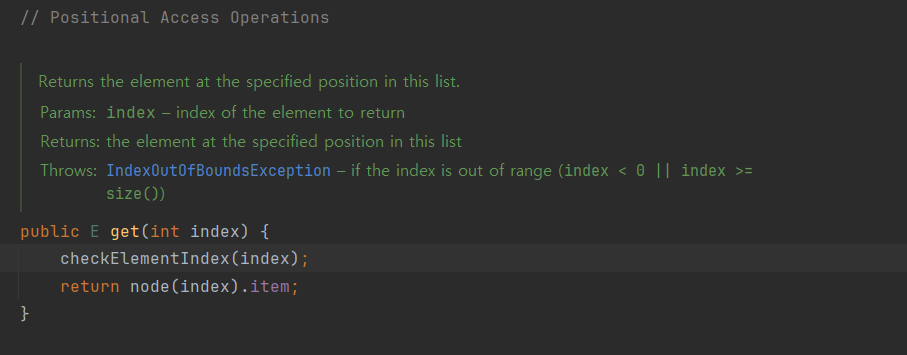
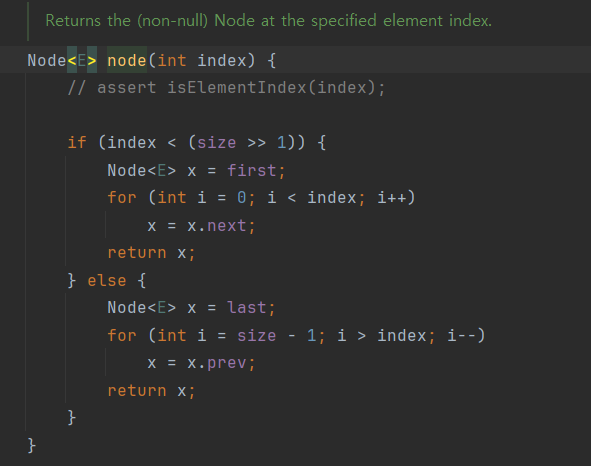
get은 범위를 검사하고 node(index).item을 돌려줍니다. 핵심은 node(index)입니다.
if (index < (size >> 1)) {   // 앞쪽 절반이면
    // first부터 next로 따라간다
} else {                     // 뒤쪽 절반이면
    // last부터 prev로 따라간다
}
size >> 1은 size / 2입니다. 찾는 위치가 앞쪽이면 앞에서, 뒤쪽이면 뒤에서 출발합니다. 양방향 연결이라 가능한 방법입니다. 그래도 최악은 절반을 따라가야 해서 O(n)입니다.
remove(index)와 unlink
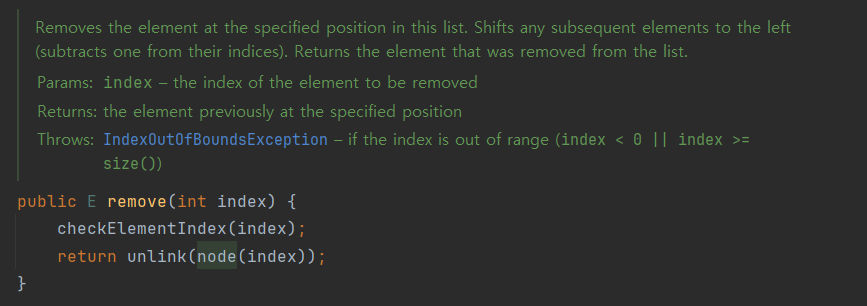
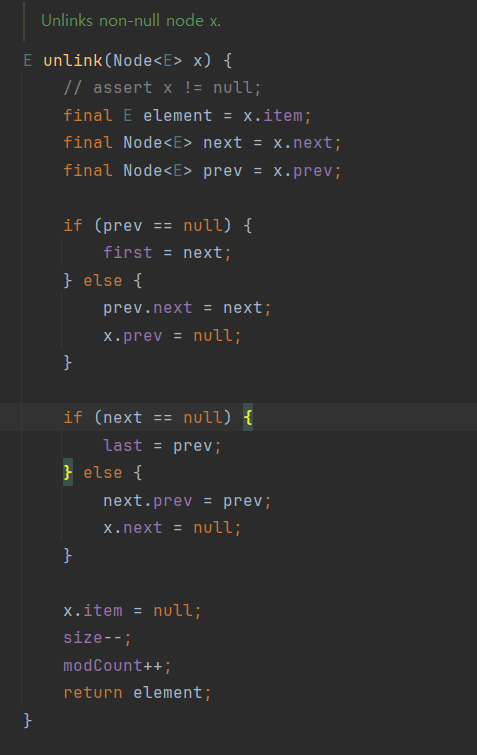
node(index)로 노드를 찾고 unlink로 떼어 냅니다.
- 앞 노드가 없으면(맨 앞이면) first를 다음 노드로 바꿉니다. 있으면 앞 노드의 next를 다음 노드로 잇습니다.
- 뒤 노드가 없으면(맨 뒤면) last를 앞 노드로 바꿉니다. 있으면 뒤 노드의 prev를 앞 노드로 잇습니다.
- 떼어 낸 노드의 prev, next, item을 null로 비웁니다.
3번은 ArrayList의 es[size] = null과 같은 이유입니다. 이유는 안 쓰는 참조를 끊어서 GC가 치울 수 있게 하기 위해서 입니다.
범위 검사도 두 종류입니다
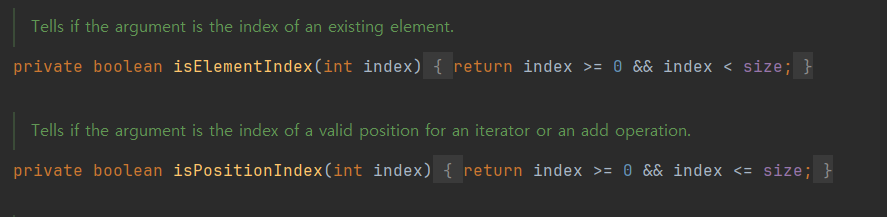
| 메서드 | 조건 | 쓰는곳 |
| isElementIndex | 0 <= index < size | get, set, remove |
| isPositionIndex | 0 <= index <= size | add(index) |
ArrayList와 똑같다. 이름이 더 친절하다. "원소가 있는 자리(Element)"와 "넣을 수 있는 자리(Position)"를 구분한 것입니다.
clear()
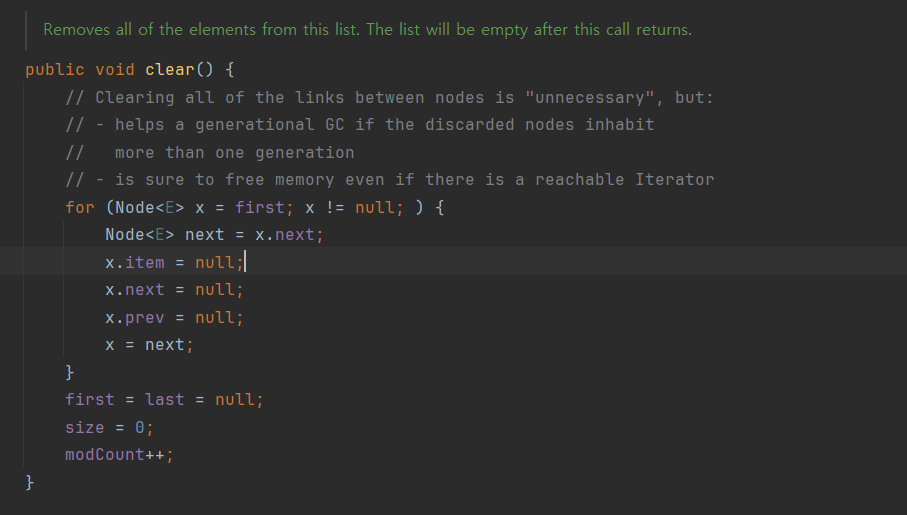
모든 노드를 돌면서 item, next, prev를 null로 끊습니다. 주석에는 "unnecessary"(꼭 필요하진 않다)라고 적혀 있습니다. first, last만 null로 만들어도 노드들은 어디서도 닿지 않으니 결국 GC 대상이 되기 때문입니다. 그래도 끊는 이유 역시 주석에 있습니다. GC를 돕고, 누군가 Iterator를 들고 있어도 메모리가 확실히 풀리게 하려는 것입니다.
3-3. 직접 구현한 코드
private Node<E> getNode(int index) {
    if (index < 0 || index >= size) {
        throw new IndexOutOfBoundsException("Index: " + index + ", Size: " + size);
    }
    if (index < (size / 2)) {               // 앞쪽이면 first부터
        Node<E> x = first;
        for (int i = 0; i < index; i++) x = x.next;
        return x;
    } else {                                // 뒤쪽이면 last부터
        Node<E> x = last;
        for (int i = size - 1; i > index; i--) x = x.prev;
        return x;
    }
}

@Override
public void add(int index, E e) {
    if (index < 0 || index > size) {
        throw new IndexOutOfBoundsException("Index: " + index + ", Size: " + size);
    }
    if (index == size) {
        add(e);                             // 맨 끝이면 그냥 add
    } else {
        Node<E> succ = getNode(index);      // 그 자리에 있던 노드
        Node<E> pred = succ.prev;
        Node<E> newNode = new Node<>(pred, e, succ);
        succ.prev = newNode;
        if (pred == null) first = newNode;  // 맨 앞에 넣는 경우
        else pred.next = newNode;
        size++;
    }
}

@Override
public E remove(int index) {
    Node<E> x = getNode(index);
    E element = x.item;
    Node<E> next = x.next;
    Node<E> prev = x.prev;

    if (prev == null) first = next;         // 맨 앞을 지우는 경우
    else { prev.next = next; x.prev = null; }

    if (next == null) last = prev;          // 맨 뒤를 지우는 경우
    else { next.prev = prev; x.next = null; }

    x.item = null;
    size--;
    return element;
}
JDK와 다르게 한 점은 다음과 같습니다.
- 범위 검사를 getNode 안에 넣었습니다. JDK는 checkElementIndex와 node를 나눠서, 검사와 찾기를 따로 합니다.
- JDK는 연결하는 코드를 linkLast, linkBefore, unlink로 따로 빼 두고 add, remove, addFirst, pollLast 같은 여러 메서드가 같이 씁니다. 저는 Deque 기능을 만들지 않아서 add와 remove 안에 바로 짰습니다.
- iterator()는 구현했지만 modCount가 없어서, 순회 중에 리스트가 바뀌어도 알아채지 못합니다. JDK는 이때 ConcurrentModificationException을 던집니다.
4.ArrayList vs LinkedList
| 구분 | ArrayList | LinkedList |
| 내부 구조 | 배열 | 노드 연결 |
| get(i) | O(1) | O(n) |
| 맨 뒤 add | 평균적으로 O(1) | O(1) |
| 맨 앞 add | O(n) | O(1) |
| 메모리 | 값만 저장 (빈칸만 남음) | O(1) |
표만 보면 LinkedList가 넣고 빼기에 유리해 보이지만, 실제로는 대부분 ArrayList가 더 빠릅니다. 배열은 메모리에 붙어 있어서 CPU 캐시를 잘 타고, 노드는 메모리에 흩어져 있기 때문입니다. 그리고 LinkedList도 중간에 넣으려면 먼저 위치를 찾아야 해서 O(n)이 걸립니다.
5.마치며
평소에 쓰기만 하던 ArrayList와 LinkedList를 JDK 코드로 직접 읽어 보니, 빈 배열 상수를 두 개로 나눈 이유나 remove 후 null을 넣는 이유처럼 쓰기만 해서는 몰랐던 부분이 많았습니다. 다음 글에서는 Stack 대신 ArrayDeque를 쓰는 이유를 정리해 보겠습니다.
'Java' 카테고리의 다른 글
| Generic (0) | 2025.09.13 |
|---|---|
| GC(Garbage Collector) (0) | 2025.09.06 |
| == vs equals(), hashCode() (0) | 2025.09.06 |
| String vs StringBuilder vs StringBuffer (0) | 2025.09.05 |
| GraalVM? (0) | 2025.08.05 |


